一句话总结
距离 K3 开源已经过去三个多月,月之暗面(Moonshot AI)又掏出了 Kimi K3.1 Pro——一款 2.8 万亿总参 / 1040 亿激活的 MoE 模型,100 万 token 上下文、原生多模态,并承诺 11 月 4 日(今天)放出完整权重。在官方自测的 14 项基准里,它有 6 项第一、对 Claude Opus 5.5 胜 9/14、对 GPT-6 Astra 胜 10/14——开源模型追到与闭源旗舰「互有胜负」,是这轮最值得关注的一件事。
数据来源:月之暗面官方技术博客《Kimi K3.1 Pro: Advancing Open Intelligence》(kimi.com,2026-10-24)与官方 X 账号(2026-10-23);Artificial Analysis、latent.space、NYU Shanghai RITS 的第三方评测与报道。
这是什么:K3 的「大力出奇迹」后训练版
图源:kimi.com 官方技术博客《Kimi K3.1 Pro》页面截图(2026-11-04)
K3.1 Pro 不是从零训的新模型,而是 K3 的后训练(post-trained)版本——月之暗面 7 月开源的 K3 已经是 2.8 万亿参数的 MoE,K3.1 Pro 在这套权重上灌了「大得多的后训练算力」,用强化学习(RL)在数百个领域里滚。结果是同一套参数量,能力再往上拔一截。
规格上:2.8T 总参 / 104B 激活(MoE 稀疏激活)、100 万 token 上下文、原生多模态。同步还发了一个 K3.1 Pro Highspeed,官方称快 2–3 倍,用于需要更快响应的场景。两者现在都已上线 Kimi.com、Kimi Work、Kimi Code 和 Kimi API(platform.kimi.ai)。
最关键的一句是官方的承诺:「完整权重将在 11 月 4 日放出」——也就是今天。这是继 K3 之后,又一个 3T 级开源权重落地。
基准成绩:6 项第一,但短板也很明显
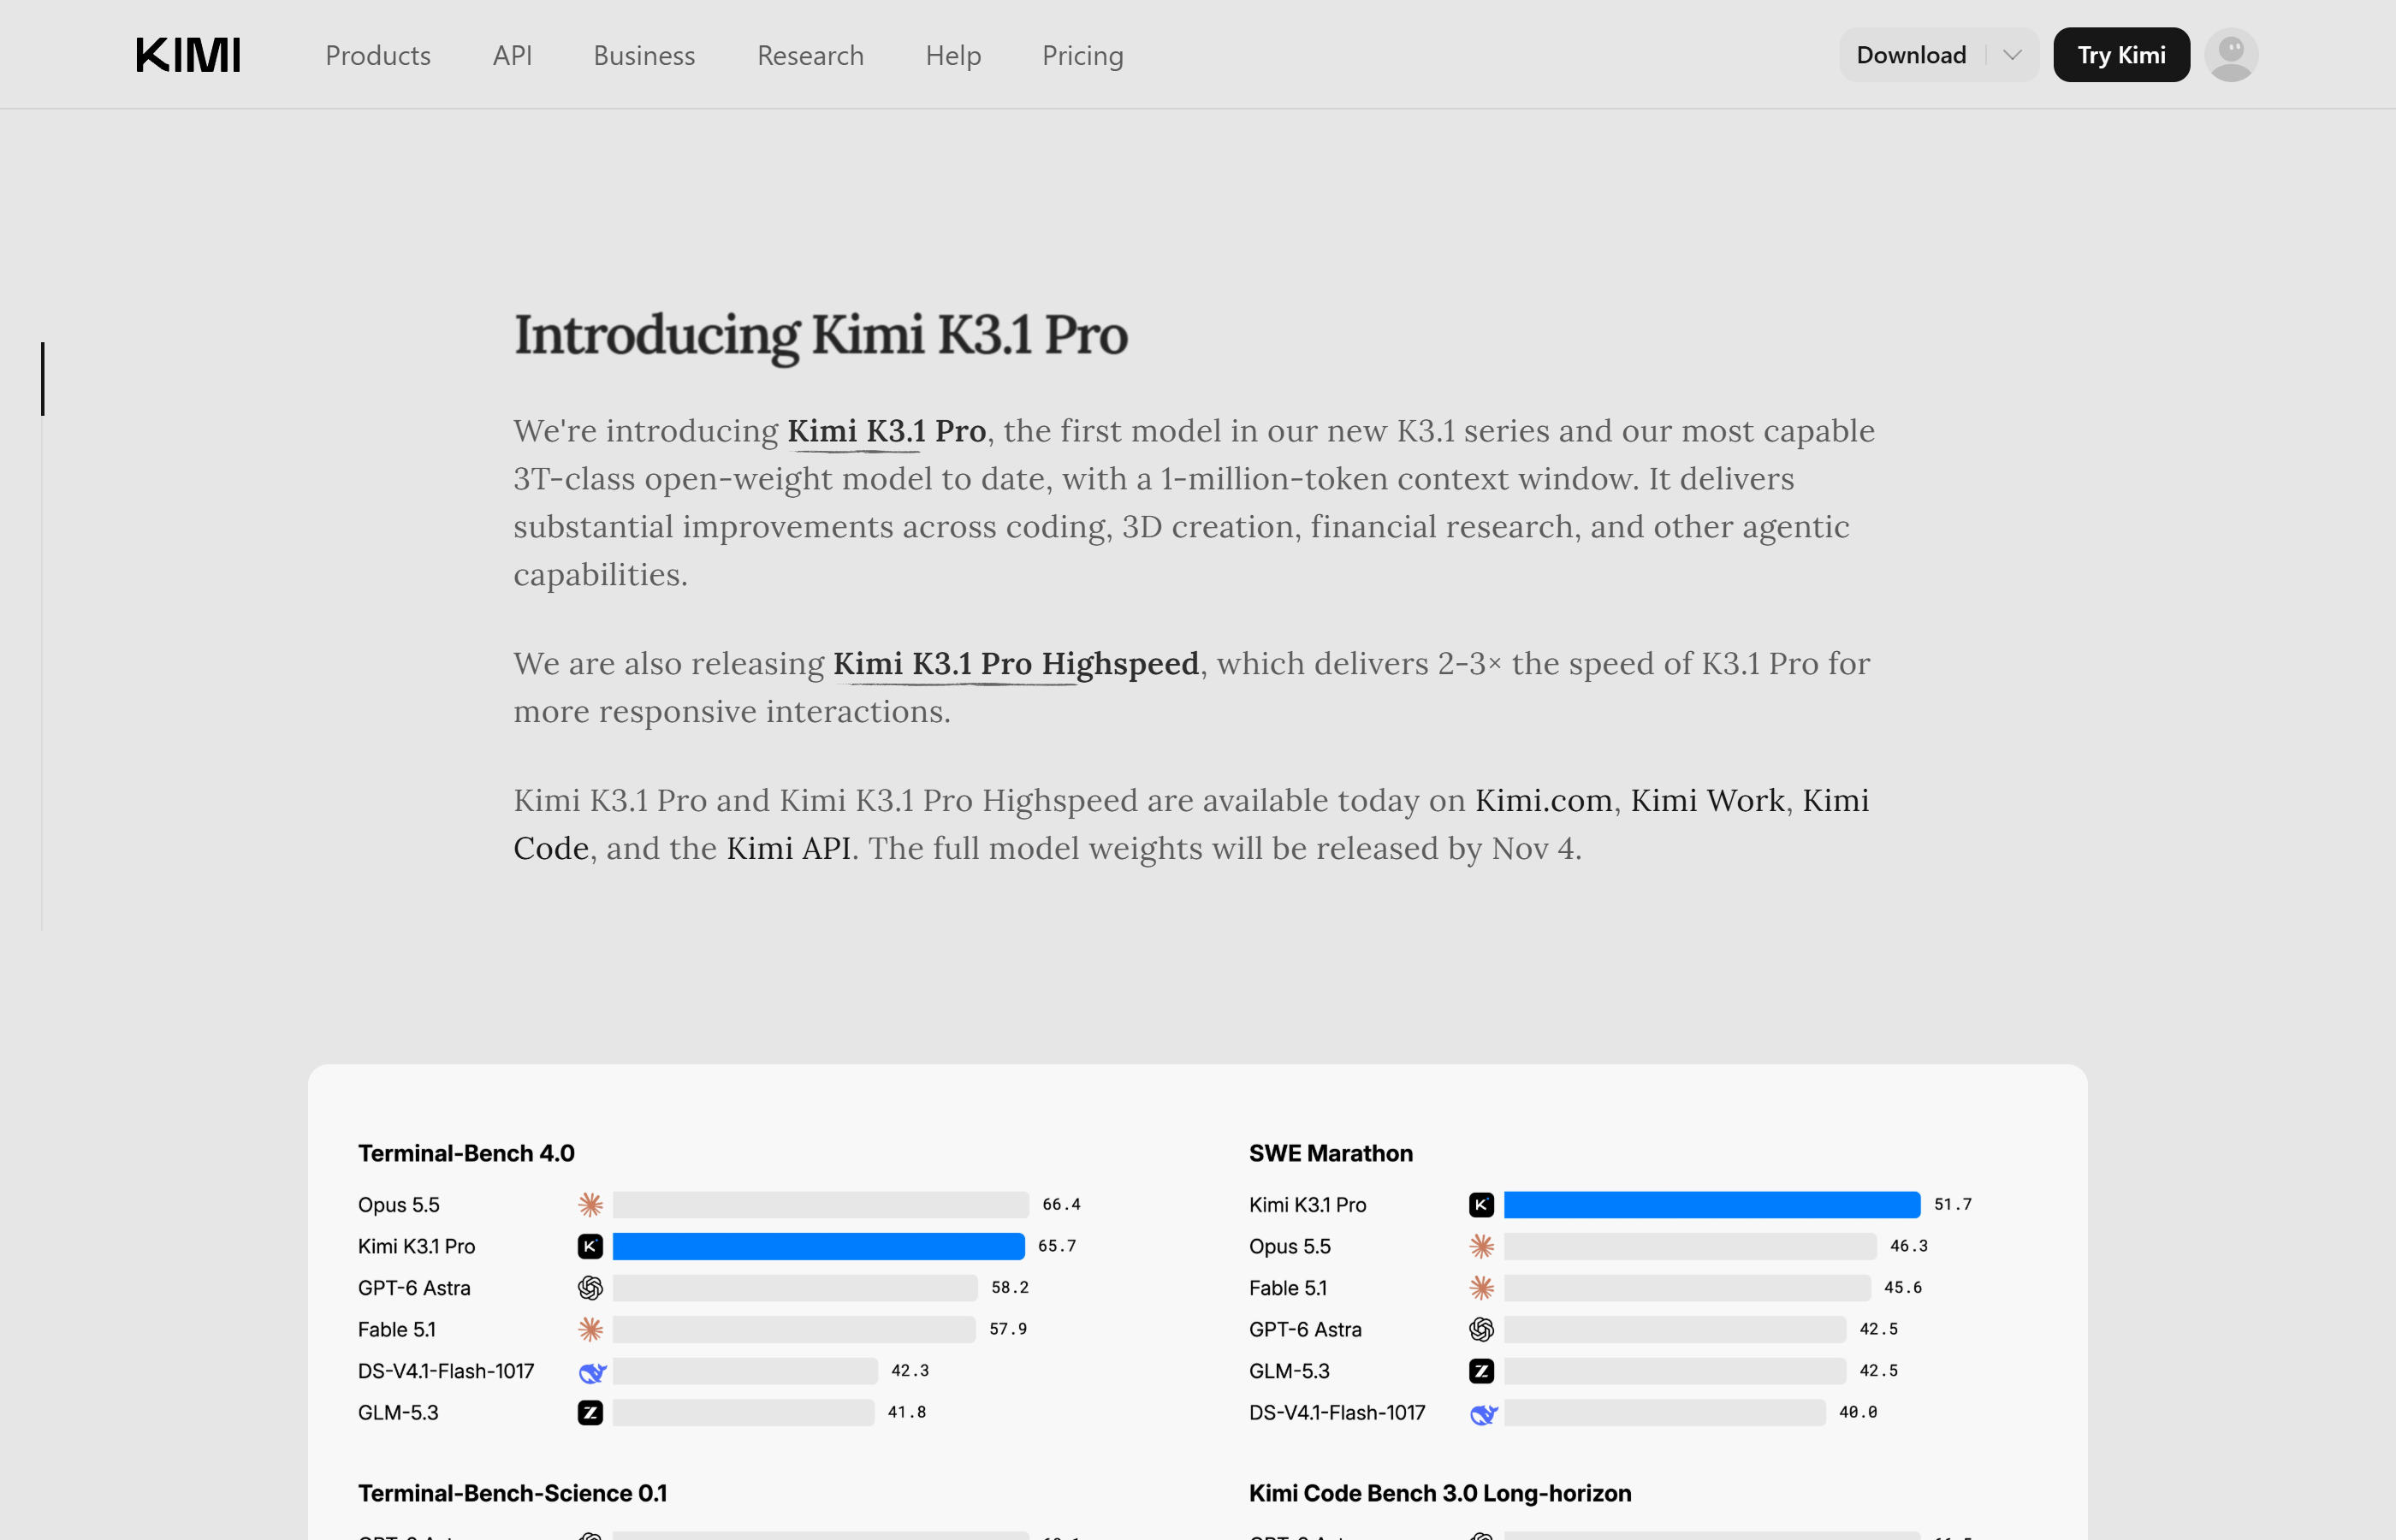
图源:kimi.com 官方技术博客《Kimi K3.1 Pro》基准测试段落截图(2026-11-04)
把官方自测图表摊开,K3.1 Pro 在 14 项基准里拿到 6 项第一(SWE Marathon 51.7、Humanity’s Last Exam 70.0、OfficeQA Pro v2 64.4、Agents’ Last Exam 43.2、ZeroBench 63.0、GDP.pdf 34.6),头对头看:
- Terminal-Bench 4.0 65.7%——高于 GPT-6 Astra 的 58.2%,仅落后 Claude Opus 5.5 的 66.4%,差 0.7 个点;
- SWE Marathon 51.7——长程软件工程任务第一,Opus 5.5 是 46.3;
- HLE(带工具)70.0——专家级问答第一,Opus 5.5 是 67.7、Astra 只有 57.2;
- OfficeQA Pro v2 64.4——真实金融文档分析第一;
- BenchCAD(带工具)92.7——逼近 Opus 5.5 的 96.2。
但短板同样醒目:Terminal-Bench Science 只有 38.1,而 GPT-6 Astra 是 68.1、Opus 5.5 是 63.3——在「科学计算」这一项上,K3.1 Pro 明显掉队,是 14 项里最弱的一环。
第三方怎么看?Artificial Analysis 把它放进智能指数(Intelligence Index)后给了 55 分、排第四,排在 Opus 5.5(58)、Sonnet 5.5(56)、Muse Wonder Full(56)之后。这个分数比官方「直逼闭源旗舰」的叙事保守一些,但对一款开源模型来说已经是历史级的位置——此前开源与闭源之间常年隔着 10 分以上的鸿沟。
金融与幻觉:两个「实用向」的提升
图源:platform.kimi.ai 首页截图(2026-11-04)
月之暗面这次明显在往「企业实用」方向打,两个数字值得单独拎出来:
- 金融能力:内部基准上,K3.1 Pro 相比 K3 在金融建模上 +7.2 分、金融研究 +11.6 分,模拟商业运营场景得分约是 K3 的 4.2 倍。官方 X 帖直接用「幻觉下降 65%」来概括金融场景的可靠性提升。
- 幻觉率:在 Kimi Hallu Bench Hard 上,声明级(claim-level)幻觉率从 K3 的 23.4% 降到 8.3%,含事实错误的回复占比降到前代的 42.4%。对金融、法律这类「错一个字就出事」的场景,这个下降比智商分更值钱。
另一个值得注意的细节来自 NYU Shanghai 的报道:月之暗面在发布前刻意移除了网络攻击相关的训练数据——从 mid-training 语料和 RL 环境里都拿掉了。这被解读成「要发一个有竞争力的开源模型,同时主动削弱其进攻性网络能力」的一次试验。开源权重一旦放出,这个「减配」到底减了多少,社区很快就能验证。
对普通用户意味着什么
- 开源权重今天落地,是真正可以下载、本地跑的 3T 级模型。 跟 K3 一样,只要硬件扛得住(2.8T 权重对显存要求很高,多数人得靠云上或量化版),就能自己部署、微调、做私有化。
- 编码与 Agent 能力已经是「咬住闭源旗舰」的水平。 Terminal-Bench、SWE Marathon 这种真实代码任务上,它和 Opus 5.5 的差距已经缩小到个位数字,对预算敏感、又想要开源可控性的团队是现实选项。
- 短板同样要心里有数。 科学计算(Terminal-Bench Science)明显弱,说明它不是「全科满分」,选型时得看自己到底跑什么任务。
- 国内用户上手成本最低。 Kimi 本身就是国内可直接用的产品,K3.1 Pro 已上线 Kimi 家族和 API 平台,无需代理、无需海外账号即可体验——这是它相对海外开源模型最实在的优势。
图片出处:封面由 UU AI Hub 自制;正文三张配图分别为 kimi.com 官方技术博客页面截图、platform.kimi.ai 首页截图(均于 2026-11-04 获取)。