一句话总结
10 月 5 日,纽约的 Reflection AI 放出自己的第一个模型 Beam:501B 总参数、23B 激活的稀疏 MoE,Apache 2.0、权重本月晚些才发布。这家 2024 年 3 月由前 DeepMind 研究员创办、英伟达投资的公司在公告里写得很直白——Beam 的目标不是「最强」,而是在和 GLM-5.2 同一档能力上,把推理算力压到对方的 1/3 至 1/4。这是西方开源权重第一次以「正面回应中国开源」的姿态出现,也因此值得逐个数字核对一遍。
数据来源:Reflection AI 官方博客《Introducing Beam: Reflection’s 501B open-weight model》(2026-10-05)、Fortune / TechCrunch / implicator.ai 同日报道(2026-10-05)。
发布的是什么:501B 的稀疏 MoE,权重还要等
Beam 是一个为编程、推理与 Agent 任务训练的稀疏 MoE 模型:501B 总参数、23B 激活。官方给的两条训练线索是:
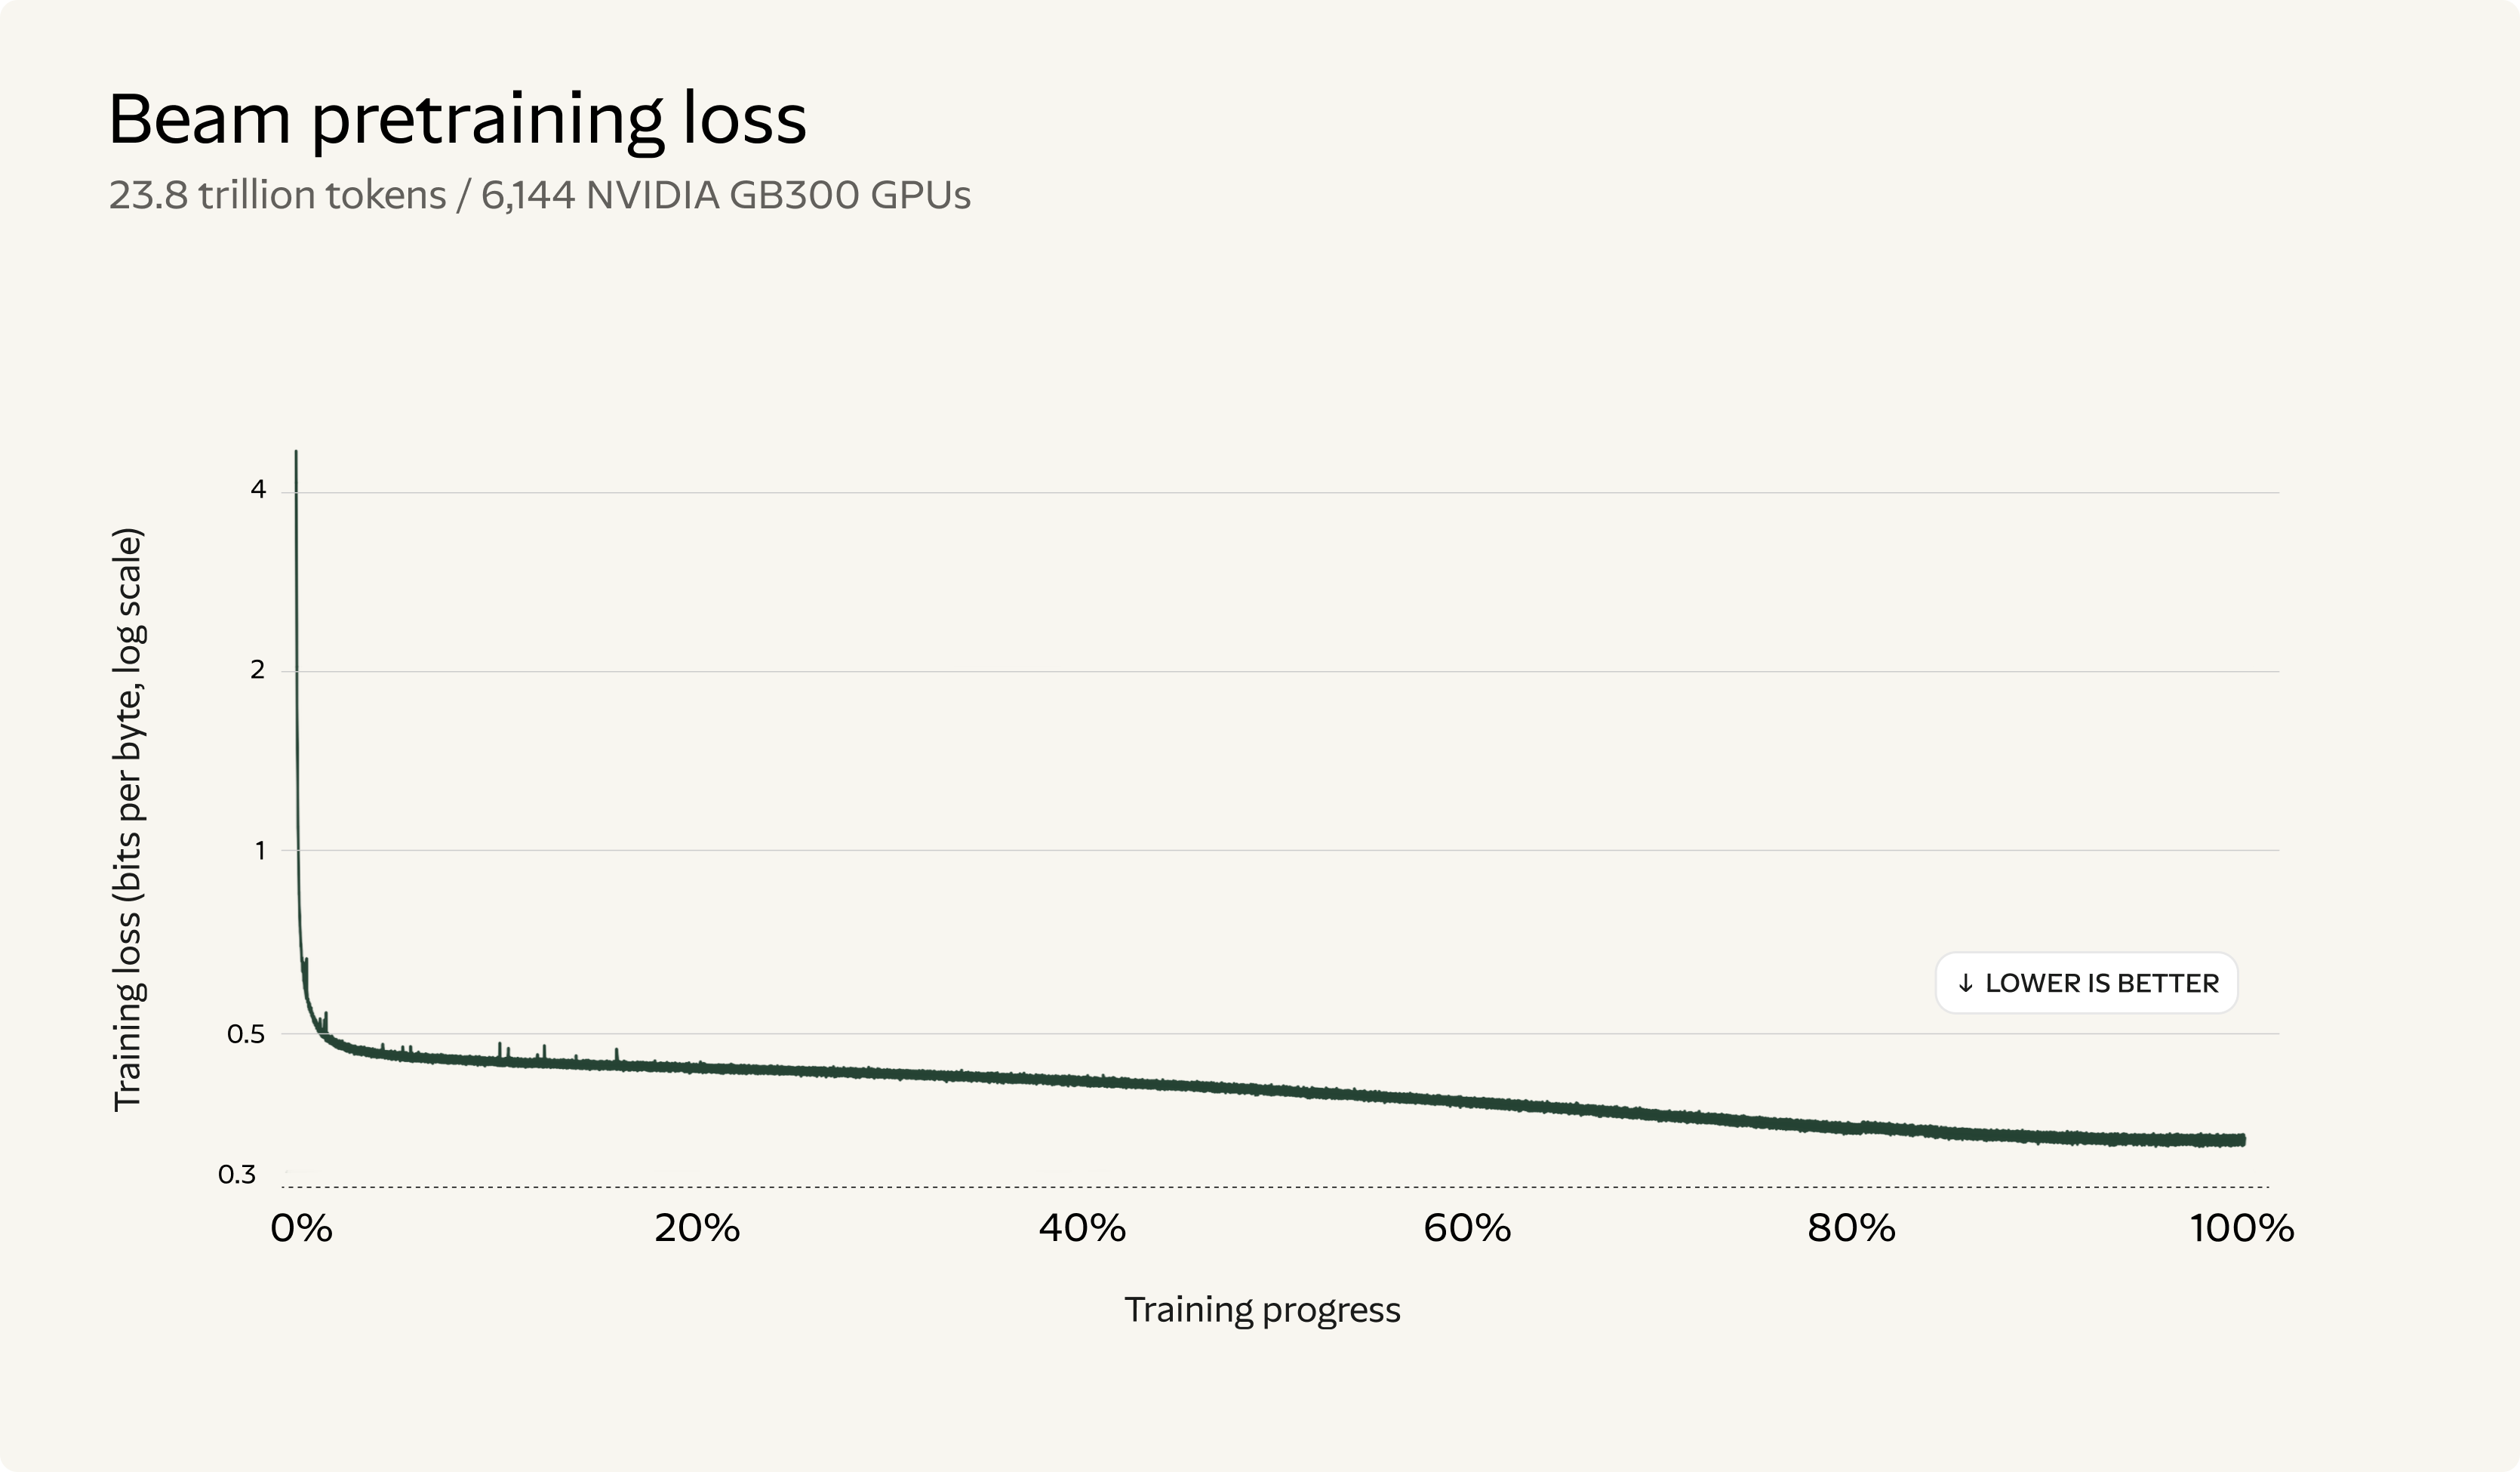
- 预训练:23.8 万亿 token 的网页与「专有授权数据集」;
- 强化学习:一次高算力 RL 运行产生了超过 1 亿次 rollout,跑在 10.5K 张 NVIDIA GB300 上、历时 4 周,训练期间平均维持约 11 万个并发 rollout。
为了让这个规模跑得起来,Reflection 自建了一套异步 RL 平台:Agent 生成 rollout 与训练器更新权重解耦,每个 token 都带上「产生它的模型版本」标记,训练算法据此补偿策略陈旧度;环境池接近 100 万个,主要靠合成数据管线生成,再按难度与质量反复筛选。官方还提到一个细节——数据质量的妥协会让能力早早触顶,整条训练曲线结束时没有出现饱和迹象。
需要先记住的前提是:权重还没发。目前只有候补名单的早期访问,模型仍在最后阶段的红队与评测里;权重、技术报告、模型卡与开发者物料官方口径是「本月晚些时候」放出,许可证为 Apache 2.0。也就是说,下面所有分数都是自报口径,第三方要等 checkpoint 落地才能复测。
官方自报的位置:追平 GLM-5.2,落后 Kimi K3
Beam 公告里最诚实的一段话值得原文引用:
Beam advances the Western open-weight frontier and is competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks. Where frontier open models like Kimi K3 remain ahead on raw capability, Beam’s advantage is efficiency at inference time.
翻过来就是:能力上对标 GLM-5.2、接近 Qwen 3.8-Max,但 Kimi K3 这类前沿开源模型在原始能力上仍然领先,Beam 的牌是推理效率。官方给出的一整张对比表(含 Inkling、Nemotron 3 Ultra、GLM-5.2 / 5.3、Kimi K3、Qwen 3.8 Max、DeepSeek V4.1 Flash)里,几行关键数字如下:
| 基准 | Beam | GLM-5.3 | Kimi K3 | DeepSeek V4.1 Flash |
|---|---|---|---|---|
| Terminal Bench v2.1 | 80.1 | 88.2 | 88.3 | 90.6 |
| DeepSWE v1.1 | 44.4 | 61.0 | 68.0 | 74.2 |
| HLE(无工具) | 36.2 | 42.3 | 46.9 | 39.1 |
| SciCode | 49.7 | 59.0 | 58.7 | 52.0 |
| GPQA Diamond | 90.5 | 91.7 | 93.5 | 90.9 |
| SWE-Bench Verified | 80.9 | — | — | — |
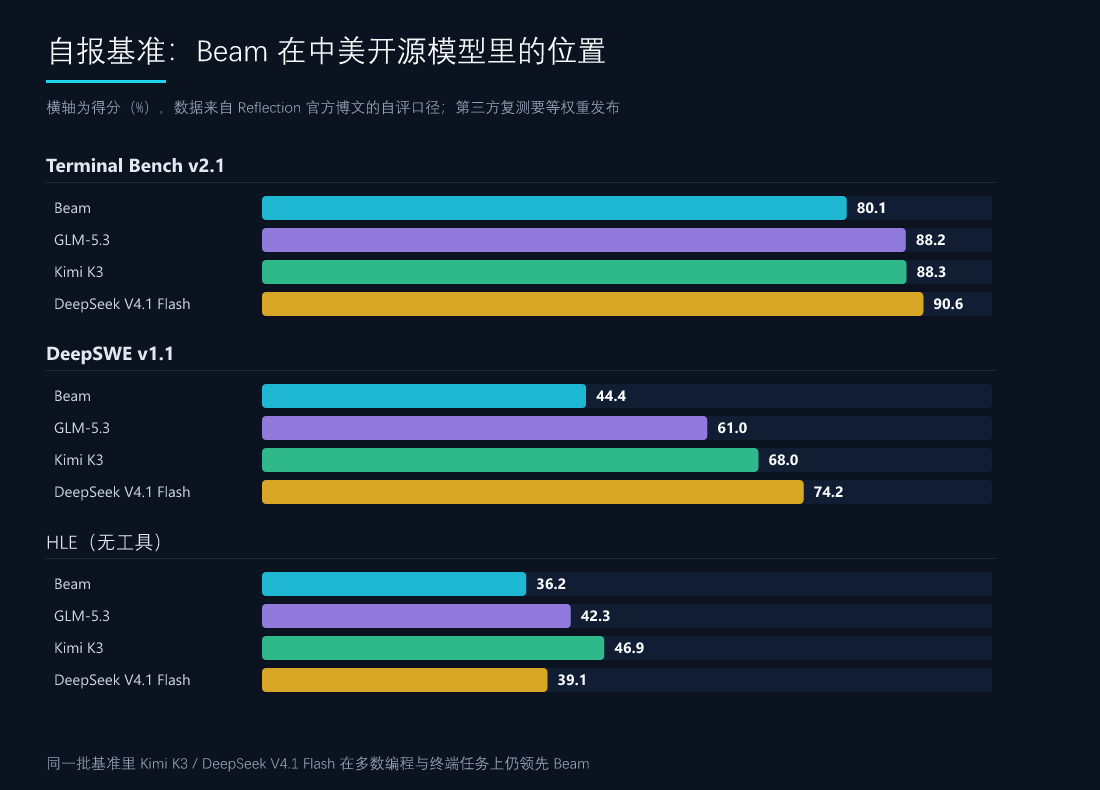
少数几行 Beam 拿得出手:MCP Atlas 78.7(对 GLM-5.2 的 77.8)、AutomationBench public 37.0(对 26.2)、AIME 2026 97.8(对 Inkling 97.1)。反过来,在编程与终端这类最吃 Agent 落地价值的行上,Beam 与 Kimi K3、DeepSeek V4.1 Flash 的差距是两位数——官方没有回避这个差距,而是把它当成「效率换能力」的定价依据。
效率牌怎么打:用训练侧的算力换推理侧的便宜
媒体转述 Reflection 的说法是:Beam 在编程与 Agent 任务上,按 token 成本与推理耗时衡量,比西方同类开源模型高效 3 至 4 倍;Artificial Analysis 拿到早期访问后表示「初步迹象显示 Beam 会是同智力水平里最省 token 的开源模型之一」。注意「3 至 4 倍」官方自己标注的是近似估算,不是实测成本报告。
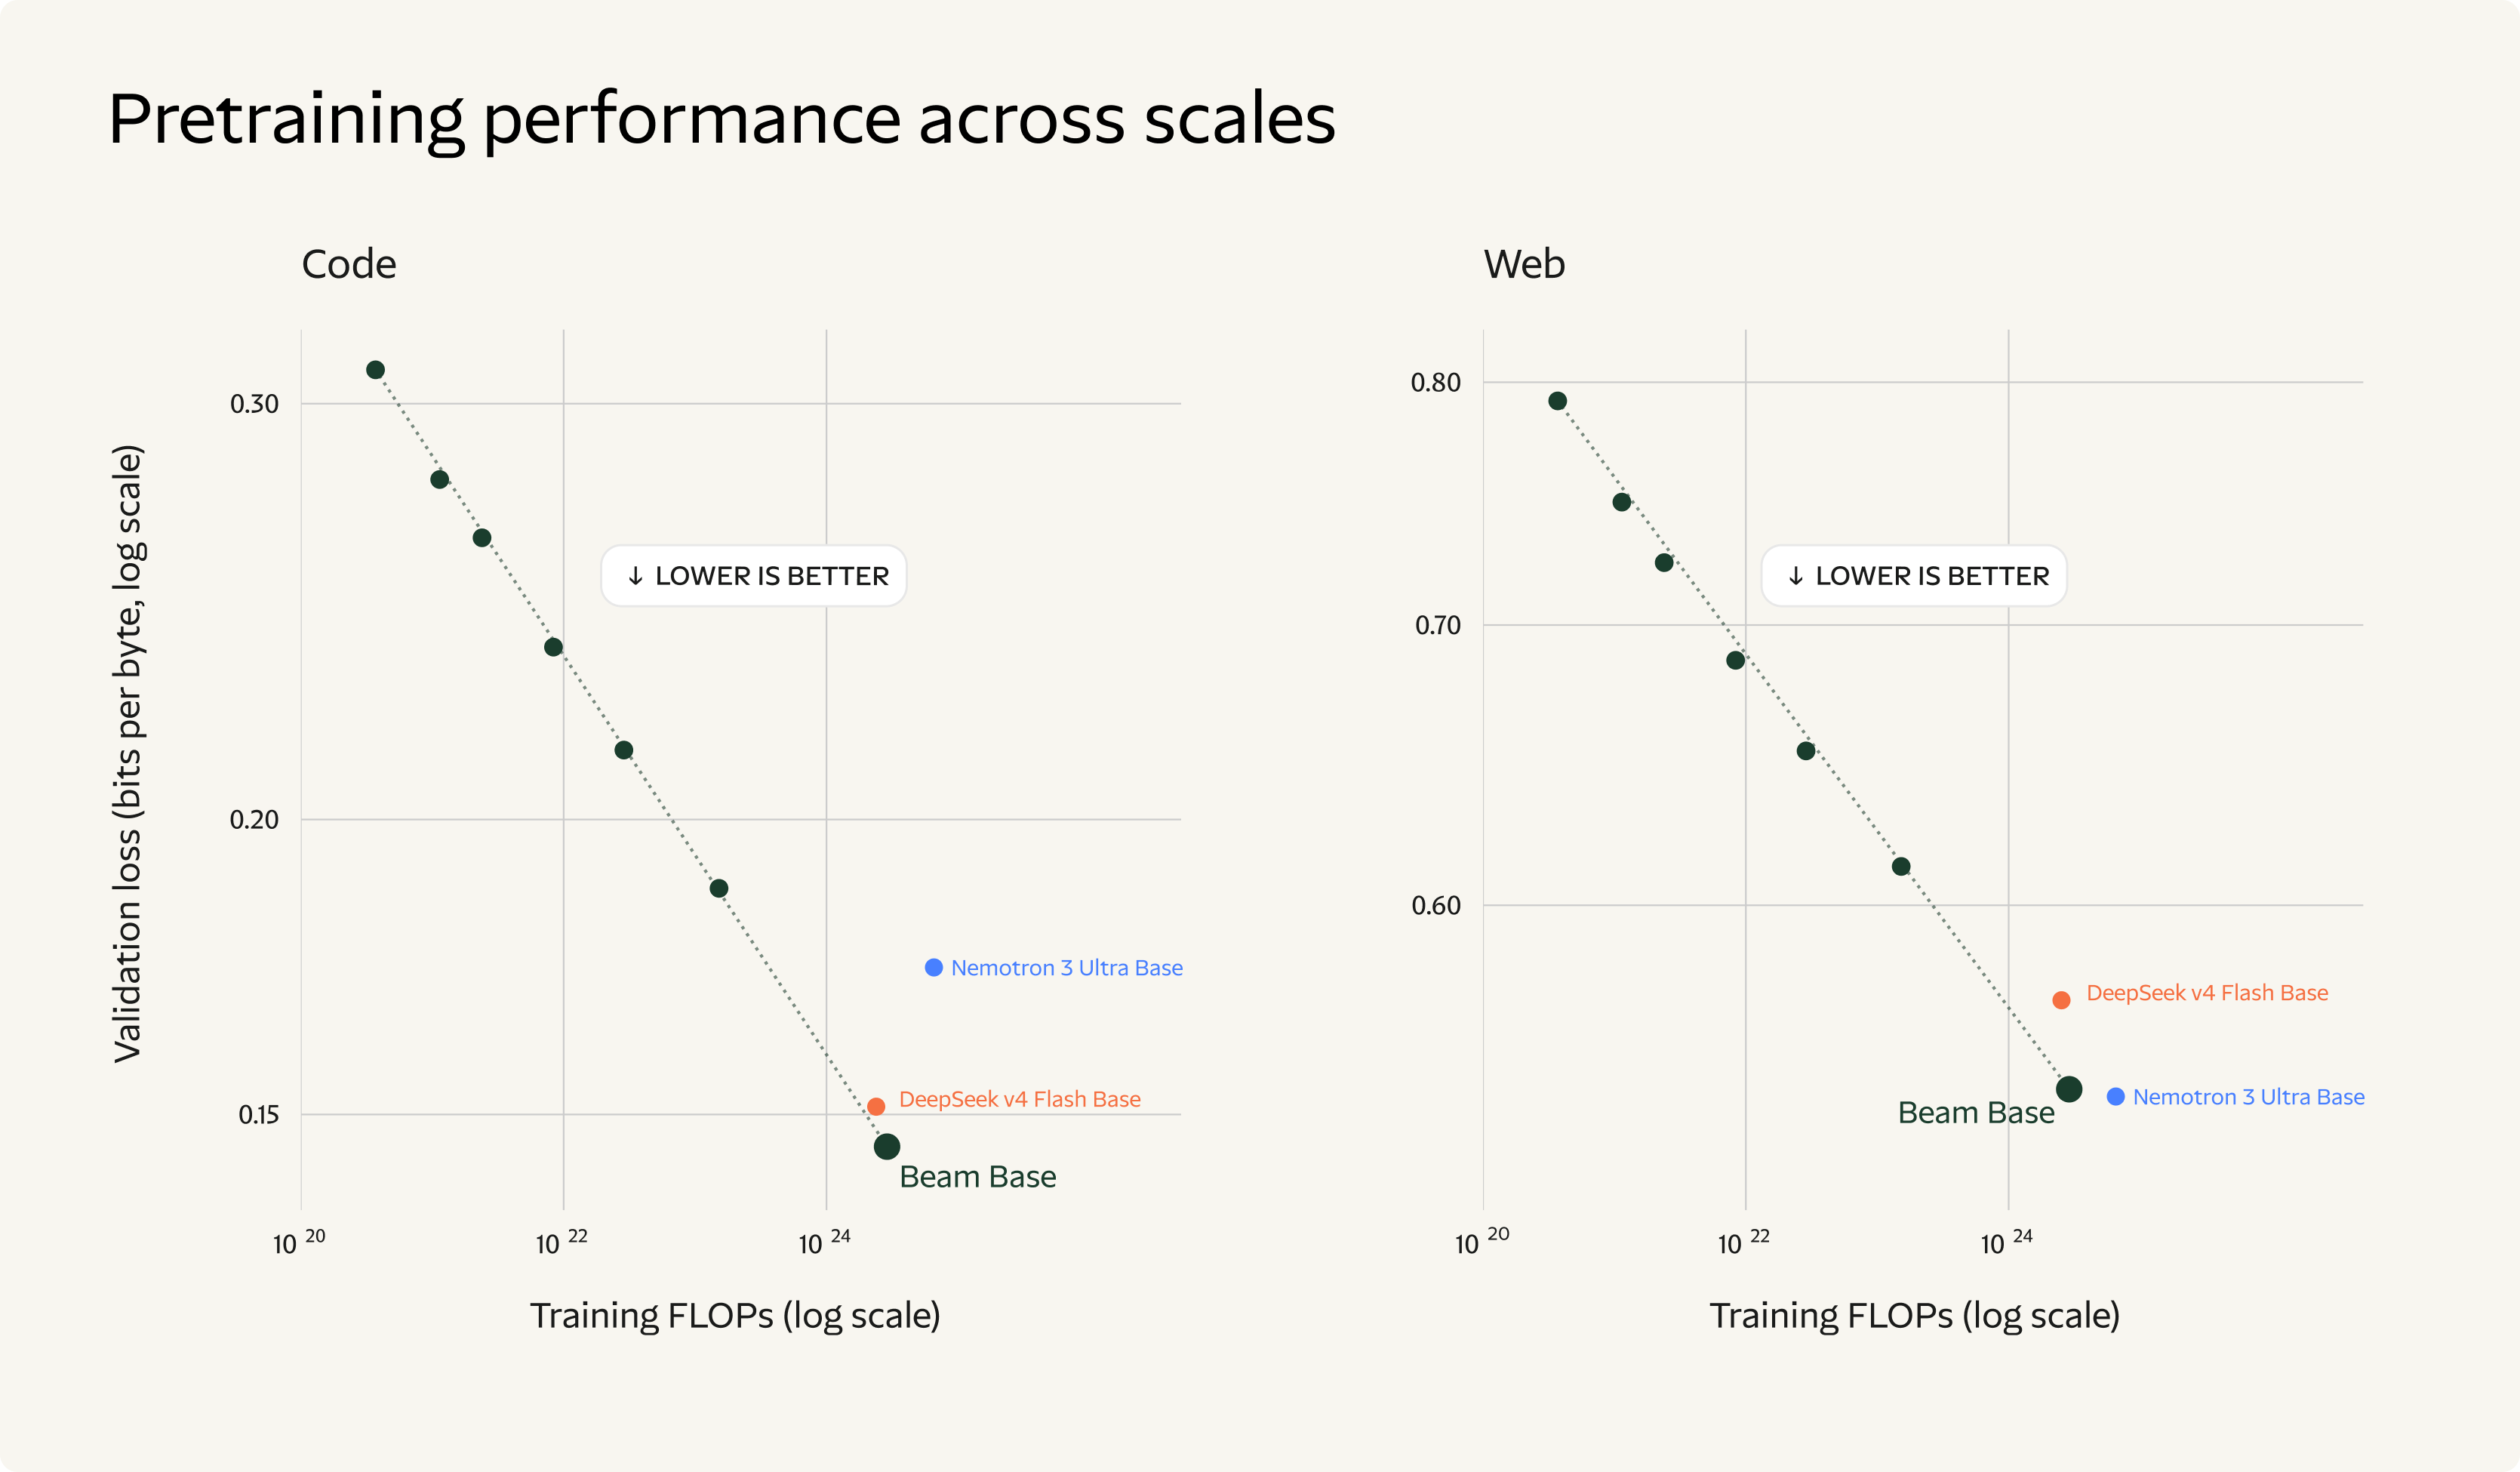
工程侧有两张官方曲线可以佐证这条路线:
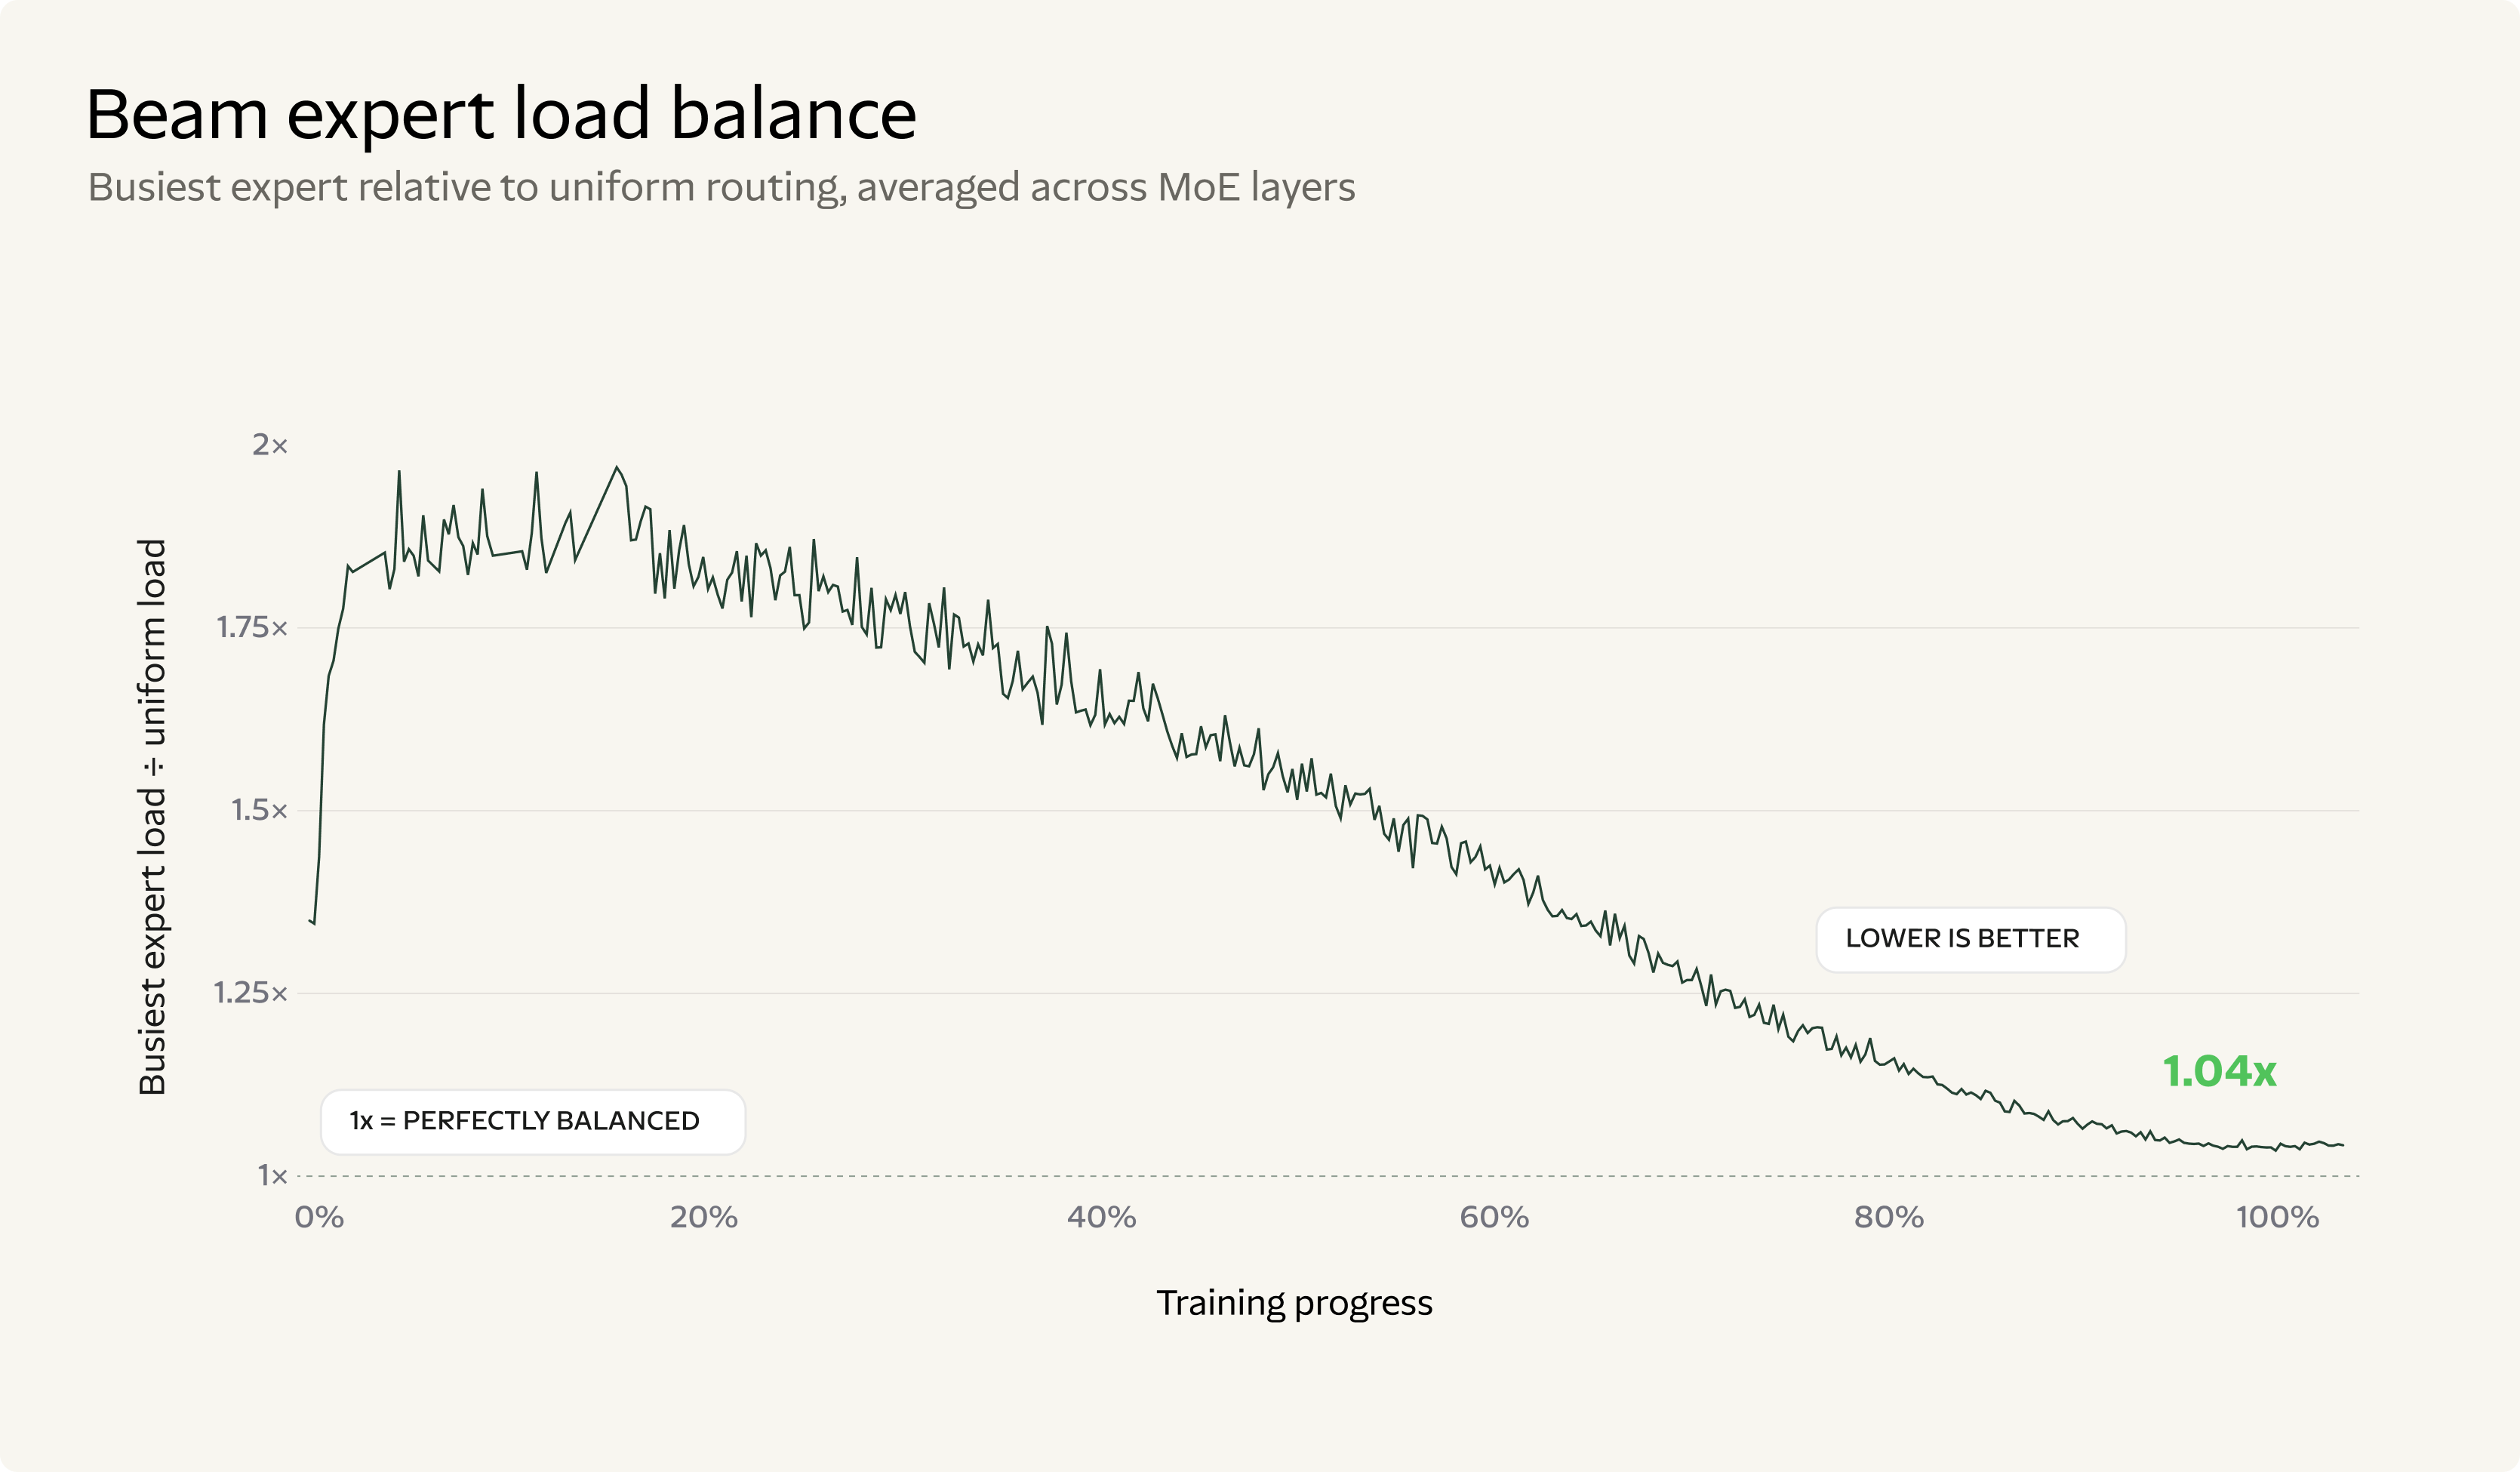
一张是专家负载均衡——训练结束时最忙的专家相对均匀路由只有 1.04 倍,MoE 没有出现「少数专家吃满、其余闲置」的常见退化;另一张是预训练扩展曲线:在 Code 与 Web 两个验证集上,Beam 的 base 模型以更低的训练 FLOPs 落在 DeepSeek v4 Flash Base 与 Nemotron 3 Ultra Base 之后(loss 越低越好)。
官方还展示了一条泛化侧的旁证:在只含推理、软件工程与终端任务的 RL 阶段,Beam 在没有浏览任务的混合数据里也持续涨了浏览能力;联网后它自发学会去搜索并调用其他大模型、用 OCR API 读文档。另一个病毒式测试是「陆海地图」题(180×90 网格、16,200 个坐标点),Beam 拿到 95.5% 的覆盖率,官方把这个分数放在 Opus 5 的 92.5% 与 Fable 5 的 97.8% 之间。
三个该打问号的地方
- 全部是自报口径。 榜单来自 Reflection 自己的评测台,技术报告尚未发布;人工分析机构给的只是「早期迹象」,无法在其智力指数上定位。
- 自家表里也有大片空白。 SWE-Bench Verified 等行只列了 Beam、Inkling、Nemotron 3 Ultra 三家,对比模型标成「NR」(未报告)——空白不等于领先,这类行不能拿来做结论。
- 效率主张还没被独立验证。 「3 至 4 倍」覆盖 DeepSWE、HLE、Terminal Bench 2.1 三组任务,官方称是近似而非实测;真正的成本账要等权重发布后在同一批硬件上跑出来。
为什么这件事值得记一笔
放在更大的盘面上,Reflection 的叙事有明确对手:目前开源模型市场里,中国模型拿走了超过 30% 的 token 份额,Kimi K3、DeepSeek V4 系列、GLM 系列是这份成绩单的主角。西方阵营此前在开源权重上的投入要零散得多,Beam 是第一个由「前沿实验室建制」做出来的西方开源权重模型,公司也在 5 月宣布向美国能源部等公共部门供货,定位写的是企业、公共部门与开发者的「workhorse」。
它选择的路线也很有代表性:不去追总参数,而是把算力砸在高算力 RL 换推理效率上——同一档智力水平,谁的每 token 成本更低,谁就更容易在 Agent 这类高频调用场景里被选中。对这个赛道来说,这比多拿几个榜单第一更接近生意本身。
总结
- 是什么:Reflection AI 的首个开源权重模型 Beam,501B 总参 / 23B 激活的稀疏 MoE,Apache 2.0,权重本月晚些发布,当前只有候补名单早期访问。
- 训练规模:23.8T token 预训练;RL 侧超过 1 亿次 rollout、10.5K 张 GB300、4 周,平均 11 万并发 rollout。
- 能力位置:官方口径接近 GLM-5.2、逼近 Qwen 3.8-Max,但在多数编程与终端基准上落后 Kimi K3、DeepSeek V4.1 Flash;效率(每 token 成本 / 推理耗时)是其主卖点,宣称优于西方同类开源模型 3 至 4 倍。
- 可信度边界:分数自报、技术报告未发、效率主张是近似估算——等权重落地再复测。
- 值得关注的理由:西方第一次用「前沿实验室建制 + 开源权重 + 效率路线」正面回应中国开源模型的市场份额。
图片出处:封面、基准对比图由 UU AI Hub 自制;预训练损失曲线、专家负载均衡曲线、预训练扩展曲线、陆海地图泛化实验输出均取自 Reflection AI 官方博客《Introducing Beam》原文配图。
数据来源:Reflection AI 官方博客与官方对比表(2026-10-05);Fortune、TechCrunch、implicator.ai、gate.com 同日报道与拆解(2026-10-05);Artificial Analysis 公开表态(2026-10-05)。