一句话总结
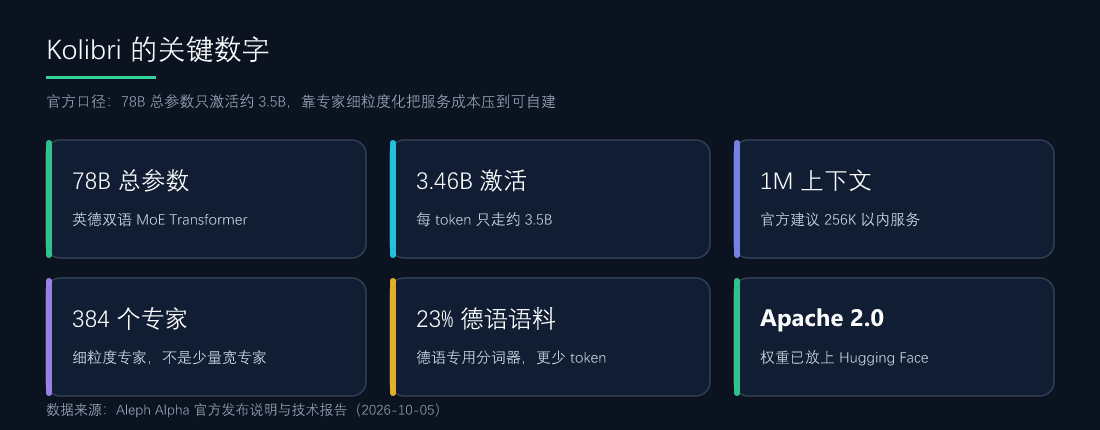
10 月 3 日,德国海德堡的 Aleph Alpha 在德国统一日放出 Kolibri:英德双语 MoE,78B 总参数每 token 只激活约 3.46B,支持 1M 上下文,权重已经在 Hugging Face 上按 Apache 2.0 完全开放。它没有去争「最强开源模型」,而是明确站在另一个坐标上——面向公共管理、工业与国防的关键任务,把「主权」和「合规」当成产品本身来交付。
数据来源:Aleph Alpha 官方新闻稿《Aleph Alpha releases Kolibri》(海德堡,2026-10-05)、官方博客《Kolibri Has Landed: A Sovereign Open-Weight Model》(2026-10-03)、官方技术报告与模型卡。
发布的是什么:78B / 3.46B,英德双语,Apache 2.0
Kolibri(德语「蜂鸟」)是一个英文-德文 MoE Transformer:
- 参数:78B 总参数、每 token 约 3.46B 激活(官方新闻稿写作「约 3B」);
- 上下文:最长 1M token,官方建议复杂任务服务时控制在 256K 以内;
- 许可:Apache 2.0,权重可直接下载、可跑在自己的硬件上。
取舍过程官方写得很具体:他们先做了 Kolibri Origin(30B 总参、3B 激活、65K 上下文)来验证整条流水线,再放大。实验中从 32B 一路加到 123B 时能力确实继续涨,但服务成本涨得更快——123B 在两块 H100 上只能同时处理 3 个 256K 长上下文请求,78B 能并发 18 个、解码还快 28%。于是停在 78B,并用 384 个小专家而不是少量宽专家来撑起容量。这个决定的含义是:模型不是给排行榜用的,是给「要自己买卡、自己上线」的客户用的。
为什么是德语:23% 语料 + 德语专用分词器
Kolibri 的差异化不从参数来,而从语言来。官方新闻稿给出的几条:
- 德文文本约占其预训练数据的 23%,模型被训练成「用德语推理」;
- 分词器针对德语优化,同一段德语文本能压成更少的 token,直接省的是推理成本;
- 联合创始人 Samuel Weinbach 的说法是:分词器和「用德语思考」都是围绕德语应用的日常需求设计的。
AI 圈的一个默认假设是「英文够强,其他语言自然溢出」。Kolibri 反着做:先承认欧洲客户的真实工作流是德语的,再把预算砸进去。对处理德语公文、德语技术文档与德语客服的团队来说,这项收益比榜单排名实在得多。
「主权」是两个维度,不是一句口号
Aleph Alpha 对「主权」的定义值得单独拎出来,因为它把一个政治词拆成了两条可验证的工程清单:
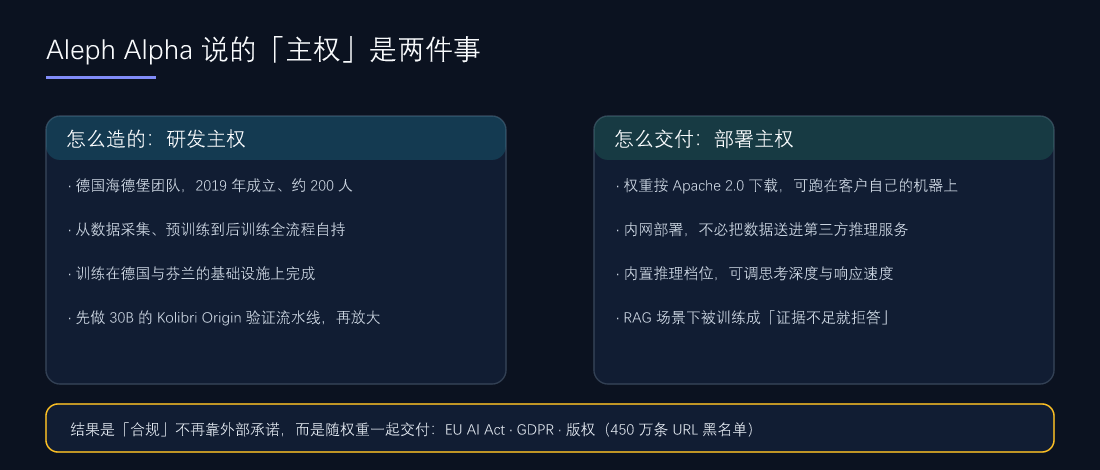
研发主权指模型是怎么造出来的:团队在德国海德堡(2019 年成立、约 200 人),从数据采集、清洗、预训练到后训练全流程自持,训练在德国与芬兰的基础设施上完成。部署主权指模型怎么交到客户手里:权重可下载、可内网部署,不必把内部数据送进第三方推理服务;模型内置推理档位,能让用户自己调「思考深度 vs 响应速度」的平衡;在 RAG 场景下被专门训练成证据不足时拒答,而不是硬编一个看起来完整的答案。
这两条合起来才是他们说的「合规不再靠外部承诺,而是随权重一起交付」——客户拿到的是可以直接审计的东西,而不是一纸 SLA。
合规被写进训练数据治理
技术报告里公布的治理措施比宣传语更硬:全部训练数据对照一份超过 450 万条 URL 的黑名单做过筛查(来源包括欧盟委员会的盗版观察名单 Piracy Watch List);每一份第三方数据在使用前都要评估许可证条款、来源合法性以及是否尊重 opt-out 声明。官方强调这是一套留存记录、可复盘每个决策的流程,覆盖数据采集、预训练、后训练到最终评测。
对需要过审、要写 AI 治理文档的欧洲政企采购来说,这些记录本身就是交付物的一部分。对照检查一下:多数开源权重模型的发布公告里,这一栏是空的。
自报基准:赢在一部分,输在一部分
Aleph Alpha 用的是自家的评测台,对手选了 Alibaba 的 Qwen3.6-35B-A3B、Nvidia 的 Nemotron 3 Super 120B-A12B 和法国 Mistral Small 4 119B-A6B。在这个场里 Kolibri 的表现是:
| 基准 | Kolibri | 说明 |
|---|---|---|
| AIME 2025 / 2026(数学) | 96.9 / 96.0 | 领先对比组 |
| GPQA Diamond(知识) | 84.3 | 领先对比组 |
| LiveCodeBench(代码) | 85.9 | 领先对比组 |
| τ²-bench telecom、BFCL(工具调用) | — | 落后于 Qwen3.6-35B-A3B |
也就是说:数学、知识、代码这类静态基准上 Kolibri 站得住,工具调用与部分 Agent 场景上不如更小的 Qwen3.6。官方对这套公开基准本身的态度也写在公告里——他们认为公开榜单反映不了客户的真实需求,所以另外自建了面向公共管理、汽车零部件、航空航天等行业的测试集,其中航空航天一项从前代提升明显。这类自建行业基准没有第三方复现,参考时要把口径一起看。
另一个必须说的缺口:Kolibri 还没上 Artificial Analysis,目前没有独立的智力指数排名。按对比模型的分数(Qwen3.6-35B-A3B 18 分、Nemotron 3 Super 13 分、Mistral Small 4 11 分)推算,量级大约在 15 至 20 分之间——这只是估算,不是实测。硬件门槛方面,第三方实测口径是 FP8 权重、至少两块 A100 80GB 或 H100,实际显存占用约 140GB 量级。
更大的背景:一家德国公司和一次跨大西洋合并
Kolibri 发布的时间点,和 Aleph Alpha 自身的一次大变动叠在一起:
- 9 月 16 日与 24 日,Cohere 与 Aleph Alpha 先后宣布签署合并协议,目标是成为「第一家跨大西洋的主权 AI 公司」,交易仍需监管批准;
- 官方同时说明,在交割完成前 Aleph Alpha 继续独立运营——Kolibri 是独立状态下放出的最后一个大动作之一;
- 9 月 28 日,公司宣布 Reto Spörri 离任,Ilhan Scheer 继续担任 CEO。
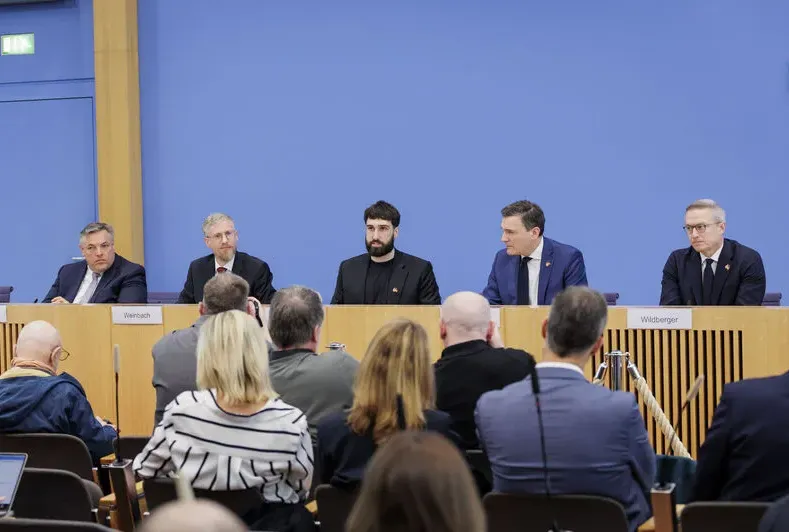
把这三件事放在一起看,Kolibri 的角色有两层:它既是面向客户的产品,也是合并前的一次技术验证——78B 量级的模型可以在德国与芬兰的自建基础设施上、由自己的团队从零训出来。欧洲的另一张牌是法国的 Mistral,它走的是通用能力路线;Aleph Alpha 走的则是「专门语言 + 专门行业 + 合规交付」的窄而深路线。两条路都在回答同一个问题:在美国闭源 API 与中国开源权重之间,欧洲的采购方能不能有第三个选项。
总结
- 是什么:Aleph Alpha 的英德双语 MoE 模型 Kolibri,78B 总参 / 约 3.46B 激活 / 1M 上下文,Apache 2.0,权重已在 Hugging Face,10 月 3 日(德国统一日)发布。
- 参数取舍:停在小规模是因为 123B 在两块 H100 上只能并发 3 个 256K 请求,78B 能并发 18 个且解码快 28%;384 个小专家替代少量宽专家。
- 差异化:23% 德语预训练语料 + 德语优化分词器 + 用德语推理,面向公共管理、工业、航空航天等关键任务。
- 合规即产品:450 万条 URL 黑名单、逐份第三方数据集评估许可证与 opt-out,EU AI Act / GDPR / 版权要求的处理措施写进技术报告。
- 可信度边界:基准为自报口径,工具调用与部分 Agent 场景落后 Qwen3.6-35B-A3B,尚未进入 Artificial Analysis(估算 15–20 分);行业内基准没有第三方复现。
- 背景:Cohere 与 Aleph Alpha 已签合并协议(待监管批准),交割前独立运营;CEO 于 9 月 28 日交接。
图片出处:封面、「主权的两个维度」示意图由 UU AI Hub 自制;Kolibri 官方发布视觉、柏林联邦新闻发布会现场照片与规格数据取自 Aleph Alpha 官方新闻稿、官方新闻页与官方博客原文。
数据来源:Aleph Alpha 官方新闻稿(海德堡,2026-10-05)与官方博客《Kolibri Has Landed: A Sovereign Open-Weight Model》(2026-10-03)、官方技术报告;Aleph Alpha 官方 X 账号发布帖(2026-10-03);Trending Topics 对官方基准的第三方梳理、tej.as 与 MindStudio 对模型卡与硬件需求的技术拆解(2026-10-03/04)。