一句话总结
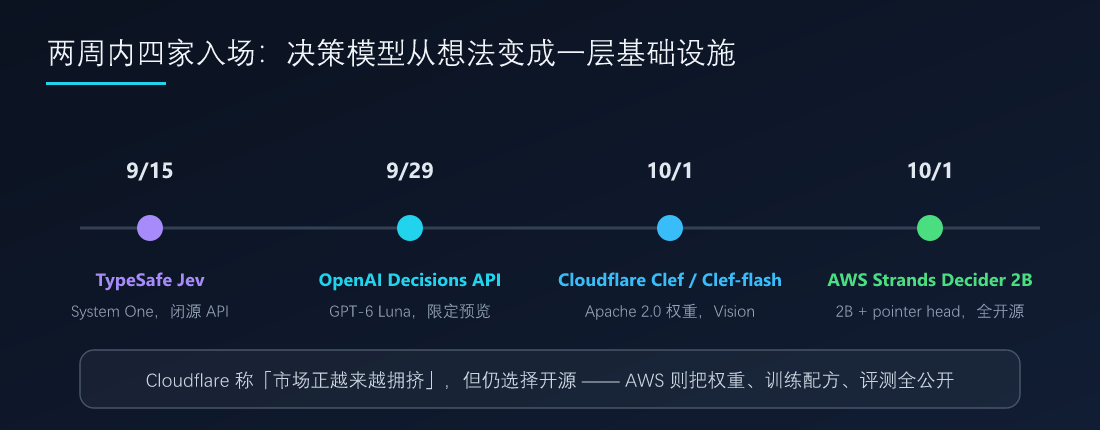
过去两周,一条新赛道以肉眼可见的速度从「一家公司的想法」变成「一层基础设施」:9 月 15 日 TypeSafe 拿出 Jev,9 月 29 日 OpenAI 在 DevDay 顺带丢出 Decisions API,10 月 1 日 Cloudflare 开源 Clef / Clef-flash、AWS 发布 Strands Decider 2B。它们的共同点是不生成文本 —— 你给它输入和一组预设选项,它返回「选哪个」和「有多确定」。这类模型把 Agent 工作流里最频繁、却最不需要「智能」的那部分(路由、工具选择、审批、护栏)从大语言模型里拆了出来;而这次两家大厂入场的方式很不一样:Cloudflare 给权重,AWS 连训练配方、数据来源、评测台一起给。
数据来源:Cloudflare 官方博客《Introducing Clef: our open-source decision models, and new RL fine-tuning platform》(2026-10-01);TechCrunch《Amazon releases its own Jev clone as decision models flood the web》(2026-10-01);SiliconANGLE、The Outpost、CryptoBriefing 对 Strands Decider 2B 的报道;Flavio Copes 的 Clef 深度拆解;TypeSafe Jev 官方发布页与 Jev Decision Index 基准。
先讲清楚:什么叫「决策模型」
要理解为什么一堆公司同时在发这个,得先把它和「让 LLM 输出 JSON」区分开。
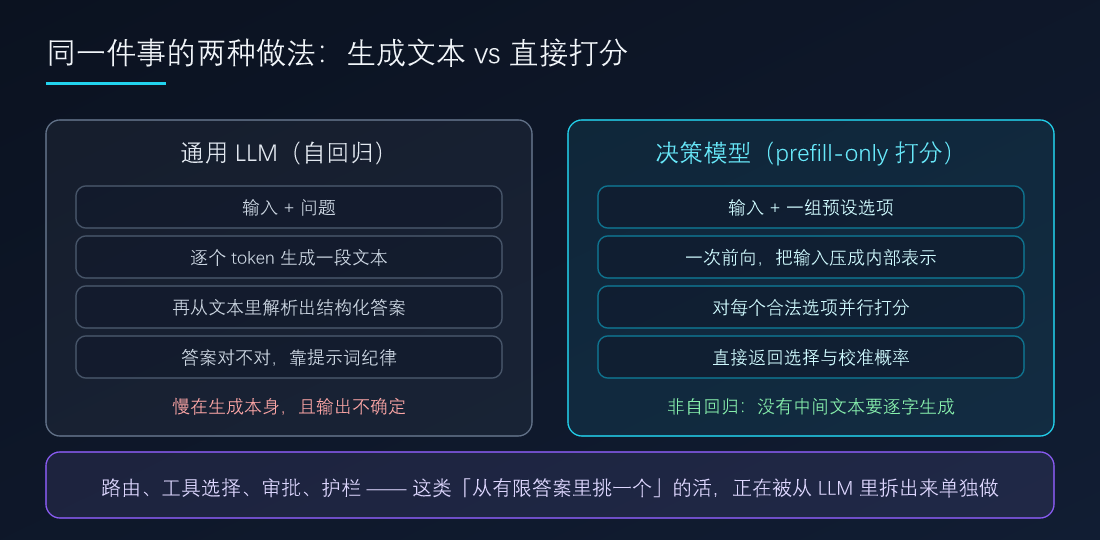
传统做法是:把输入和问题塞给一个通用 LLM,让它逐个 token 生成一段文本,再从这段文本里把结构化答案解析出来。慢的那一环恰恰是生成本身 —— 你并不需要它写作文,但它必须先写出来才能给你一个「是/否」。
决策模型换了个做法:一次前向(prefill-only)把输入压成内部表示,然后对每一个「合法选项」并行打分,直接返回选择与概率。中间没有文本要逐字生成(非自回归),所以同一件事能做得更快、更便宜,而且输出天然被约束在你给的选项集合里。
Cloudflare 在官方博客里把这件事讲得很清楚:给一个客服消息(输入),问它是否紧急、该转给哪个团队(问题),决策模型返回带概率的类型化答案(输出),你的代码据此路由工单、触发升级,或者交给人工。这套东西的代价和收益是同时到来的 —— 你放弃「开放域推理」,换来「确定性、低延迟、可校准」,而这正是 Agent 循环里绝大多数步骤需要的性质。
云计算公司说得更直白。AWS 那条路线的一句话是:把「生成」整条路径删掉。
Cloudflare Clef:把一个 Qwen 改造成打分器
Cloudflare 这次发的是两个模型 + 一个微调平台。
Clef 是 27B 参数、Clef-flash 是 9B 参数,作者署名为 Michelle Chen、Alex Reneau、Kevin Flansburg。名字来得很聪明:乐谱开头的谱号(clef)规定后面那些音符各自是什么音高,而决策模型规定的是「后续动作」的取值域 —— 名字里那个 CF 又对应 Cloudflare。两个模型托管在 Workers AI 上,权重完全开源到 Hugging Face,Apache 2.0,你下载下来能自己跑。
它是怎么训练的?官方给了一条比一般公告详细得多的技术路径:
- 底座:冻结 Qwen3.8-27B(Clef)和 Qwen3.5-9B(Clef-flash),只训练「路由头 + rank-256 的 LoRA 适配器」;
- 推理方式:用 Qwen 做一次 prefill-only 的前向,然后并行对合法 schema 选项打分。因为是非自回归,没有中间文本要一个个 token 生成,所以显著快于自回归的 LLM;
- 怎么取答案:不从文本里解析,而是直接从内部表示里导出 schema 选项,靠一套两阶段的注意力路由(每个候选选项各自抽取与 prompt 相关的上下文,字段之间互相 cross-attend,再回到原始 payload 打分);
- 怎么校准概率:训练用标签平滑的交叉熵(面向合法 schema 输出)配一个 Brier loss 来校正概率校准,数据是自己合成的、会打乱字段顺序 / prompt / schema 结构;
- 额外的优化目标:他们自己做了个叫 RLCD(Reinforcement Learning for Calibrated Decisions) 的方法 —— 给相邻的序数选项部分学分、给完全精确的记录全额奖励、再加一项 reference penalty 防止分布漂移。
官方坦承这条路不是凭空来的:Cloudflare 内部先做过一个家酿的决策模型(有个用 DiffusionGemma、把 LLM 生成的 logprobs 暴露出来变成确定性概率的演示),Clef 是在这个基础上换了底座、继续往前做的。他们还提到这是「市场正越来越拥挤」的前提下仍然选择开源的决定。
它和 Jev 的差别,官方自己列了三条,其中最实在的两条是:Clef 有视觉编码器,能对图像做分类(Jev 目前只做文本);上下文 64k,而 Jev 是 32k。第三条是基准分数,下面单独讲。
有一个自证的数字值得记下来:Cloudflare 把它拿去给自己的威胁情报团队给域名分类,用 Browser Run 抓取并渲染后分类,2.2 秒完成;同一工作流里他们最快的通用 LLM gpt-oss-120b 要 4.7 秒,而且只返回了两个分类。官方给的结论是「延迟省 2 倍、结果更多」。
最后是配套的服务:RL 微调平台。先由 forward-deployed engineer(FDE)团队上手陪做,之后开放自助平台。它踩的四个已经有的积木是:AI Gateway 把 AI 流量过一遍、自动沉淀成数据集;Workers AI 跑 rollout;Containers 当 RL 的评分与重放沙箱;Workers AI + BYO Model 把微调后的模型直接部署回去。顺带给了一条企业侧承诺:不读取、不存储、不用你的请求与响应做训练(除非你自己要用微调产品)。
官方基准:Clef 赢了 Jev 三个象限
Cloudflare 把 Clef 拿去跑了 Jev Decision Index 里他们认为重要的评测,并和市面上几个决策模型做了对比。官方博客里的表是这样的:
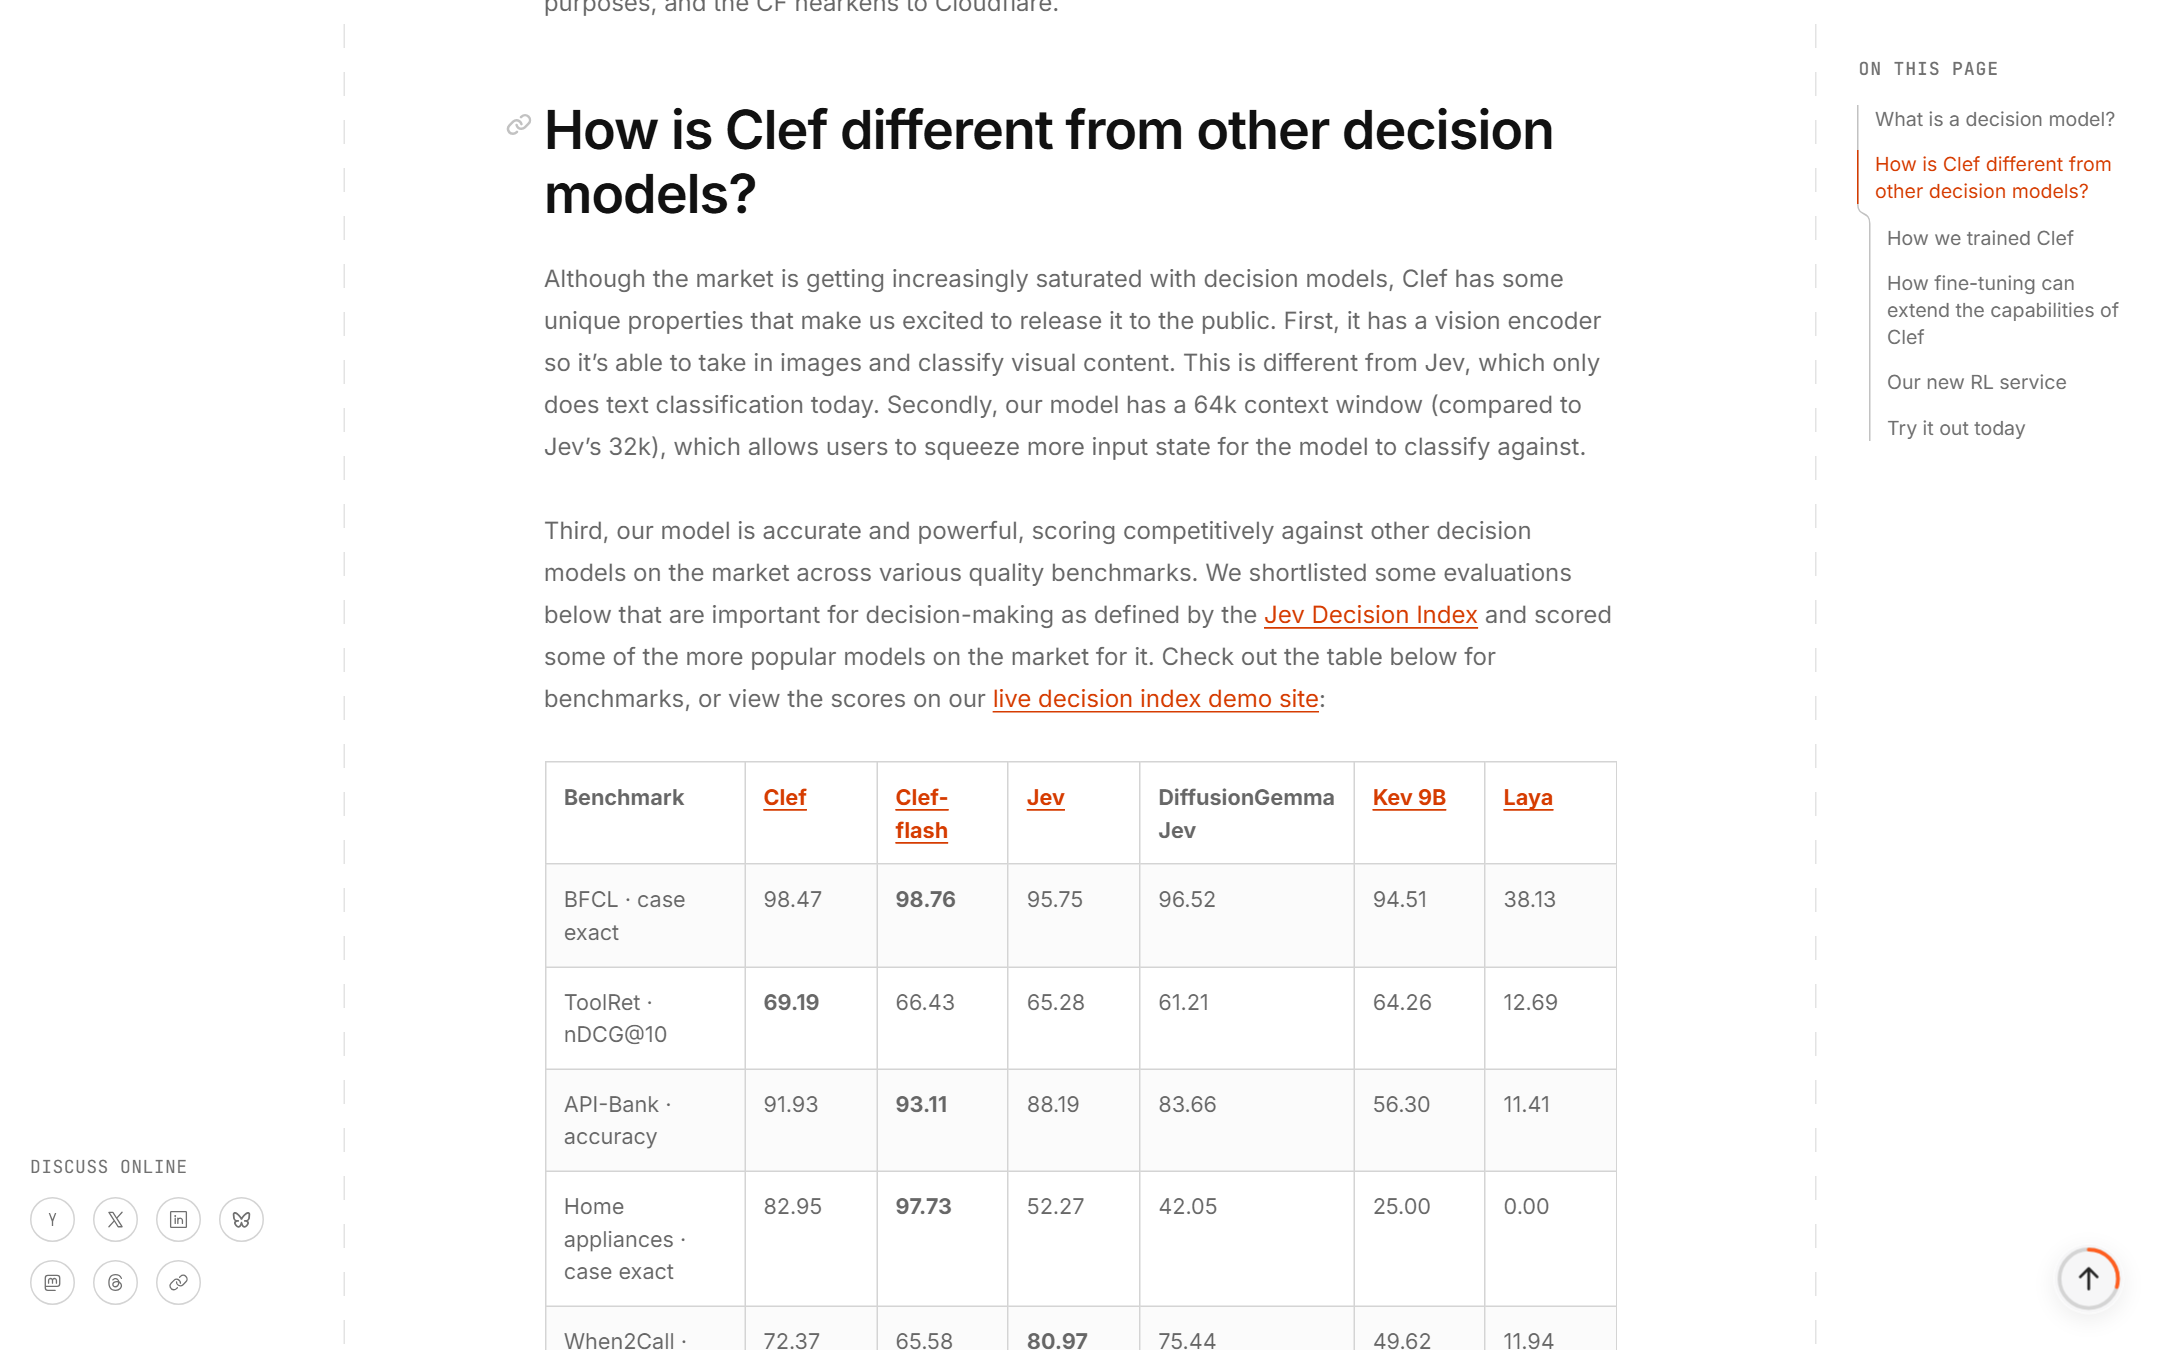
| 基准 | Clef (27B) | Clef-flash (9B) | Jev | DiffusionGemma Jev | Kev 9B | Laya |
|---|---|---|---|---|---|---|
| BFCL · case exact | 98.47 | 98.76 | 95.75 | 96.52 | 94.51 | 38.13 |
| ToolRet · nDCG@10 | 69.19 | 66.43 | 65.28 | 61.21 | 64.26 | 12.69 |
| API-Bank · accuracy | 91.93 | 93.11 | 88.19 | 83.66 | 56.30 | 11.41 |
| Home appliances · case exact | 82.95 | 97.73 | 52.27 | 42.05 | 25.00 | 0.00 |
| When2Call | 72.37 | 65.58 | 80.97 | 75.44 | 49.62 | 11.94 |
几个可以自己读出来的结论:
- Clef 在两个尺寸上都在四项里赢了三项:BFCL、ToolRet、API-Bank、Home appliances 四项里,官方口径是「在四个中的三个上击败 Jev」;唯一输的是 When2Call(72.37 / 65.58 对 Jev 的 80.97)。
- 9B 的 Clef-flash 反而更强:它在 BFCL、API-Bank、Home appliances 上都不输甚至反超 27B 的 Clef,只在 ToolRet 与 When2Call 上低一些。官方特意强调「考虑到它快得多,这个表现很突出」。
- Laya 是个反例:它在除 When2Call 之外几乎全线垫底(Home appliances 0.00),但官方在延迟部分把它单独挑出来,说它「非常快,但在这个基准上牺牲了质量」。这句话其实是在给整个品类划边界:速度和智能要一起看,单看一头没有意义。
另外官方说他们一共跑了 43 个评测基准,并称 Clef 在延迟上击败了所有其他决策模型(Laya 除外)。这些数字全部来自 Cloudflare 自己的测试 —— 目前还没有第三方独立复现。
AWS Strands Decider 2B:把「语言模型头」换成 100 万参数的「指针头」
同一天,AWS 那边给出了另一种答案:不做更大的模型,而是把模型里「你不需要的那部分」删掉。
Strands Decider 2B 来自 AWS Strands Labs(AWS 2026 年 2 月 23 日开的一个实验性 agentic 项目组织),具体做法是:拿 Qwen3.5-2B-Base 当躯干,把原来的语言建模头摘掉,换成一个只有约 100 万参数的「指针头(pointer head)」,再用 rank-16 的 LoRA 微调,让它在一次前向里直接把每个候选选项的隐藏态与答案位置对齐打分。AWS 文档里管这套架构叫 Hobson。权重发布在 Hugging Face(StrandsAgents/strands-decider-2B-hobson-v19),Apache 2.0。
它的故事起点也很有意思:这是 Amazon 的杰出工程师 Marc Brooker 看到 Jev 之后自己动手做的一个项目,做到「短暂地在同尺寸模型的 JevBench 排名里冲到第一」之后,AWS 的工程师把它整理干净、作为 Strands Labs 的产出发布。Brooker 对 TechCrunch 解释他为什么对这个品类感兴趣:
「最初勾起我兴趣的是,它们非常适合做工作流某一步的决策者 ——『基于我当前的位置,下一步该做什么?』」
他给客户的理由也很工程化:这样的一步「因为置信度分数、因为答案域是封闭的,所以结构上更可靠,延迟更低,成本可能也更低」。
基准与延迟:官方口径是它在 JevBench 上约 72% 准确率、Brier 分 0.35(v19),easy 档满分;在约 2B 参数的公开模型里排第二,在公开了完整训练配方的模型里排第一。延迟方面,报道口径是消费级 GPU 上中位数约 115 毫秒,AWS 自己说的是「小于 150 毫秒」—— 这也是他们特意选 2B 这个尺寸的理由:小到能在本地跑,又还够用来做复杂决策。
开源程度是它和另外两家最大的差别:权重、训练数据清单(含来源许可)、训练配方、评测台、研究日志全都公开,放 GitHub 上的 strands-labs/strands-decider。安装一条命令(pip install strands-decider),自带 CLI 和 HTTP 服务。作为对比,Jev 只在 TypeSafe 的托管 API 上跑、架构不公开;Clef 权重开源,但托管只在 Workers AI 上。
它怎么被用:仓库里的参考集成是 Strands agent 里的一个 before_tool_call 钩子,在任何外部工具调用前问两个是/否问题 —— 参数是不是真的有用户原话作为依据?这次调用相对于当前对话状态是不是太早了?举的例子很具体:如果 agent 自己推断出了一个用户从没提过的城市名,钩子会把那个被推断出来的值抓住,先回去要澄清,而不是让工具就这么发出去。这正好和前面 Claude Code 那套「事件级拦截」是同一种思路 —— 决策模型就是那位挂在钩子上的廉价裁判。
一个需要注意的运维细节:目前没有托管的推理端点,自带的服务器只绑 localhost 且没有认证层,所以团队要往共享基础设施上部署,得自己加访问控制。
三家横向对比:谁开源、谁闭源、贵不贵
把 Jev、Clef 和 OpenAI 的 Decisions API 放在一起,能看出三家策略上的差别:
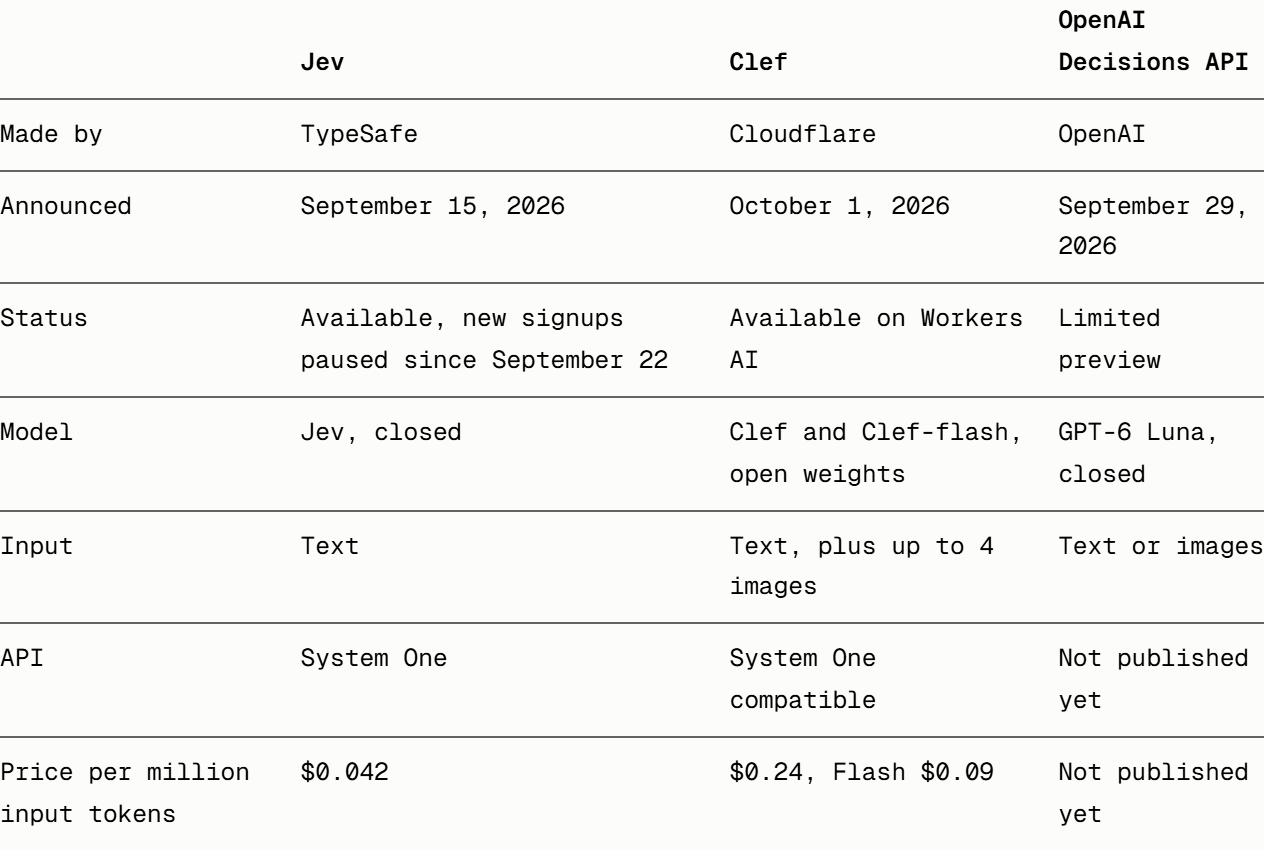
| 维度 | Jev(TypeSafe) | Clef(Cloudflare) | OpenAI Decisions API |
|---|---|---|---|
| 发布 | 2026-09-15 | 2026-10-01 | 2026-09-29 |
| 状态 | 可用,但 9 月 22 日起暂停新注册 | Workers AI 上可用 | 限定预览 |
| 模型 | Jev,闭源 | Clef 与 Clef-flash,开放权重 | GPT-6 Luna,闭源 |
| 输入 | 文本 | 文本 + 最多 4 张图 | 文本或图像 |
| API | System One | 兼容 System One | 尚未公布 |
这张表最值得看的一列是「API」:Clef 直接兼容 System One,也就是 TypeSafe 那套请求/响应格式,意味着大量为 Jev 写好的代码几乎可以平移过去。Cloudflare 官方也说「可以极容易地完成切换」。一个品类里出现「后来者主动兼容先行者」的接口,通常比出现更多玩家更能说明它开始稳定下来 —— 而这次是后来者主动去兼容先行者,而不是各自造一套。
把这个和前面三个时间点放在一起看:两周内四家入场,其中三家是巨型云厂商。 顺带说一句,这已经是本站一个月内第三次写到这个品类了 —— Jev 的 System One 全解 和 OpenAI Decisions API 为什么被叫「Jev 克隆」 可以连着读。
但这一层值不值得做?两种相反的说法
热闹之外,有一场挺有意思的公开分歧,值得读者自己判断。
AWS 的 Brooker 是乐观的:他不认为前沿实验室会主导这个领域,理由很经济学 —— 市场小,做一个「有意思的东西」的成本是数百到数千美元级别,这让任何人都能进场。
Cloudflare 则是「明知拥挤仍要进」:官方承认「市场正越来越拥挤」,但认为 Clef 的视觉能力、64k 上下文和基准成绩足以成为差异化。
反过来,被「克隆」的那家自己泼了冷水。 TypeSafe 的 CEO 兼创始人 Diogo Almeida 对 TechCrunch 说了一句很锋利的话:
「我明白大家觉得这是场淘金热,但他们可能低估了把模型真正做聪明有多难。目前这一批更像是 ML 的人想实现一个很酷的架构,而不是一支专心把智能做到有用的团队。」
他还说,就目前而言,他看不到真正能构成竞争的对手出现。而 Brooker 对难点的描述其实和这个质疑是同一个方向,只是更技术化 —— 他认为挑战在于要在「速度和准确性 / 校准」与「别把通用能力(多语言、知识面)搞坏」之间找到一个很细致的平衡点,因为后者才是让模型「通用、有趣、有用」的原因。
翻译成一句话:做一个跑得飞快、在预设选项里选得对的分类器并不难;难的是在变快的同时不把脑子做没。 这正好也能解释为什么 Laya 那样的模型会出现在同一张基准表里:快得像闪电,分数掉到 0。
这两次发布透露的三件事
第一,Agent 的「判断层」正在从「生成层」里独立出来。 两个云厂商在同一个月、同一周做同一件事,且都强调「不做文本生成」,说明这已经不是一个厂商的品味,而是一个被反复验证过的工程结论:Agent 循环里大部分步骤是分类与路由,而不是创作,不该按创作来付费。
第二,开源程度成了这个品类的一个竞争维度。 三家里 Jev 闭源、Clef 开源权重、Decider 2B 连训练配方都开。云厂商的动机很实际 —— 决策模型很小、很便宜,把它开源出去换生态,比靠它赚钱划算得多;它真正的商业价值在后面(Clef 配 RL 微调平台、Decider 配 Strands Agents 生态,后者已在 Amazon Q Developer、Kiro、AWS Glue 里跑生产)。
第三,这类模型的落点是「护栏」,而不是「替代」。 无论是 AWS 那个「工具调用前问两个问题」的钩子,还是 Cloudflare 那个「给域名分类、找钓鱼站」的威胁情报用例,它们干的都是先审一遍再放行。这也意味着它天然适合被塞进厂商的安全叙事里 —— 决策模型是给 Agent 装的那道廉价安检闸机。
对开发者的实际建议很简单:如果你的 agent 里有一步是「从 N 个已知选项里挑一个」,先把它从 LLM 里拆出来试试。 现在有 Apache 2.0 的权重可以直接下到本地跑,试错成本是几百毫秒和一点磁盘空间,而不是一次架构决定。
总结
- 是什么:决策模型不生成文本,只对预设选项打分并返回校准概率;一次 prefill-only 前向、非自回归,所以更快更便宜,输出域天然封闭。
- Cloudflare Clef:27B(Qwen3.8-27B)与 9B(Qwen3.5-9B)两档,rank-256 LoRA、冻结底座、prefill-only 并行打分、标签平滑交叉熵 + Brier loss + 自研 RLCD 校准;带视觉编码器、64k 上下文、Apache 2.0 权重、兼容 System One;自家威胁情报用例 2.2s 对 gpt-oss-120b 的 4.7s;配了 RL 微调平台(FDE 先行,自助在后)。
- AWS Strands Decider 2B:Qwen3.5-2B 躯干 + 约 100 万参数「指针头」+ rank-16 LoRA(架构代号 Hobson);JevBench 约 72% / Brier 0.35,消费级 GPU 中位数约 115ms;权重、训练数据清单、训练配方、评测台全开源,
pip install strands-decider即用,但自带服务只绑 localhost、无认证。 - 格局:9/15 Jev → 9/29 OpenAI Decisions API → 10/1 Clef 与 Decider 2B,两颗新星同日出;Clef 兼容 System One,说明这套接口正在成为事实标准。
- 分歧:Cloudflare 承认市场拥挤仍入场,AWS 认为成本低到人人可做;而被克隆的 TypeSafe 认为这更像「淘金热」,真正的门槛是在变快的同时不把智能做没。官方基准数字目前都来自各自厂商自测,尚无第三方独立复现。
- 怎么用:把「从已知选项里挑一个」的步骤(路由、工具选择、审批、护栏)从 LLM 里拆出来;现在有 Apache 2.0 权重可在本地直接试。
相关阅读:TypeSafe Jev 与 System One 全解 | OpenAI Decisions API:被 TechCrunch 称为「Jev 克隆」 | Claude Code Mods:事件级拦截 Agent 内部行为
图片出处:封面、架构对比图与时间线由 UU AI Hub 自制;Cloudflare 公告与官方基准表取自 Cloudflare 官方博客原文;三家横向对比表取自第三方拆解文章 flaviocopes.com 的 Clef 深度分析。