一句话
这一周真正变的不是模型能力,是账单结构。 同样是「读一万字、写一段代码」,用哪家 API,价格能差到 30 倍——而且这个差价有一半来自促销截止日,不来自技术。
三天,四张价目表
图:Gemini 4 Carbon 官方发布主视觉。图片来源:blog.google
| 日期 | 厂商 | 动作 | 单价(每百万 token,输入 / 输出) |
|---|---|---|---|
| 11-09 | Anthropic | Claude Fable 5.2 / Mythos 5.2 发布 | $8 / $40;fast 模式 $16 / $80 |
| 11-10 | Gemini 4 Carbon 全量开放(付费层) | $2 / $10,促销至 11-30,12-01 起 $4 / $20 | |
| 11-11 | 百度 | 文心 ERNIE 5.5 Flash Preview 上千帆 | ¥1 / ¥4(五折·高峰);空闲档 ¥0.5 / ¥2 |
| 11-11 | 阿里 | Qwen4-Max 开放预览 | 未公布按量单价,仅 Token Plan 订阅 |
四家在同一档「旗舰」位置上,公开单价的跨度是:Gemini 的促销价、Claude 的常规价、文心的折后价,按当日汇率(1 美元 ≈ 6.69 元)折算后大致是 $2 / $8 / $0.15(每百万输入)。相差 50 倍上下。
Google 那张价目表值得单独看一眼,因为它的低价有到期日:
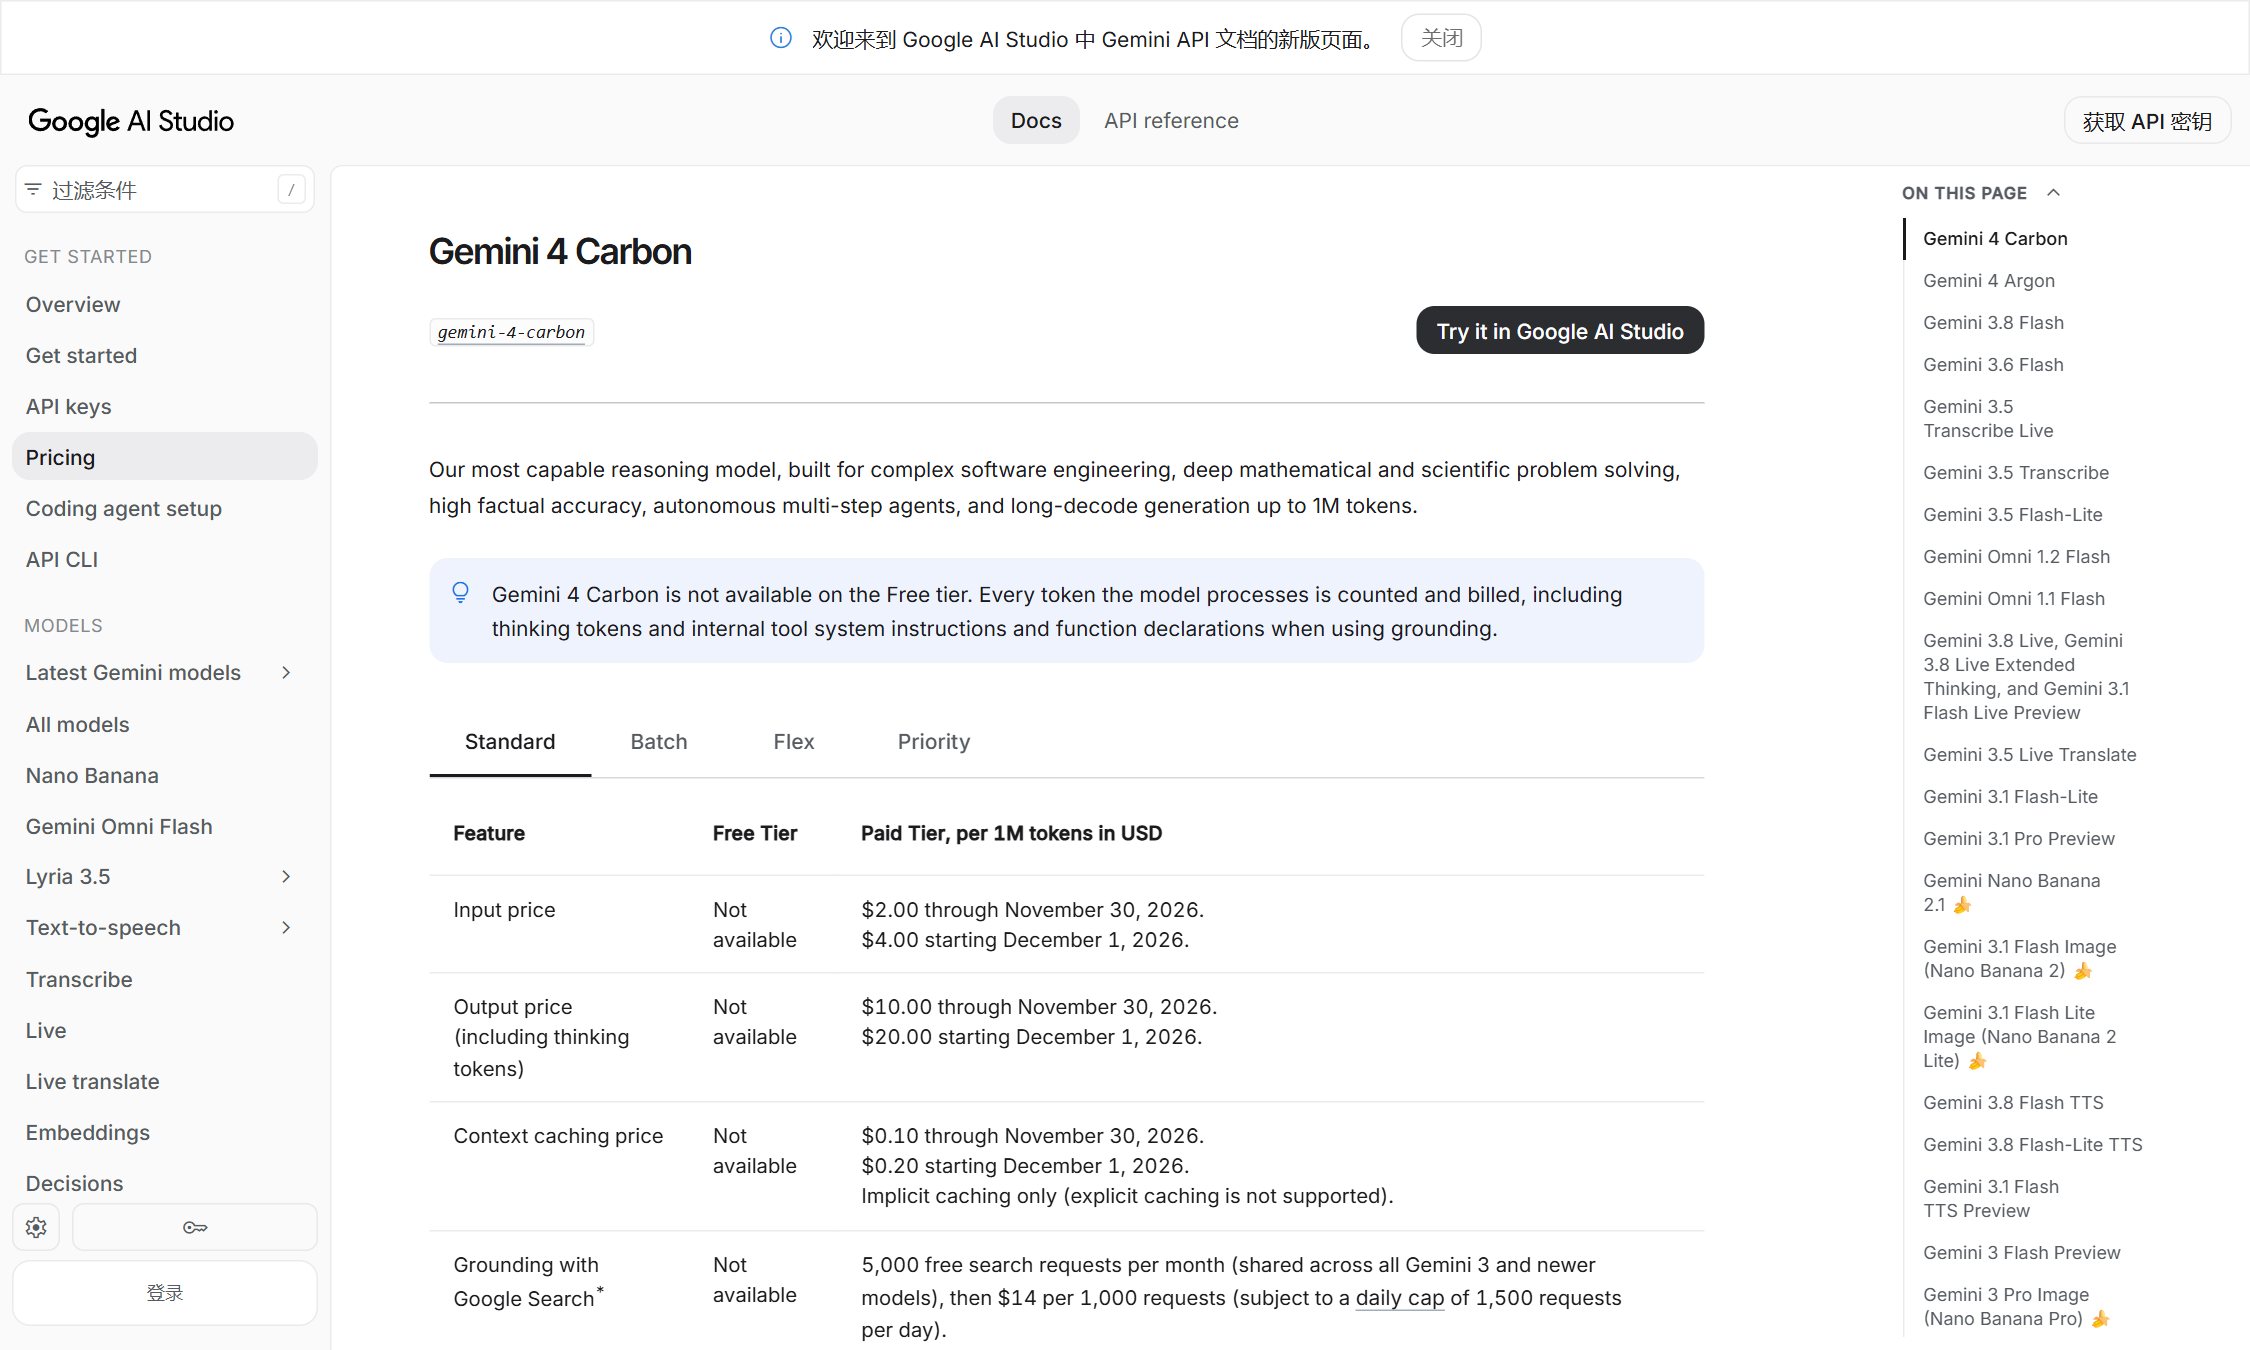
图:Gemini 开发者 API 定价页的 Gemini 4 Carbon 区块,促销价的截止日写在价格旁边。图片来源:ai.google.dev
注意两件事:Carbon 不提供免费层(页面上 Free Tier 写的是 Not available,连思维链 token 和工具声明都计入计费);上下文缓存单价也从 $0.10 起、12 月起翻到 $0.20。促销期只有 20 天。
把单价换成「干一件活多少钱」
单价不好感受,换成三个具体任务。假设写在表下面,可以自己改数重算:
| 模型 | A 长文档:150 万输入 + 2 万输出 | B 编码 Agent:50 万输入 + 10 万输出 | C 批量分类:500 万输入 + 50 万输出 |
|---|---|---|---|
| Gemini 4 Carbon(促销) | $3.20 | $2.00 | $15.00 |
| Gemini 4 Carbon(12-01 起) | $6.40 | $4.00 | $30.00 |
| Claude Fable 5.2 | $12.80 | $8.00 | $60.00 |
| Claude Fable 5.2 fast 模式 | $25.60 | $16.00 | $120.00 |
| 文心 5.5 Flash(五折·高峰) | $0.24 | $0.13 | $1.05 |
| 文心 5.5 Flash(五折·空闲) | $0.12 | $0.07 | $0.52 |
| 文心 5.5 Flash(优惠到期·高峰) | $0.47 | $0.27 | $2.09 |
假设:A 是「一份 200 页报告、十轮追问、每轮重发全文」;B 是一个中等规模编码任务的工具调用往返累积;C 是每天一万条短文本分类(每条 500 字输入、50 字输出)。这些数字是量级参考,不是承诺——你的实际缓存命中率、重试次数、max_tokens 设置都会改写结果。
结论很直接:Fable 5.2 恰好是 Carbon 促销价的 4 倍,开 fast 模式就是 8 倍;而文心的折后价只有 Carbon 促销价的 1/14 上下(空闲档约 1/28)。
价格差 4 倍,能力差多少?
Anthropic 自己发的对比表里,把 Gemini 4 Carbon 放进了同一张榜。这张表是他们自评的,但至少口径统一:
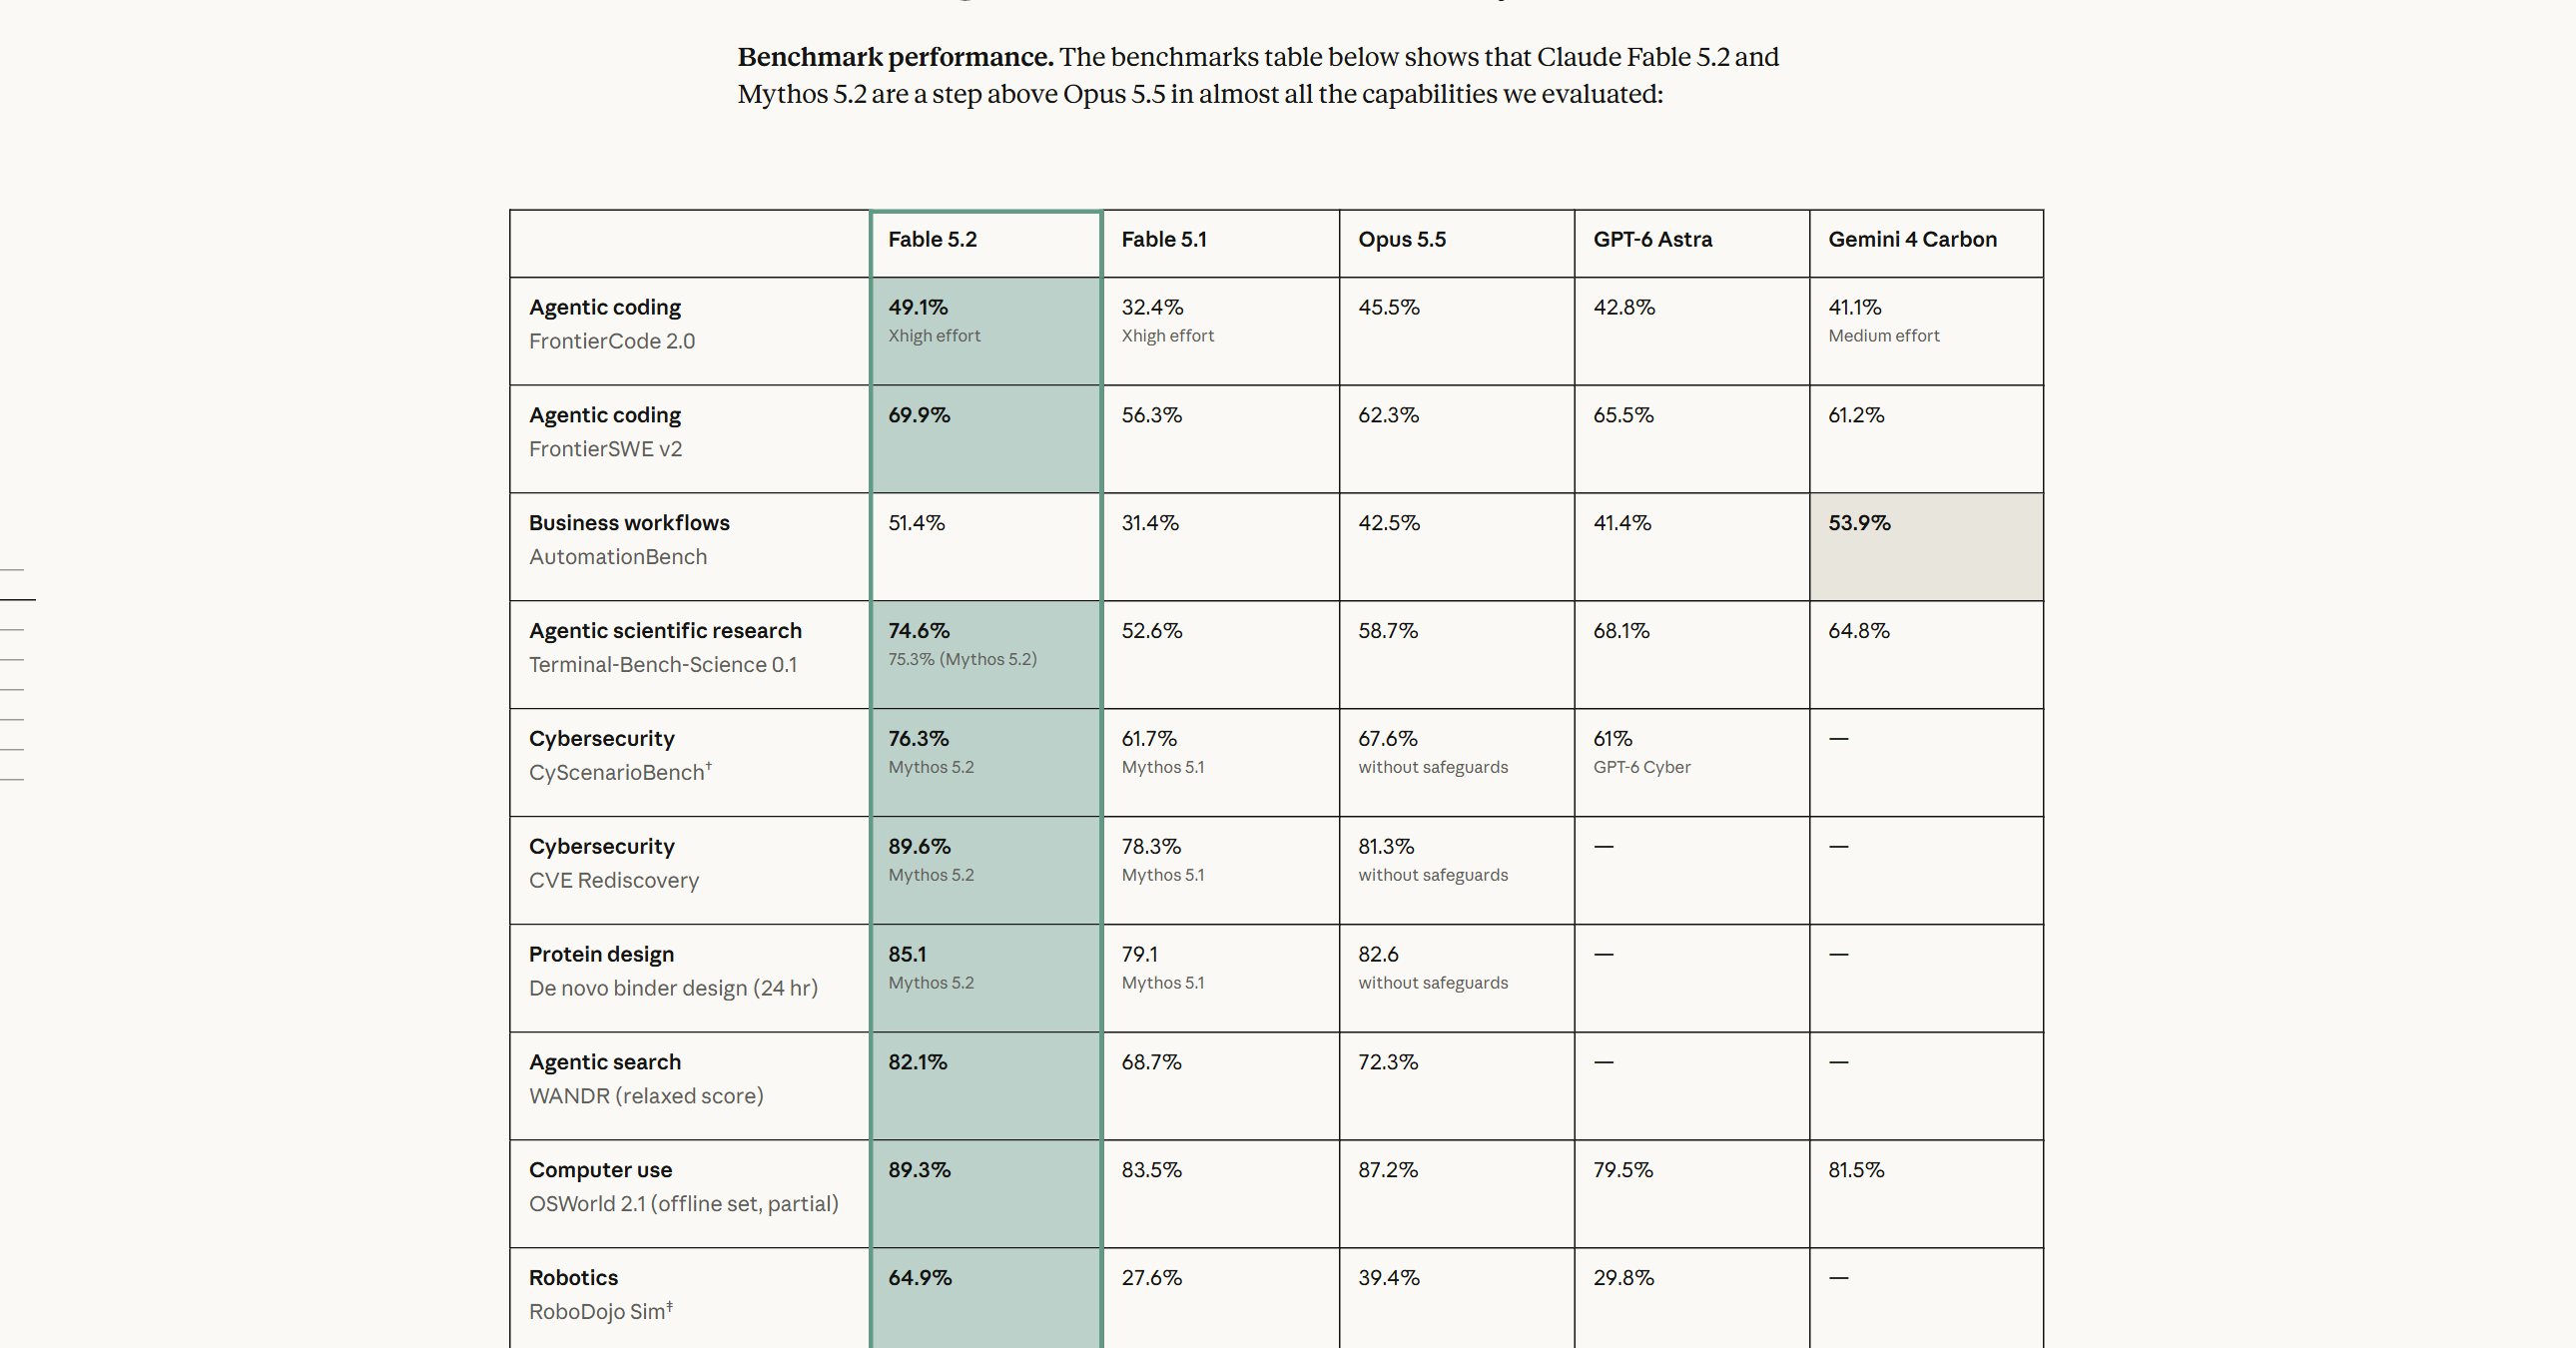
图:Anthropic 发布稿中的基准测试表,五款模型同表对比。图片来源:anthropic.com
挑几行看:
| 基准 | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0(Agent 编码) | 49.1% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 62.3% | 65.5% | 61.2% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1(电脑操作) | 89.3% | 87.2% | 79.5% | 81.5% |
| AutomationBench(业务自动化) | 51.4% | 42.5% | 41.4% | 53.9% |
| Chartography(无工具读图表) | 73.4% | 64.4% | 71.0% | 72.5% |
有两个地方要打星号:
- Anthropic 自己的表里,Carbon 在业务自动化上是这一列里最高的(53.9%,Fable 为 51.4%);Google 的发布稿也单独宣称 Carbon 在 Zapier 的 AutomationBench 上排第一。两家的分数不同源、不一定可比,但方向一致:「贵 4 倍」买到的不是全能压制,是编码、科研、电脑操作这些长链任务的稳定性。
- Carbon 那一列标的是 Medium effort,Fable 标的是 Xhigh。 不同思考档位的分数不能直接横比——真要省钱,先在自己的任务上把 effort 调低试一遍,再决定要不要为最高的那一档付钱。
Google 那边给的效率论据是「每任务成本」:官方称 Carbon 在 CursorBench 4.0、Perplexity 的 WANDR、Zapier 的 AutomationBench 上排第一,且每任务成本比次优的外部模型低 2 倍以上;在 Artificial Analysis 新出的多模态知识 Agent 基准(MKA)上排第二,平均每任务成本比第一名低 6 倍以上。注意这是 Google 自己的口径,且基准由合作方设计,读的时候把「排名」和「成本」分开看。
三家为什么这么定价
把促销日期和计费方式并排看,逻辑就清楚了:
- Google 用的是「限期低价换迁移」。$2/$10 只保 20 天,12 月起原价翻倍。真正的算盘是让你在这 20 天里把 prompt、缓存策略、评测集都挪到 Carbon 上,到涨价时迁移成本已经沉没。同一档的 Argon 也是这个促销价——等于用一条价格线守住整个编码市场。
- Anthropic 用的是「贵的卖难点,便宜的卖日常」。发布稿里明写:大多数编码与知识工作建议从 Opus 5.5 起步,需要时再往上换 Fable,或者往下换 Sonnet 5.5 / Haiku 5.5。Fable 还支持当 Advisor(小模型遇难题时咨询它)和 Orchestrator(把简单任务派给更小的模型)——它卖的本来就是「最难那 5%」,按 4 倍价卖才成立。
- 百度用的是「分时 + 限时折上折」。五折到 11 月 30 日,同时高峰(8:00–22:00)与空闲(22:00–次日 8:00)两档,空闲再省一半;命中缓存的价格是 0.1 元/百万(折后)。这套结构把「什么时候跑」变成了成本变量——批量任务挪到深夜,账单直接砍半。
- 阿里用的最不一样:不卖 token,卖订阅。 Qwen4-Max 预览只走 Token Plan,明确不支持按量计费,预览期也只到 11 月 25 日。没有公开单价,就没办法放进单位成本表——但它把「成本不可预测」这件事从用户身上挪到了自己身上,对个人开发者反而是最省心的一种。
文心的官方价目页把折扣期和分时价写在了一张卡片上:
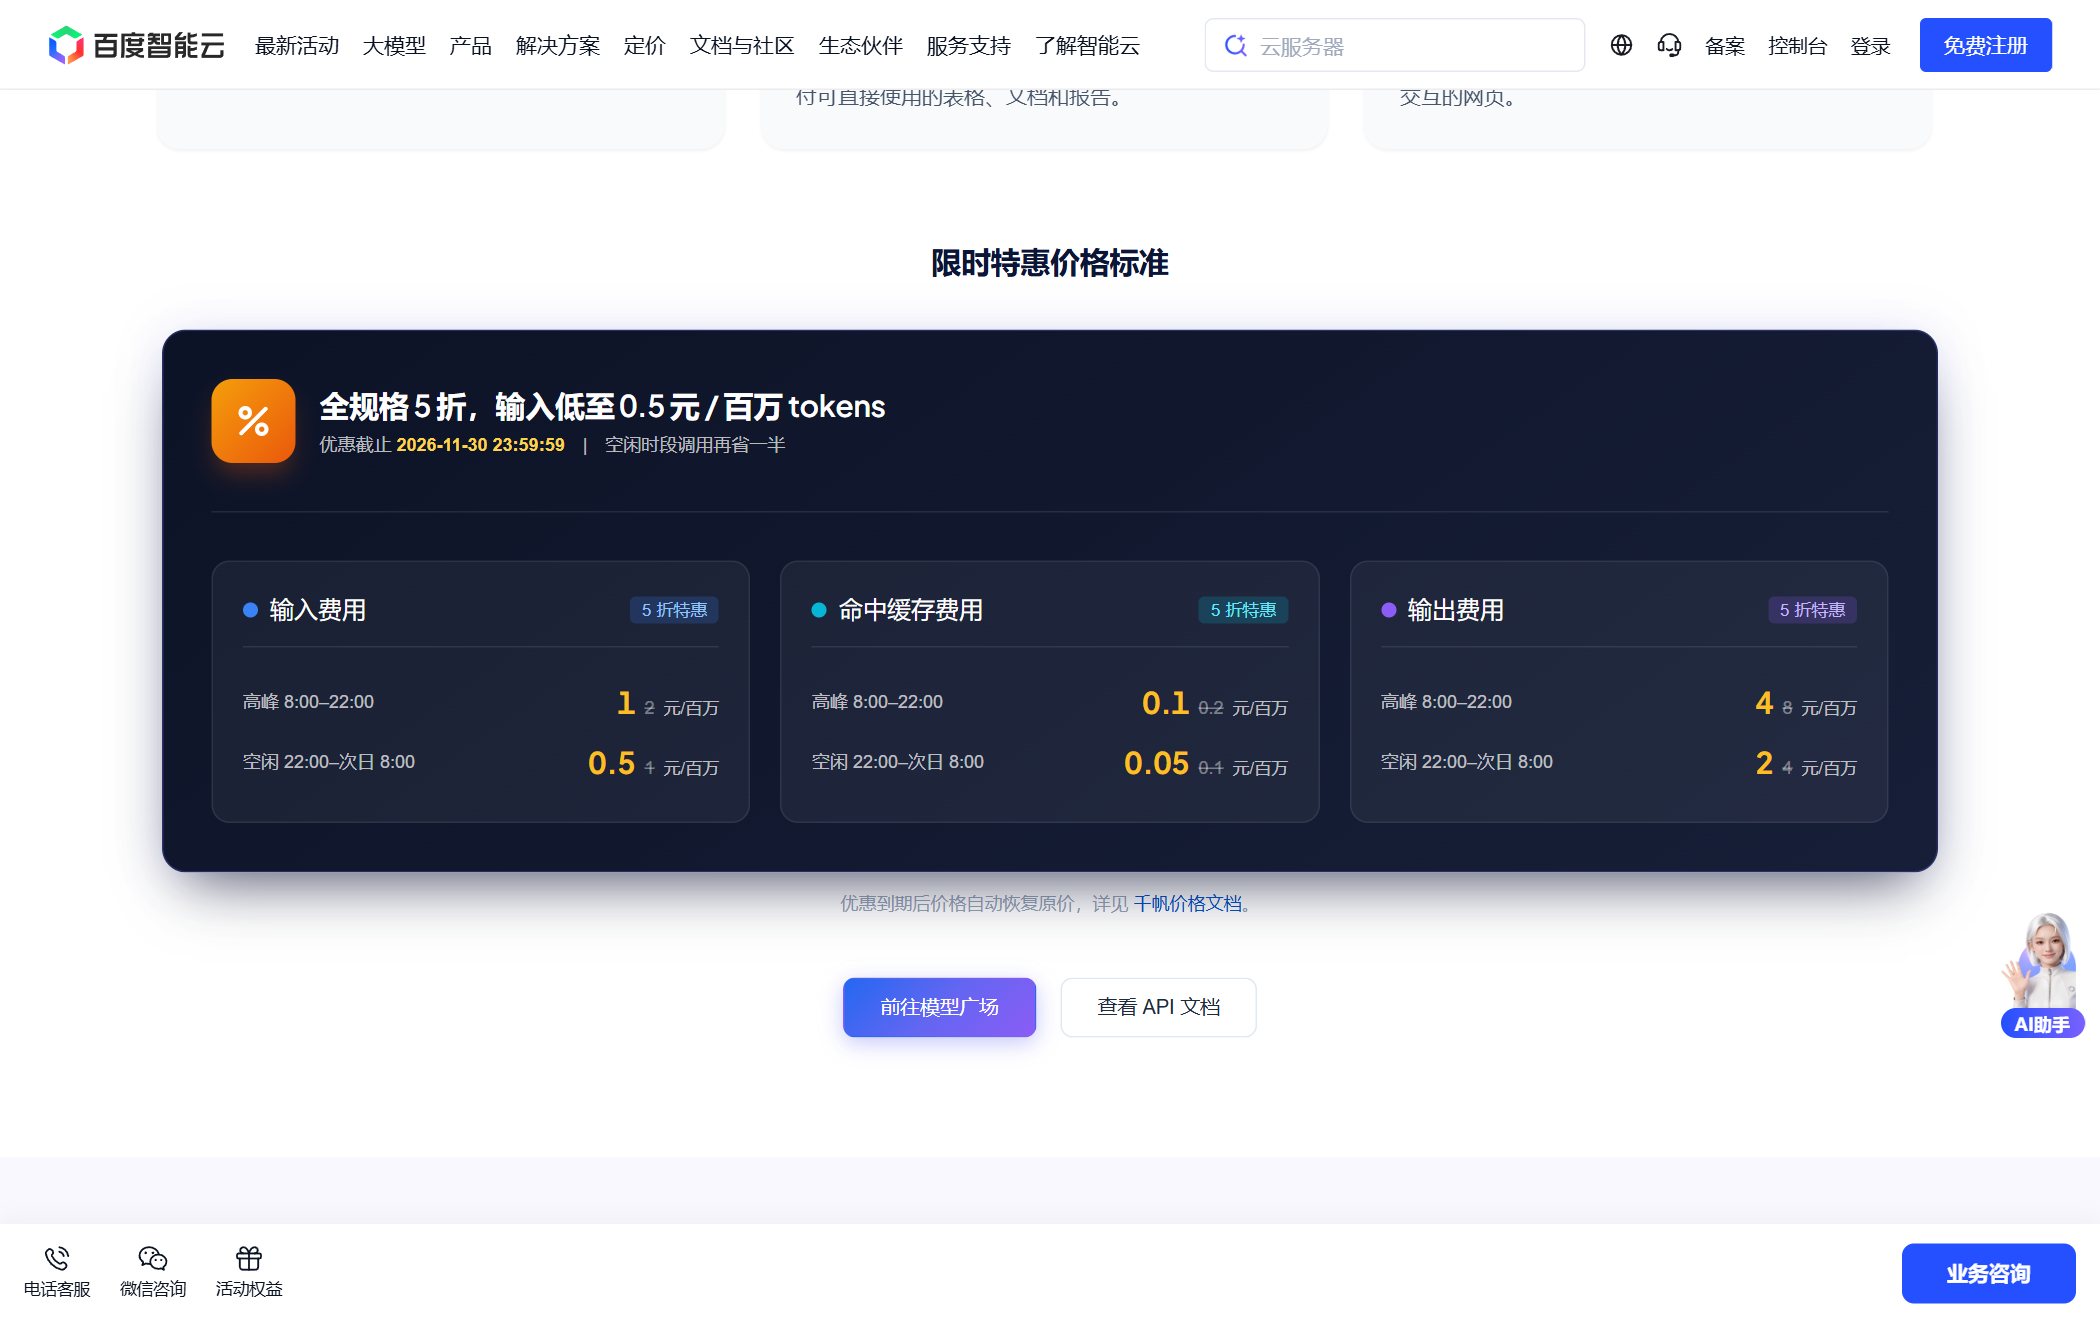
图:百度智能云千帆产品页的限时价格卡片,折扣截止时间与分时价并列。图片来源:cloud.baidu.com
Qwen4-Max 那边,官方文档把「只走订阅」写得同样直白:
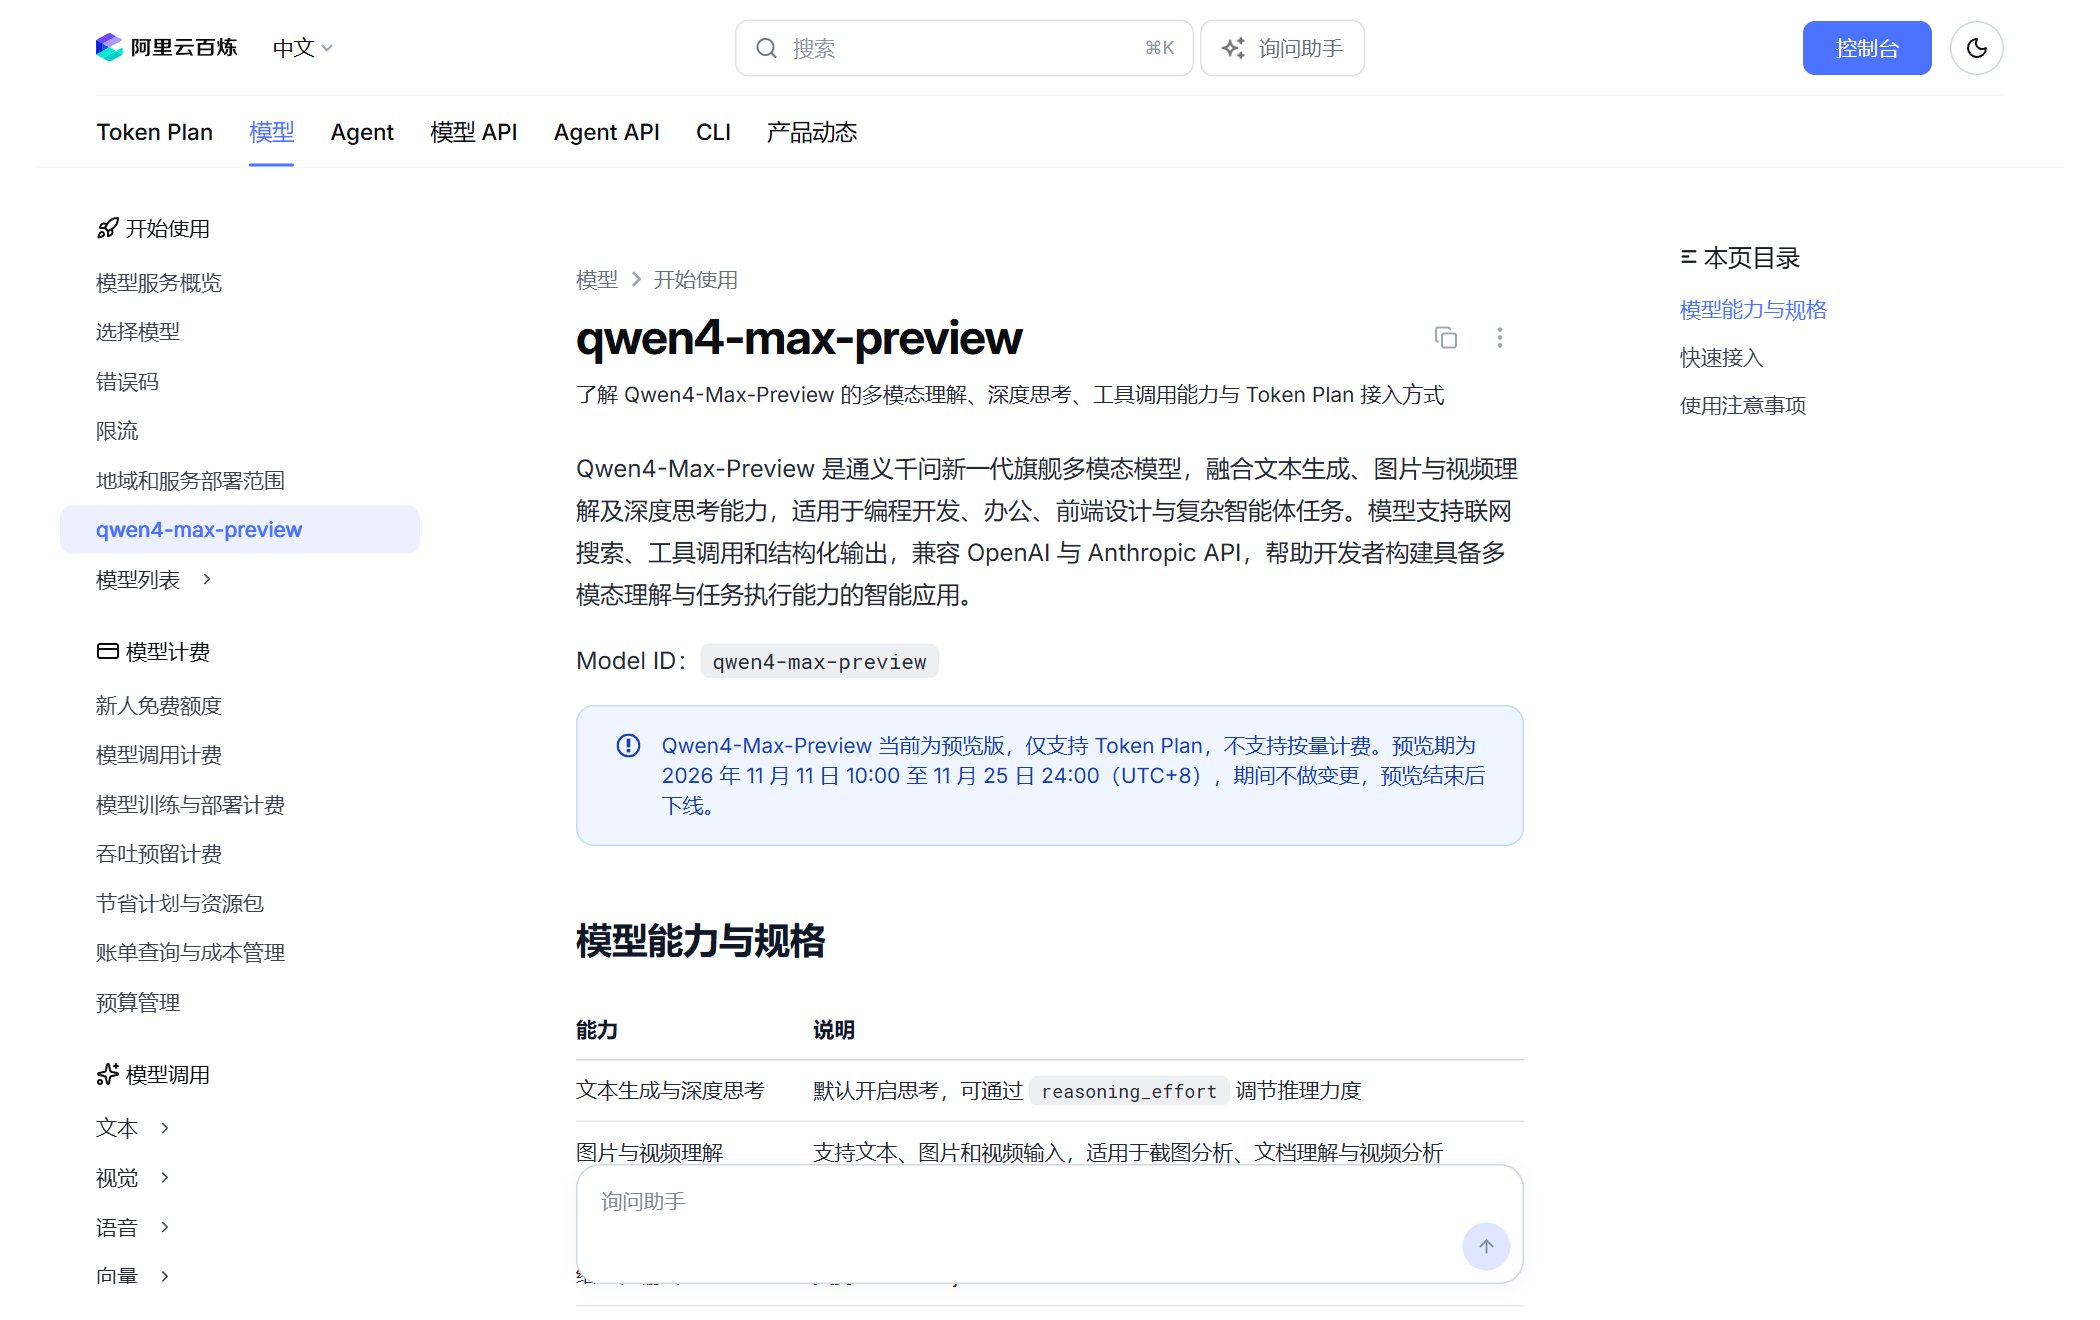
图:阿里云百炼文档页,预览期与计费方式写在同一个提示框里。图片来源:docs.bailian.console.aliyun.com
中文用户怎么选:四条路
不看发布会话术,只看你手上是什么活:
① 长文档、批量处理、数据清洗 → 文心 5.5 Flash 280B 总参数、每 token 激活 14B、1M 上下文、200+ tokens/s,折后价格是四家里最低的一档。把批处理挪到 22:00 之后跑,还能再省一半。代价是它是 Preview:官方自己写明「是后训练过程中的中间版本,可能存在部分因训练不充分导致的能力缺陷」,别把线上关键路径压在一个会变的预览版上。
② 复杂编码、跨子系统改造、科研推理 → Fable 5.2 贵 4 倍是给长链任务的稳定性付钱:FrontierSWE v2 69.9% 对 Carbon 61.2%、Terminal-Bench-Science 74.6% 对 64.8%。但没必要全用——发布稿给的分层是「Opus 5.5 当日常主力,难的往 Fable 升级,简单的往下走 Sonnet / Haiku」,或者让 Fable 当 Advisor,只在小模型卡住时被咨询。
③ 想用最强档但预算有限 → 趁 Carbon 促销期,把评测跑完 20 天窗口适合做两件事:把你自己的评测集在 Carbon 上跑一遍,拿到「同任务成本」的真实数字;以及确认 12 月翻倍后你是否还愿意付。别在这 20 天里把生产流量全搬上去,然后被 12 月的账单教育。
④ 只在 Claude Code / Cursor 里交互式用 → Qwen4-Max 的订阅模式
1M 上下文、输出上限 393,216、思考默认开启(reasoning_effort 可选 low / medium / xhigh),OpenAI 与 Anthropic 两种 API 都兼容,改个 model id 就能接。但要读清限制:订阅额度只能用于交互式工具,不能拿来做自动化脚本或批量调用,违规会封 key;预览结束后模型直接下线。
五个容易算错的坑
- 促销价不是价格,是截止日。 Gemini Carbon 12 月 1 日起翻倍;文心五折到 11 月 30 日 23:59:59;两家同一天到期。按促销价做的预算,12 月会全错。
- fast 模式是加价档,不是免费加速。 Fable 5.2 的 fast 模式 $16/$80——比常规价再贵一倍。只在「人坐在屏幕前等结果」时开,后台任务开它纯属烧钱。
- 分时计费会把账单和时区绑在一起。 文心的空闲档是 22:00–次日 8:00(北京时间),批量任务调度器如果按 UTC 排,会正好排进高峰。
- 思考 token 也计费。 Carbon 的定价页明写:思维链 token、工具声明(function declarations)在使用 grounding 时都计入计费。把 effort 调到最高再跑批量任务,实际花费可能比表上的估算高出一截。
- 「输出上限」是思考 + 回答共享的预算。 Qwen4-Max 这一代起,OpenAI Chat Completions 的
max_tokens与max_completion_tokens等价,限制的是思考内容与最终回答的总量——沿用旧的「只给回答留额度」的写法,输出会被提前截断。
日历:接下来两周的四个日子
| 日期 | 会发生什么 |
|---|---|
| 11-25 | 文心 5.5 Flash Preview 权重计划以 Apache 2.0 开源;同日 Qwen4-Max 预览下线(24:00,UTC+8) |
| 11-30 | Gemini Carbon 促销价最后一天;文心五折最后一天(23:59:59) |
| 12-01 | Gemini Carbon 涨到 $4 / $20,上下文缓存涨到 $0.20 |
| 之后 | Fable 5.2 与 Gemini 的价差从 4 倍收窄到 2 倍——「贵的就是强的」这条直觉会重新变得不成立 |
一句话的实用结论:这一周的价格表不是让你换供应商,是让你把「什么活值得用最贵的模型」这件事算清楚。难的活按次付费,简单的活按量付费,能挪到深夜的批量活就别在白天跑。
延伸阅读
- Claude Fable 5.2 / Mythos 5.2 发布:1000 个 Agent 花 30 小时证完费马大定理
- Gemini 4 Argon 全解:输出上限拉到 100 万 token
- Meta Muse Ember:每百万 token 输入 0.10 美元的另一条便宜路线
数据来源
- Google:Gemini 4 Carbon 发布稿(blog.google,2026-11-10);Gemini 开发者 API 定价页(ai.google.dev,2026-11-12 读取)
- Anthropic:Claude Fable 5.2 与 Mythos 5.2 发布稿与基准表(anthropic.com,2026-11-09)
- 百度:ERNIE 5.5 Flash Preview 发布页(ernie.baidu.com,2026-11-11);千帆产品页限时特惠价格标准(cloud.baidu.com,2026-11-12 读取)
- 阿里云:qwen4-max-preview 模型文档(docs.bailian.console.aliyun.com,2026-11-12 读取)
- 汇率:open.er-api.com 当日 USD→CNY(1 美元 ≈ 6.69 元),仅用于量级换算