一句话总结
11 月 9 日,Meta Superintelligence Labs 发布 Muse Ember,定位非常清楚:不是最强的模型,而是Agent 一天要调用几百次的那一档。价格 $0.10 输入 / $0.50 输出(每百万 token),缓存输入低到 $0.004;在 Artificial Analysis 的智能指数上它拿到 36 分左右,和 Claude Haiku 5.5 基本同档,但跑完一个评测任务只要 $0.14,Haiku 要 $0.41。企业工作流类评测 AutomationBench-AA 上的差距更直接:37.8% 对 13.9%。同一天,Anthropic 给旗舰降价、Google 调价、ClickUp 与 Apple 改计费——十一月的主题不是「谁更聪明」,而是**「每美元能换多少智能」**。
数据来源:Meta AI 研究博客《Introducing Our Smallest, Most Efficient Model: Muse Ember》(2026-11-09)、Artificial Analysis Intelligence Index v5(2026-11-09 口径,由 Meta 引用)、Google Gemini Enterprise Agent Platform 模型页、The Next Web 与 Economic Times 同日报道、FourWeekMBA 对 11 月 9 日五起动价动作的汇总。
图源:research.meta.ai/blog/muse-ember 官方博客
它到底便宜在哪:三个价位,一个缓存价
先把钱的账摊开(每百万 token):
| 项 | 价格 |
|---|---|
| 输入 | $0.10 |
| 缓存输入 | $0.004 |
| 输出 | $0.50 |
对照一下同价位的两位对手:Claude Haiku 5.5 与 GPT-6 Luna 的挂牌价与它同档(都是 $0.10 / $0.50 一线)。也就是说,单价已经不是差异点,差异在「跑完同一个任务要用掉多少 token」——这才是 Meta 这张牌真正的着力处。
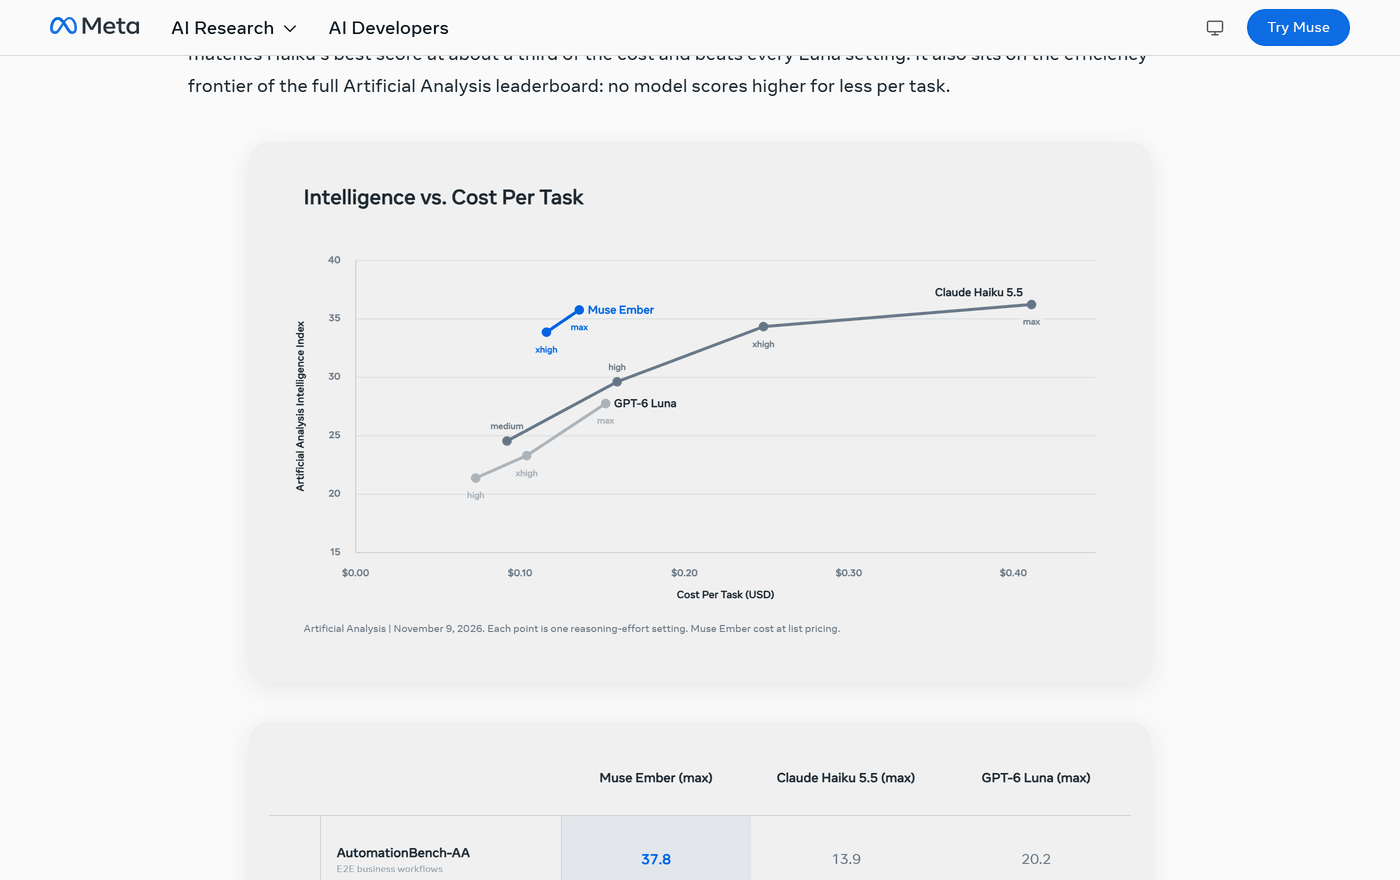
图源:research.meta.ai/blog/muse-ember,数据源 Artificial Analysis Intelligence Index v5(2026-11-09)
图表读法很直白:横轴是每个任务的花费,纵轴是智能指数。Muse Ember 的三个推理档位挤在左下角一小块($0.116 → 33.9 分,$0.136 → 35.8 分),而 Haiku 5.5 要走到 $0.411 才拿到 36.2 分,Luna 花到 $0.152 也只有 27.8 分。
Meta 的说法是它「整条 Artificial Analysis 排行榜的效率前沿上,没有模型用更少的花费拿到更高分」——这句是自我宣称,但至少曲线形态支持它站在效率这一侧。
榜单:它并不全面更强,而是「在便宜的档位上更有用」
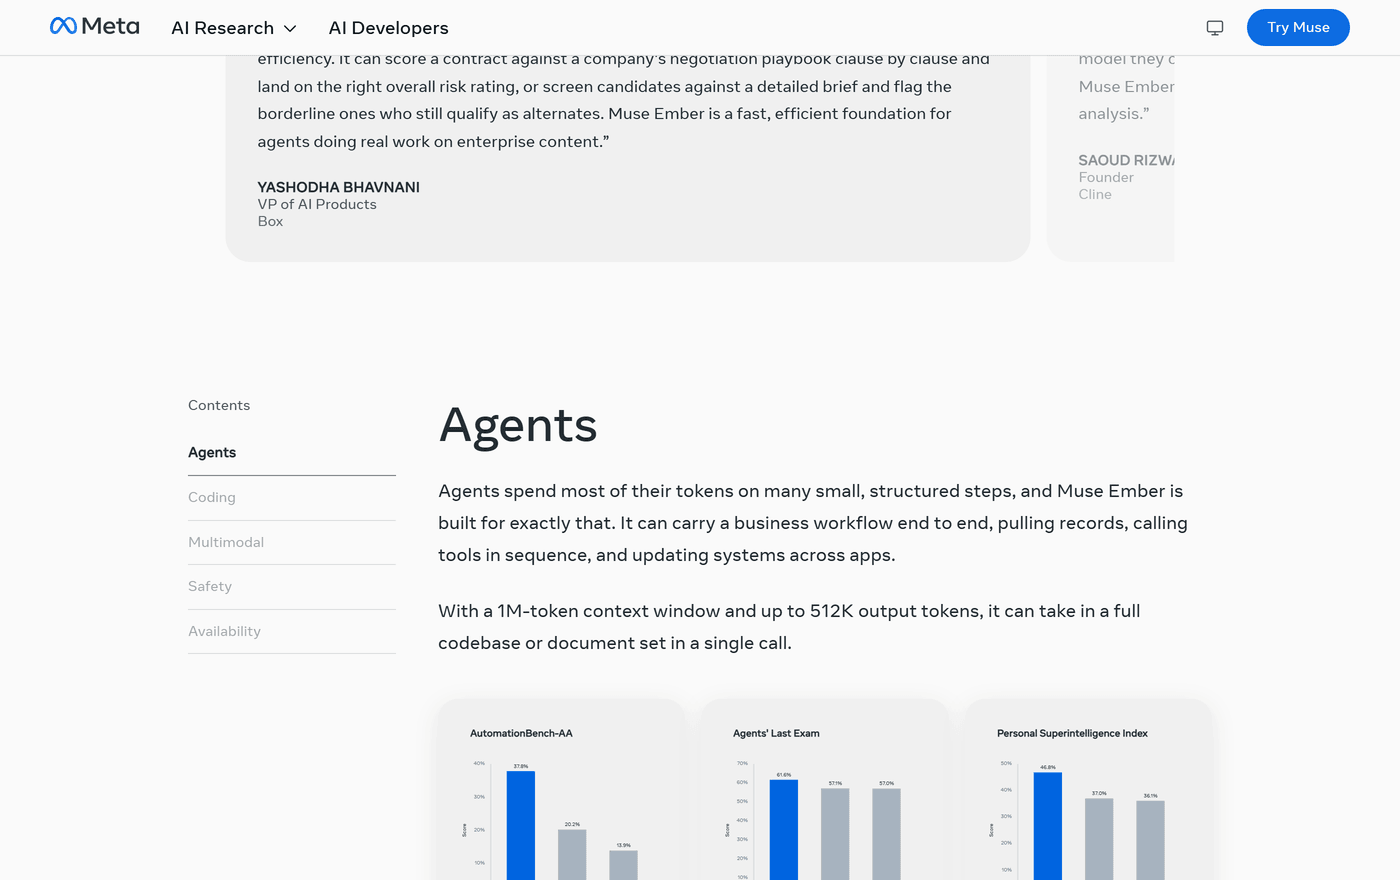
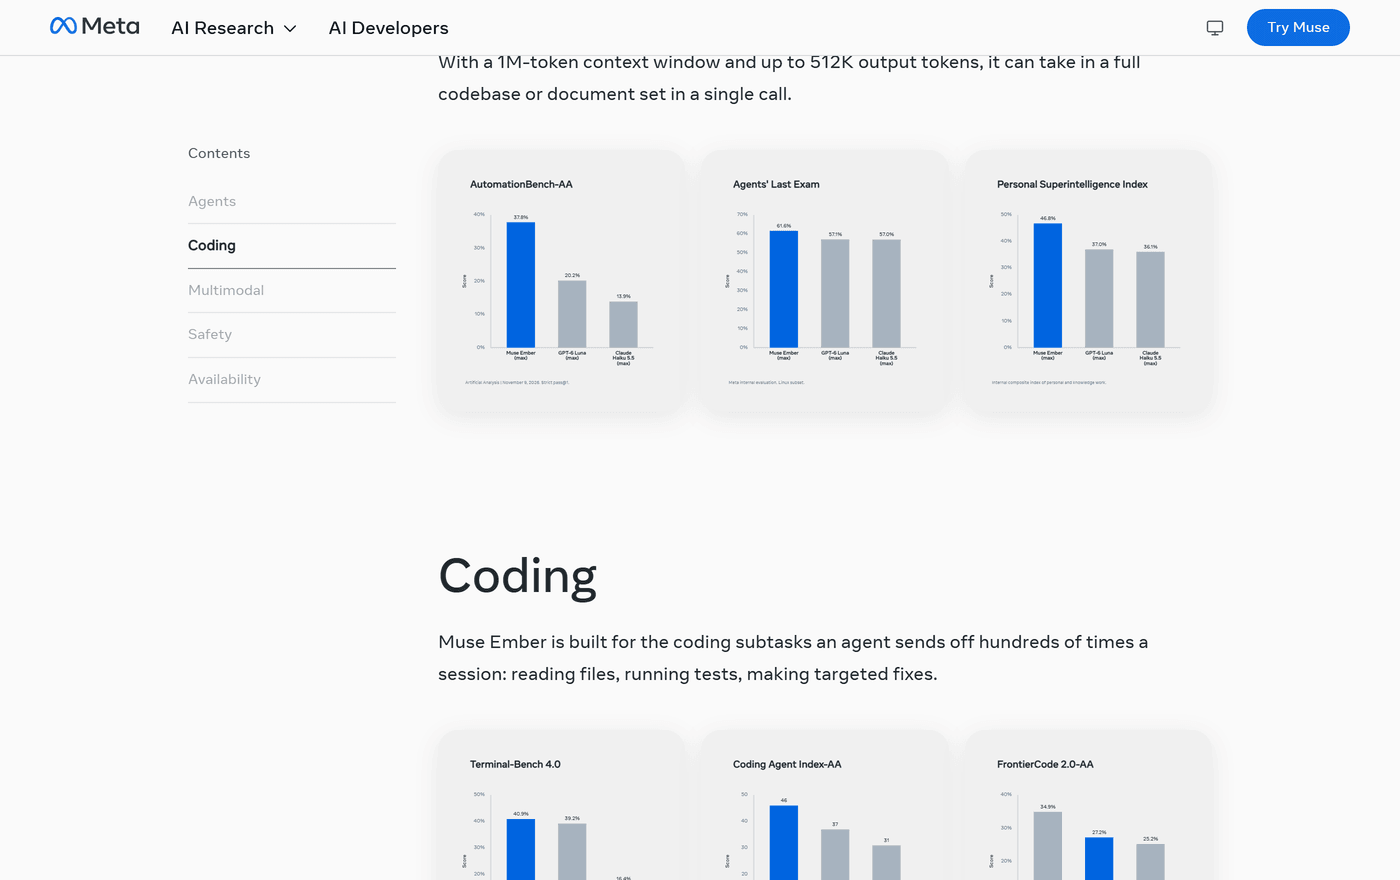
官方给了三组 Agent 相关评测(柱状图顺序为 Muse Ember / GPT-6 Luna / Claude Haiku 5.5):
| 评测 | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| AutomationBench-AA(端到端业务流程) | 37.8% | 20.2% | 13.9% |
| Agents’ Last Exam | 61.8% | 57.1% | 57.0% |
| Personal Superintelligence Index(内部复合指标) | 46.8% | 37.0% | 36.1% |
真正的信号在第一行:AutomationBench 测的是「把一条业务流程从头跑到尾」——拉记录、按顺序调工具、跨应用更新系统。这是 Agent 落地最真实的形态,而 37.8% 对 13.9% 不是小数点级别的差别,是接近三倍。
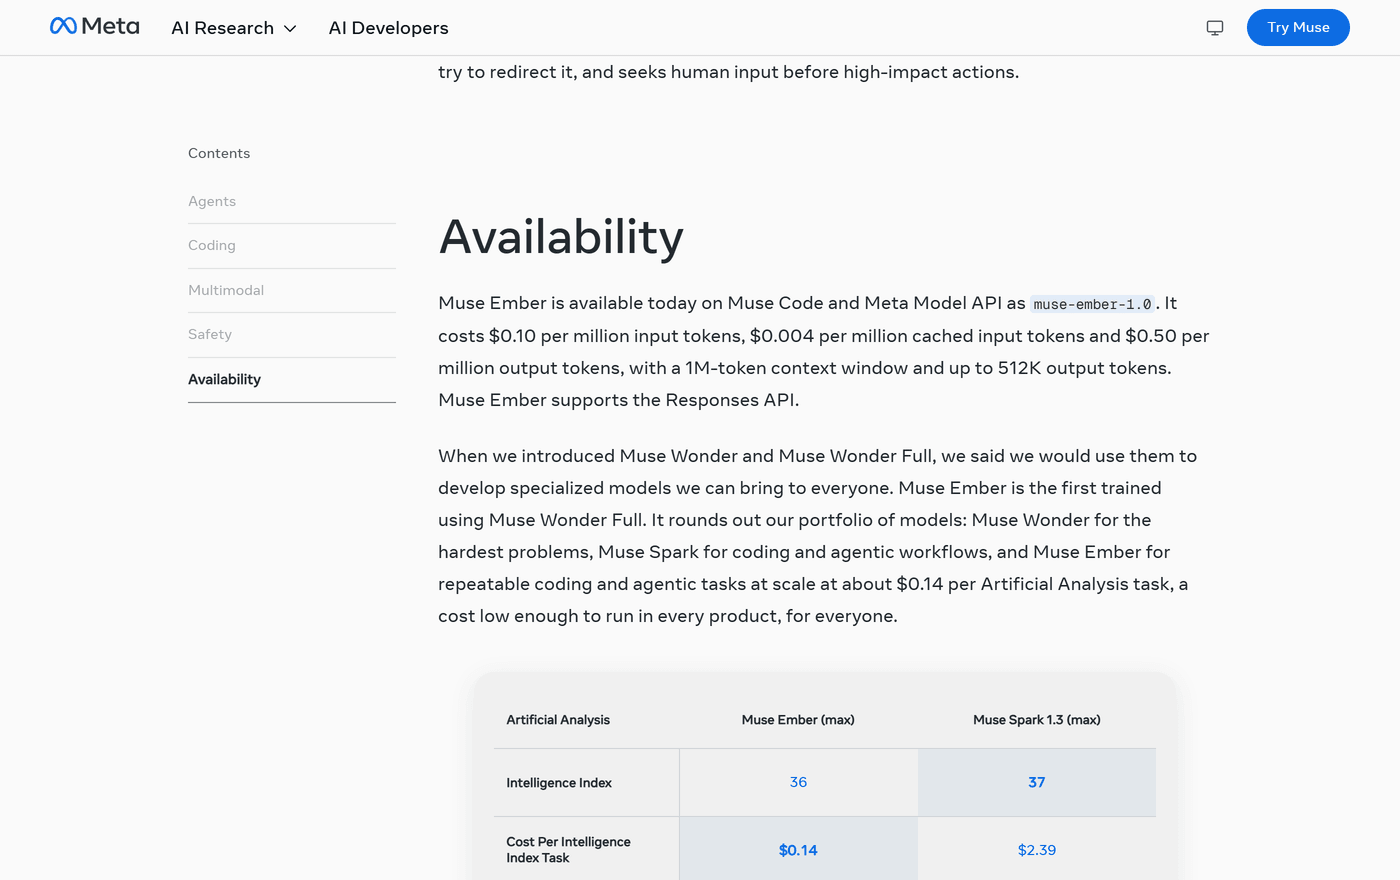
同一批数据里也有一个诚实的对位:Meta 自己的 Muse Spark 1.3 是 37 分,比 Ember 的 36 分高一点,但每个任务要花 $2.39——Ember 便宜 17 倍。这就是它整篇博客的论点:便宜档位的模型该拿来干活,不是拿来回味参数。
图源:research.meta.ai/blog/muse-ember「Agents」段
规格:这一档也给了 1M 上下文和 512K 输出
小模型过往的默认设定是「上下文砍一刀、输出砍两刀」,这次反过来了:
- 1M token 上下文,官方说「一次调用就能吃下一整个代码库或整套文档」;
- 最多 512K token 输出——这个数字在同价位里罕见,意味着它能一次吐出完整的重构补丁或长报告;
- 原生多模态:文本、图像、音频、视频同吃,可以看截图、读图表、扫扫描件,也可以从语音备忘和会议录音直接开工,不需要再挂一个语音转写或 OCR 模型;
- 支持 Responses API,模型 id 是
muse-ember-1.0,已在 Meta Model API 与 Muse Code 上线。Google 的 Gemini Enterprise Agent Platform 也在同一天把它列为 partner model(Preview,输入上限 1,048,576、输出 524,288 token)。
对做 Agent 的团队来说,「缓存输入 $0.004」比挂牌价更值得算:Agent 循环里每一步都要把同一份系统提示、工具说明、代码索引重新塞进去,这部分几乎全是缓存命中。$0.004 意味着缓存命中的输入比新鲜输入便宜 25 倍——把上下文稳定住、少改系统提示,账单能再掉一截。
图源:research.meta.ai/blog/muse-ember「Coding」段
编码类评测上它同样站稳在便宜档前列:Coding Agent Index-AA 46 分(Luna 37、Haiku 31)、FrontierCode 2.0-AA 34.9%(27.2%、25.7%)。这些数字离旗舰很远,但对「读文件、跑测试、做定点修复」这类 Agent 一口气派几百次的小活,够用且便宜。
它是怎么来的:用最强的模型当老师
Meta 的说法是:Muse Ember 是第一个用 Muse Wonder Full 训练出来的模型。翻译成人话——他们先做出最强的 Wonder,再用它去教一个小的。产品线因此排得很清楚:
- Muse Wonder / Wonder Full:最难的问题;
- Muse Spark:编码与 Agent 工作流;
- Muse Ember:可重复的编码与 Agent 任务,规模化跑。
扎克伯格在 X 上的表述更直接:「Muse Wonder plans, Muse Ember handles the volume.」(Wonder 负责规划,Ember 负责量。)这句话其实点出了 2026 年 Agent 系统的主流架构——一两台「大脑」加一群「手」,钱要花在调度的正确性上,不该花在每一次工具调用的思考上。
安全侧,Meta 说发布前按 Meta Superintelligence Scaling Framework 做了评估,覆盖化学与生物、网络安全、失控风险三类,Ember 都在高风险阈值以下;同时强调它对「藏在网页、文档或工具输出里的指令」有抵抗力——这条对天天把网页内容喂给模型的 Agent 尤其重要。
图源:research.meta.ai/blog/muse-ember「Availability」段
一天五起动价:这个行业开始按「用掉多少」收钱了
同一天(11 月 9 日)发生的不止这一件:Anthropic 把旗舰价从 $10/$50 降到 $8/$40;Google 有模型调价;ClickUp 与 Apple 也各自改了 AI 计费方式。FourWeekMBA 把这一天总结成五起定价动作,全部按用量计费(token、调用、credits 或预付费包),并算出一笔账:Ember 的价格比 Meta 自家的 Muse Wonder 低约 40 倍。
这条趋势对普通用户的传导路径是这样的:模型厂商按 token 收钱 → 应用厂商按调用收钱 → 订阅制被拆成「额度」。你在产品里看到的「每月 N 次高级请求」,就是这么来的。
对国内团队的实际选择
- 便宜的档位才是主战场:如果你的 Agent 每天要跑几千次工具调用,Ember 这类 $0.10/$0.50 的档位比旗舰省一到两个数量级;把「规划」留给贵模型、把「执行」交给便宜模型,是当下最划算的分工。
- 它把同价位的竞争拉到了「每任务成本」:DeepSeek V4.1 Flash、GLM 5.3 Flash 都在这一档,Meta 对外也强调自己与它们「在成本上有竞争力」(这一条来自媒体转述,Meta 官方博客没有直接点名)。国内团队真正的选择不是「哪个更聪明」,而是接入成本 + 缓存价 + 长上下文这三项加起来谁更便宜。
- 1M 上下文 + 512K 输出改变了用法:以前「把整个仓库塞进去」是旗舰模型的特权,现在便宜档也能做,值得重新算一遍「RAG 还是全量喂」的账。
- 别指望它顶旗舰:46 分的 Coding Agent Index 和旗舰的 49.1% FrontierCode 不在一个赛道。它是让 Agent 跑得起的那一档,不是让 Agent 想得对的那一档。
总结
- 发布:Meta Superintelligence Labs 于 2026-11-09 发布 Muse Ember,模型 id
muse-ember-1.0; - 价格:$0.10 输入 / $0.50 输出,缓存输入 $0.004,1M 上下文、512K 输出、原生多模态;
- 效率:Artificial Analysis 约 36 分、每任务 $0.14;Haiku 5.5 同为 36 分档但要 $0.41,GPT-6 Luna 峰值 27.8 分;
- 真实场景:AutomationBench-AA 37.8% vs Luna 20.2% vs Haiku 13.9%;
- 定位:Wonder 做规划、Ember 做量,第一个由 Muse Wonder Full 教出来的小模型;
- 行业信号:11 月 9 日一天五起 AI 定价动作,全部转向按用量计费。
数据与图片出处:价格、规格、评测数字与客户引述取自 Meta AI 研究博客《Introducing Our Smallest, Most Efficient Model: Muse Ember》(2026-11-09),其中 Artificial Analysis 相关数值为 Meta 引用的 Intelligence Index v5(2026-11-09)口径;Gemini Enterprise 平台规格取自 Google Cloud 文档模型页;五起定价动作的汇总来自 FourWeekMBA,属第三方整理;「与 DeepSeek V4.1 Flash、GLM 5.3 Flash 成本竞争」一说来自 Economic Times 转述 TechCrunch,非 Meta 官方表述。正文截图为 Meta AI 官方博客(2026-11-10 取自官网)。