一句话总结
10 月 12 日,Meta 的 Superintelligence Labs 发布了 Muse Wonder 与 Muse Wonder Full,这是 Scale AI 创始人 Alexandr Wang 接手重组 Meta AI 之后,Meta 交出的第一款前沿模型。它没有去打「最聪明」这个标签,而是把赌注押在个人智能体上:主动记忆(Active Memory)与持续聚焦(Active Focus)。按 Meta 自己的测试,它在记忆、专业代理任务和长周期编码上都领先,但在通用智能指数和终端编码上仍落后 Claude Opus 5.5 与 GPT-6 Astra。定价 $4 / $20 每百万 token——而最强的那一档 Wonder Full 只对 Muse Code 订阅者开放,不进 API。
数据来源
本文事实来自:Meta 官方博客《Muse Wonder: A Frontier Model For Personal & Professional AI Agents》(research.meta.ai,发布于 2026-10-12);随模型同步发布的 Muse Wonder Model Card(13 页 PDF,首页标注发布日期 2026-10-12、模型主页 dev.meta.ai);TechCrunch 报道《Meta releases its first frontier model, Muse Wonder》(2026-10-12);The Verge 报道《Meta says the models compete with the industry’s best and will soon power its Muse agent》。文中所有基准数字都来自 Meta 模型卡与其官方博客所附的图表,属于厂商自测口径;模型卡本身列出的对标运行由 Meta 内部执行,其「局限」章节也承认对标配置是 best-effort。第三方可核实的信息(发布节奏、定价、开闸范围)与厂商自报性能主张,本文分开表述。
「第一款前沿模型」这句话背后的 14 个月
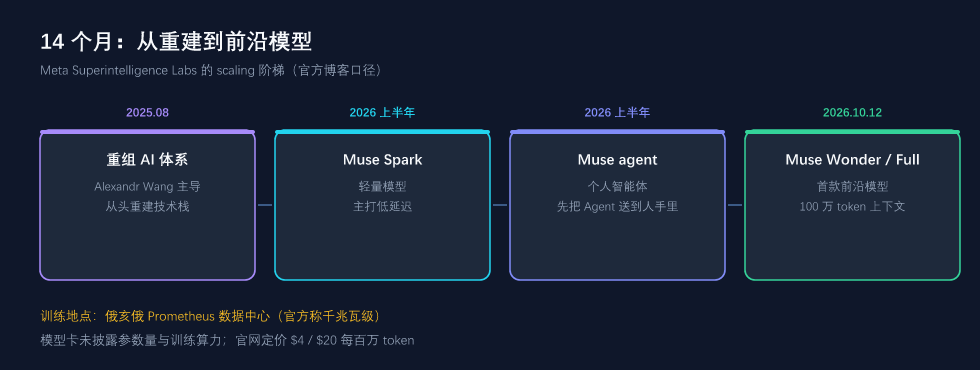
官方博客开头给了一个时间坐标:「十四个月前,我们开始对人工智能工作做一次从零开始的重建。」 这句话对应的时间点,正是 Scale AI 创始人 Alexandr Wang 主导重组 Meta AI 体系的那一段。之后 Meta 的路线很清楚——先用 Muse Spark 把轻量、低延迟的模型铺开,再用 Muse agent 把智能体送到用户手里,最后才是前沿模型。
TechCrunch 的措辞是「Meta 在 AI 竞赛里补回失去的时间」:在这之前,Meta 一直回避 OpenAI 与 Anthropic 那种旗舰级发布。这次发布的两款模型训练在俄亥俄州的 Prometheus 数据中心——官方称其为千兆瓦级,今年早些时候才上线。
所以这一次发布的真正信号不是某一项跑分,而是Meta 回到了「自己训练旗舰模型」这条赛道上。
什么让 Meta 敢说「前沿」:一张自测总表
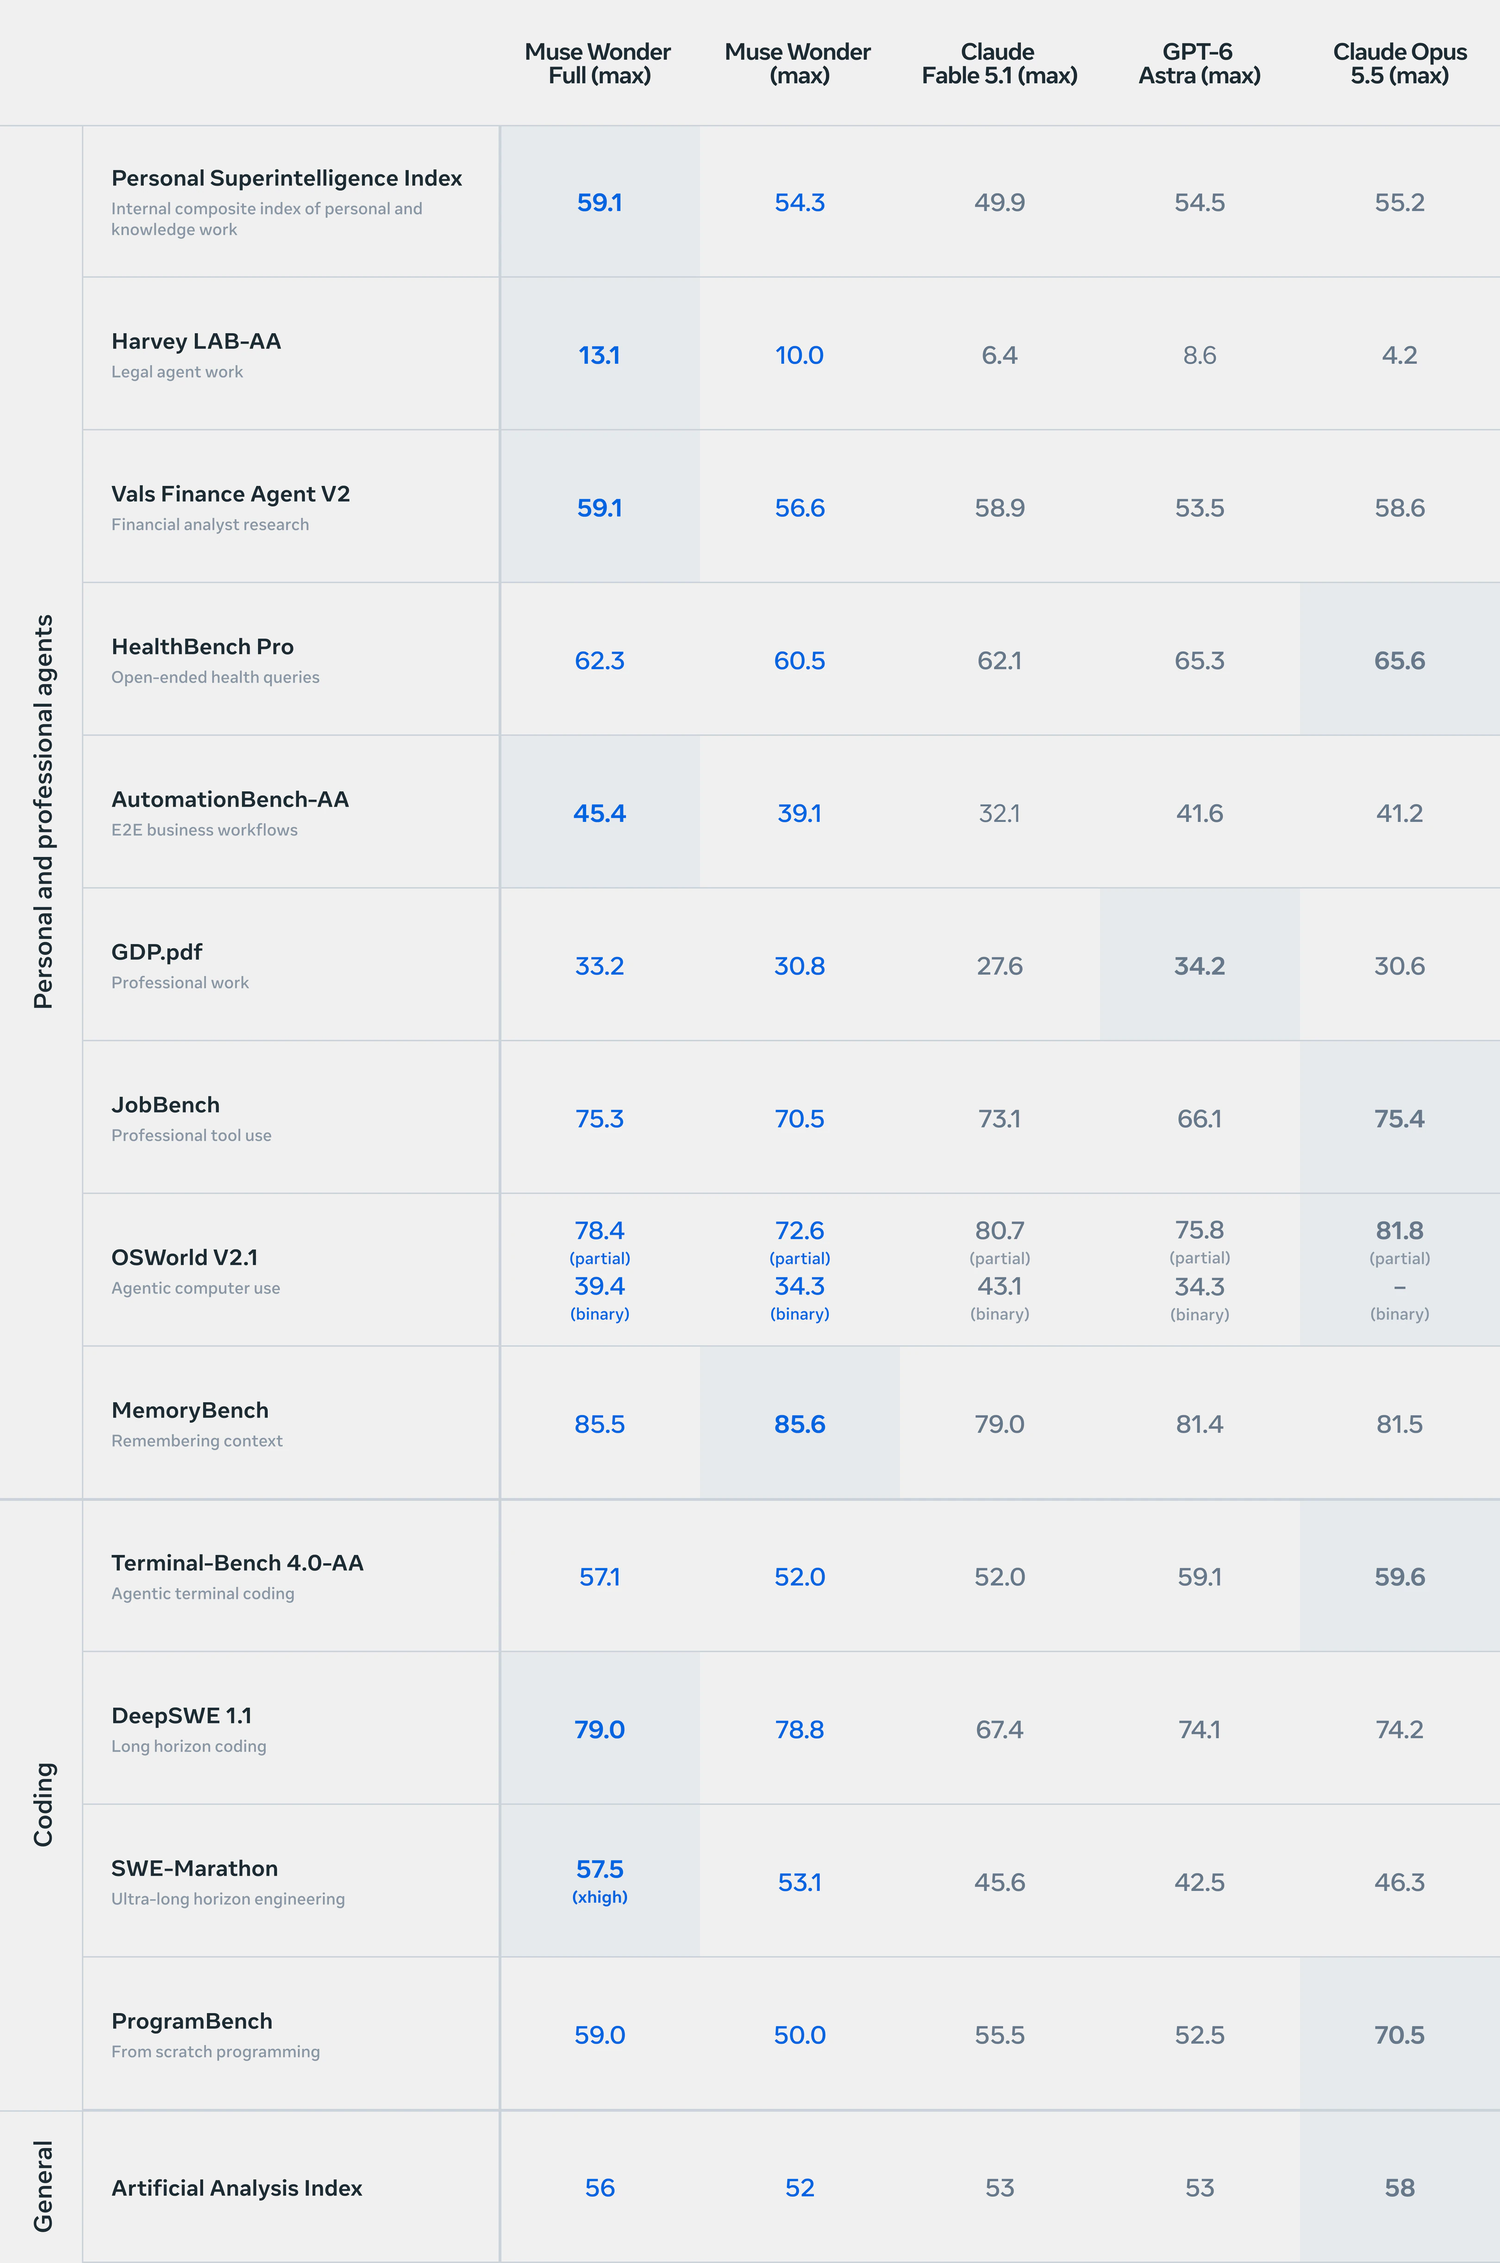
这张表是这次发布的核心证据。五个模型列全部是 max reasoning effort 档,横跨个人/专业代理、编码、通用三大类:
- 个人与专业代理:Personal Superintelligence Index 59.1(对比 Opus 5.5 的 55.2、GPT-6 Astra 54.5、Fable 5.1 的 49.9);法律代理 Harvey LAB-AA 13.1,是第二名 Astra(8.6)的 1.5 倍以上;业务流程 AutomationBench-AA 45.4 居首。
- 记忆:MemoryBench 85.5 / 85.6(Wonder / Wonder Full),领先 Opus 5.5 的 81.5 与 Astra 的 81.4。
- 编码:DeepSWE 1.1 79.0、SWE-Marathon 57.5,两项都明显领先——后者考察超长周期工程任务。
- 通用与部分专业项仍然落后:Artificial Analysis 智能指数 56,低于 Opus 5.5 的 58;Terminal-Bench 4.0-AA 57.1,低于 Astra 的 59.1 与 Opus 5.5 的 59.6;ProgramBench 59.0,远低于 Opus 5.5 的 70.5;HealthBench Pro 62.3,低于 Astra 的 65.3。
一句话概括这张表:Meta 赢在「代理类」任务,输在「通用与终端」任务。
差异点一:把「记得住」做成产品能力
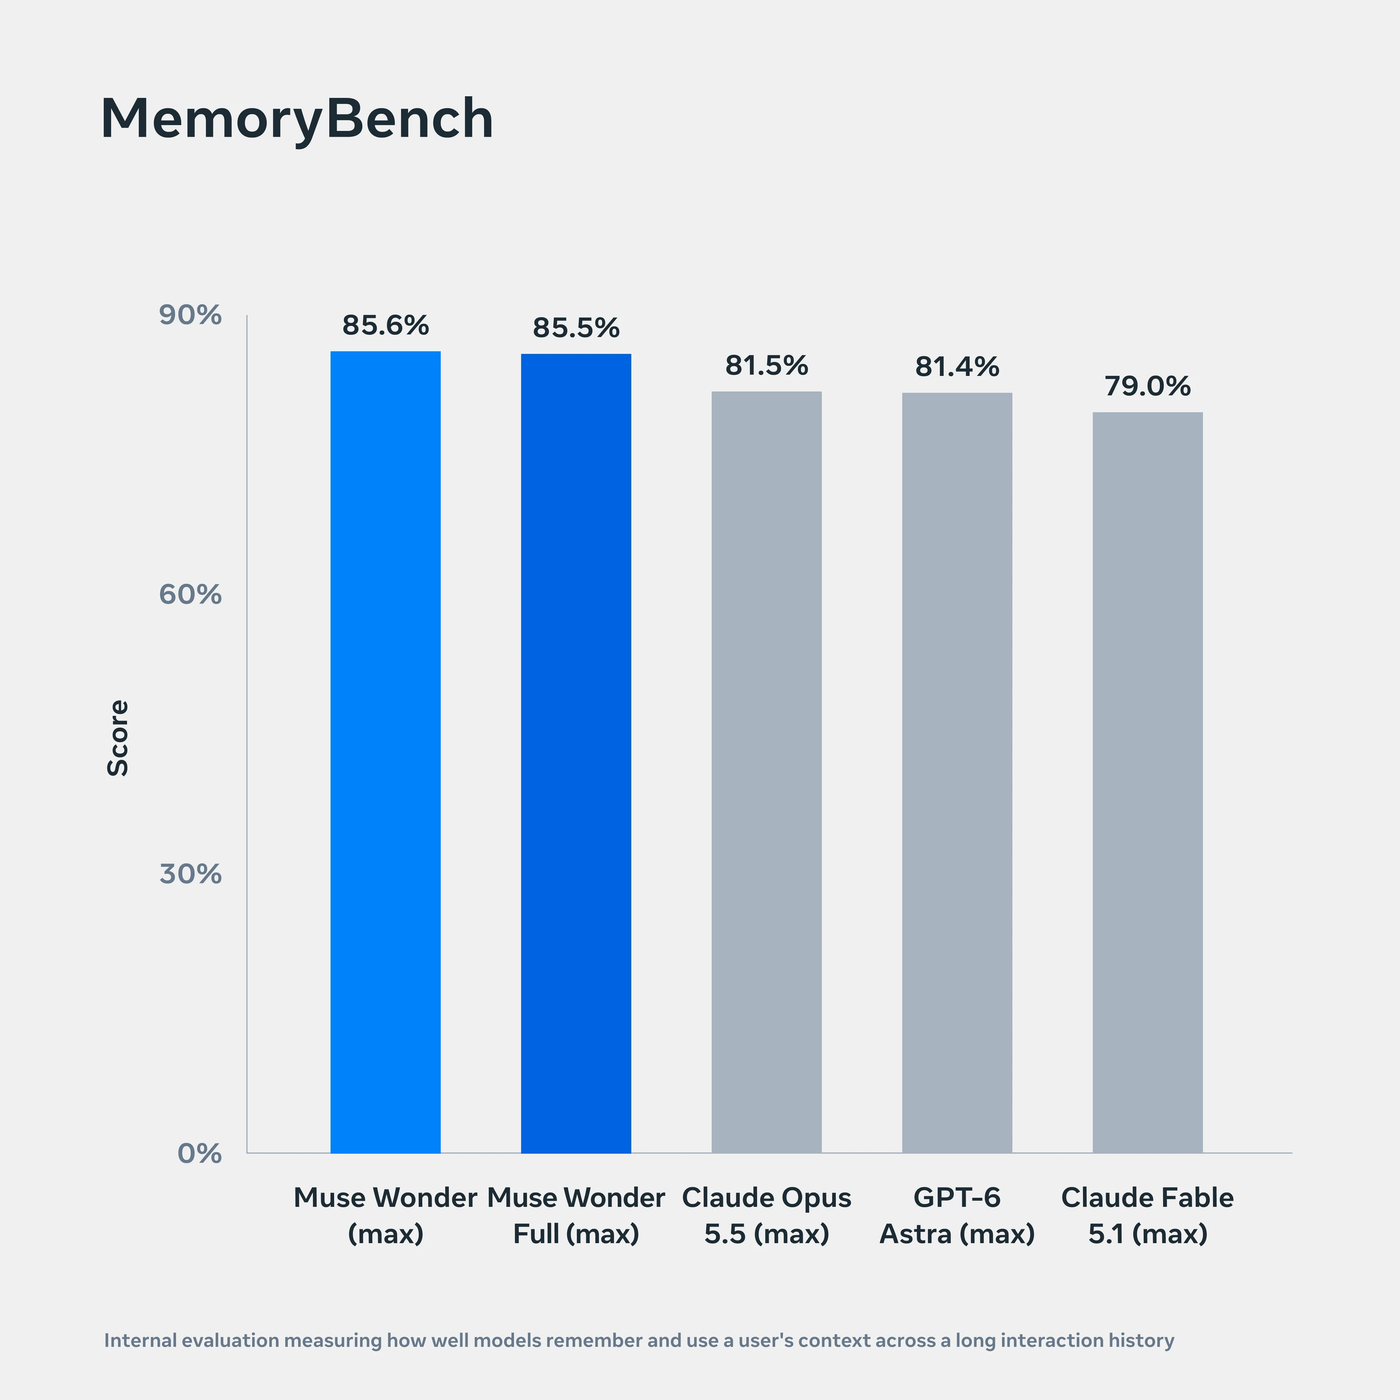
官方把这一段称作 Active Memory(主动记忆):不只是把上下文塞满,而是把重要信息带过对话边界,并在需要时主动检索出来。模型卡里给出的 MemoryBench 是内部基准,测的是模型在 64K 到 100K token 的长多轮对话中能否准确回忆关键事实——对话里还掺入了干扰对话,以及与目标信息冲突、或后来更新了目标信息的注入轮次。评判由 LLM judge 按加权评分标准执行。
配套的另一个词是 Active Focus(持续聚焦):模型卡把它描述成「继续朝一个有难度的目标工作——尝试替代方案、绕过阻塞、适应新信息」,过程中需要时会主动请求澄清,并在执行重要动作前先确认。这两件事合起来,就是 Meta 对「个人智能体」的定义。
官方博客在这部分写了一句听起来像营销、但其实是技术判断的话:
两个模型常常基准分数接近,可其中一个在处理大量陌生任务时明显更稳。
他们把自己的内部评估工具 FocusBench(住房、旅行、IT、金融等日常代理任务,考察跨多轮交互推动真实阻塞的能力)放进了 Personal Superintelligence Index 这个复合分里——上表第一行 59.1 就是它。
差异点二:编码是这次最硬的长板
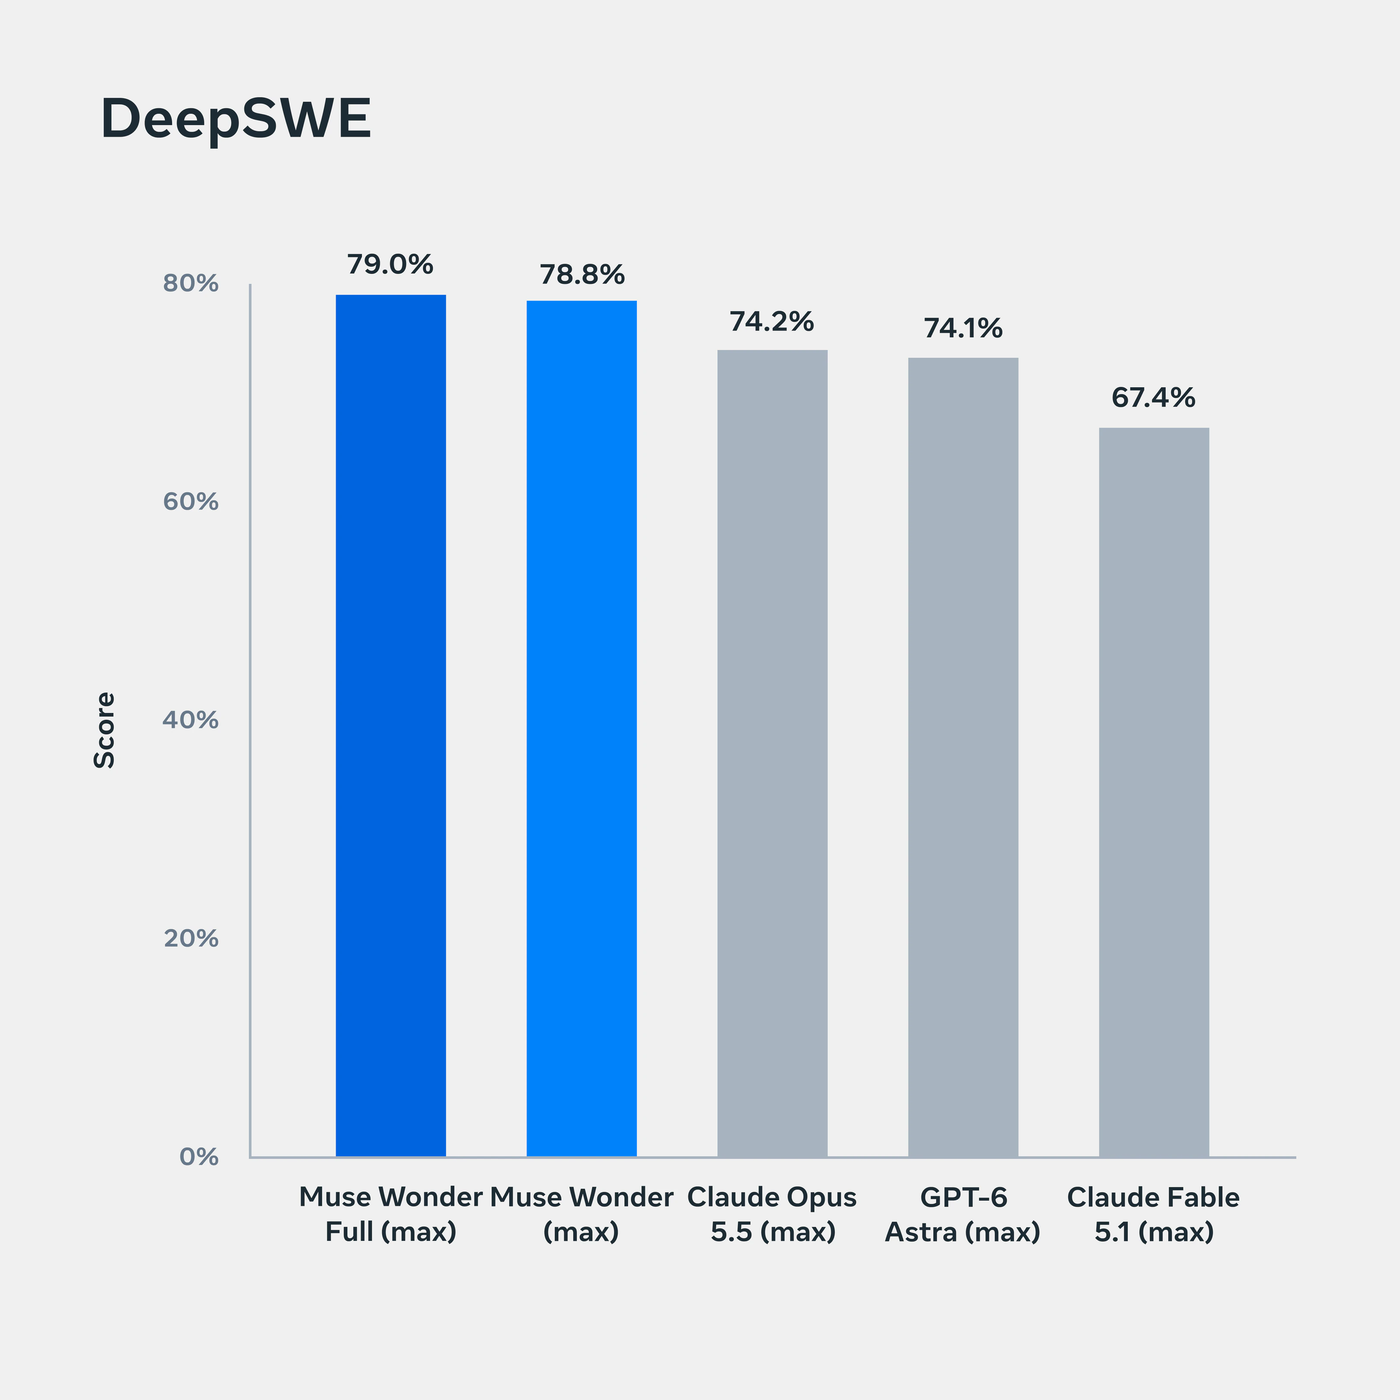
编码是这张表里差距最明显的一栏。DeepSWE v1.1 是长周期软件工程基准(113 个任务、91 个仓库、5 种语言),按 pass@1 计分:79.0 / 78.8 对 Opus 5.5 的 74.2。更极端的例子是 SWE-Marathon(超长周期工程项目、直接跑项目测试):57.5 对 Opus 5.5 的 46.3、Astra 的 42.5。
模型卡对这两行的口径写得很细,值得单独点出:DeepSWE 用的是 Datacurve 的第三方结果,GPT-6 Astra 用的是 OpenAI 自报结果;而 SWE-Marathon 那一行「不是受控的同 harness 对比」——官方注明 Astra 与 Fable 5.1 的分数分别跑在 Codex 与 Claude Code 上。这也是下文的第一个问号。
官方主动讨论「刷榜」与「域外泛化」
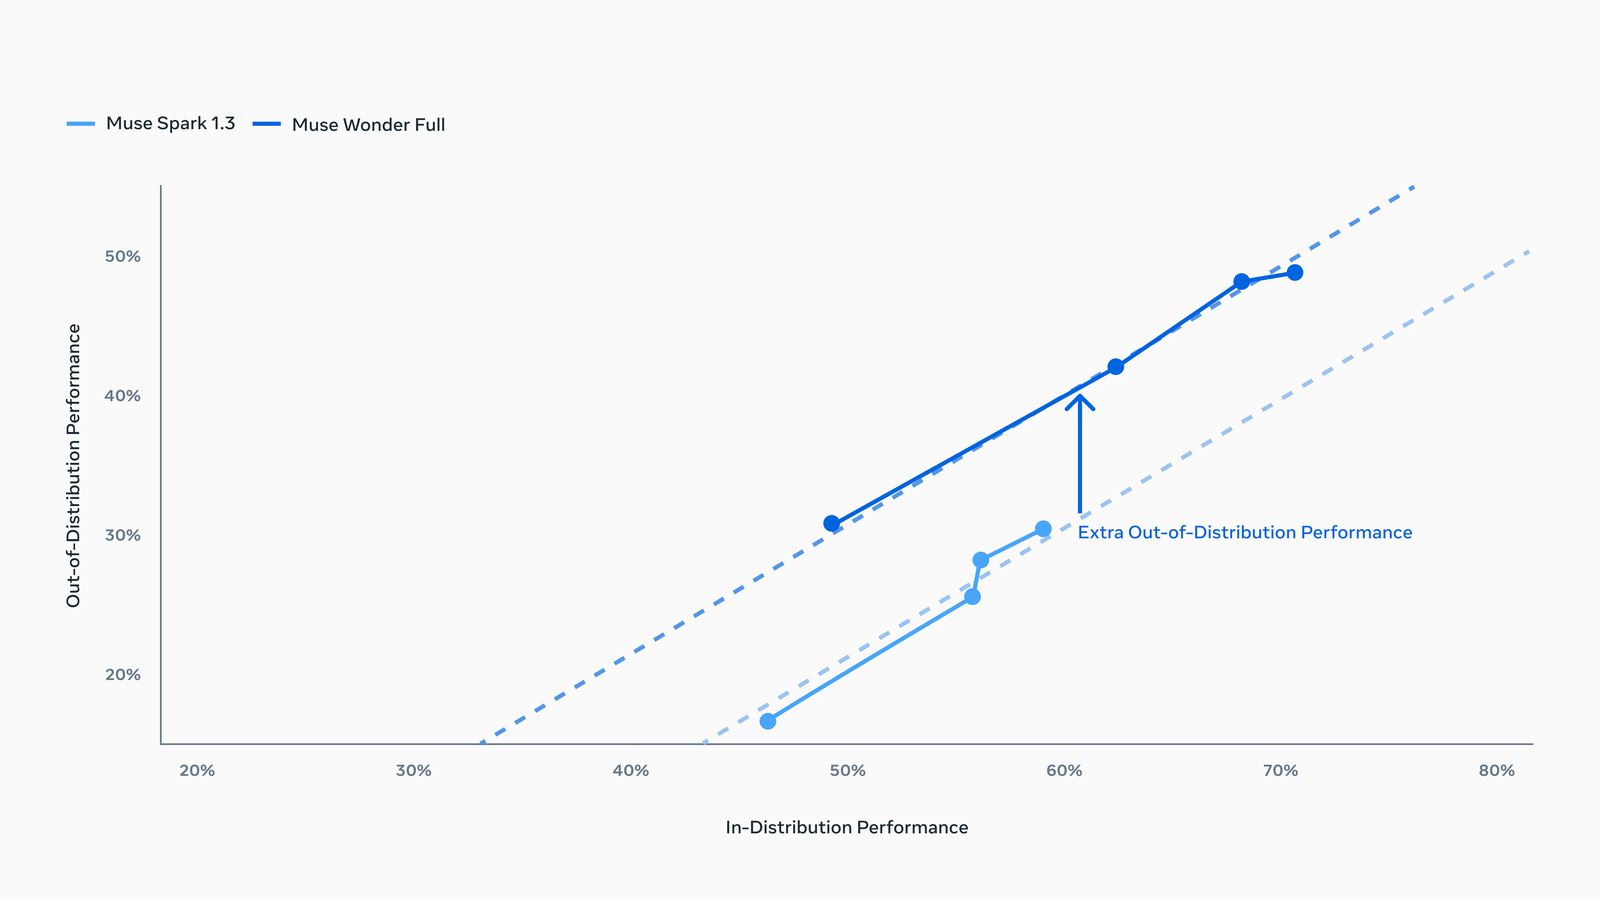
这段是这份发布里最有意思的部分。官方直接点了两个圈内黑话——「benchmaxxing」(刷榜)与「big model smell」(大模型的味道)——并说两者其实都在描述同一件事:两个模型跑分接近,但一个能覆盖明显更宽的陌生任务。
为量化这个偏差,官方用一张图比较 Muse Spark 1.3 与 Muse Wonder Full:横轴是后训练阶段重点做过的那类任务的合成分数(分布内),纵轴是后训练阶段没有特意做过的一类任务的平均分(分布外),每个点代表一个不同的推理投入档位。结论是:随测试时算力增加,两个模型在分布外任务上都上升;但给定相同的分布内表现,Wonder Full 的分布外表现比 Muse Spark 1.3 的趋势线预测的还要高。官方把原因归给更大的底座模型:底座越强,后训练收益越能迁移到陌生任务上。
这一段值得留意,因为它等于官方承认了榜单分数和模型的实际可用半径是两件事——同时也是在解释为什么这次的主打场景是个人智能体(需要处理训练期无法穷举的目标、工具与约束组合)。
价格、开闸方式,以及模型卡的硬指标
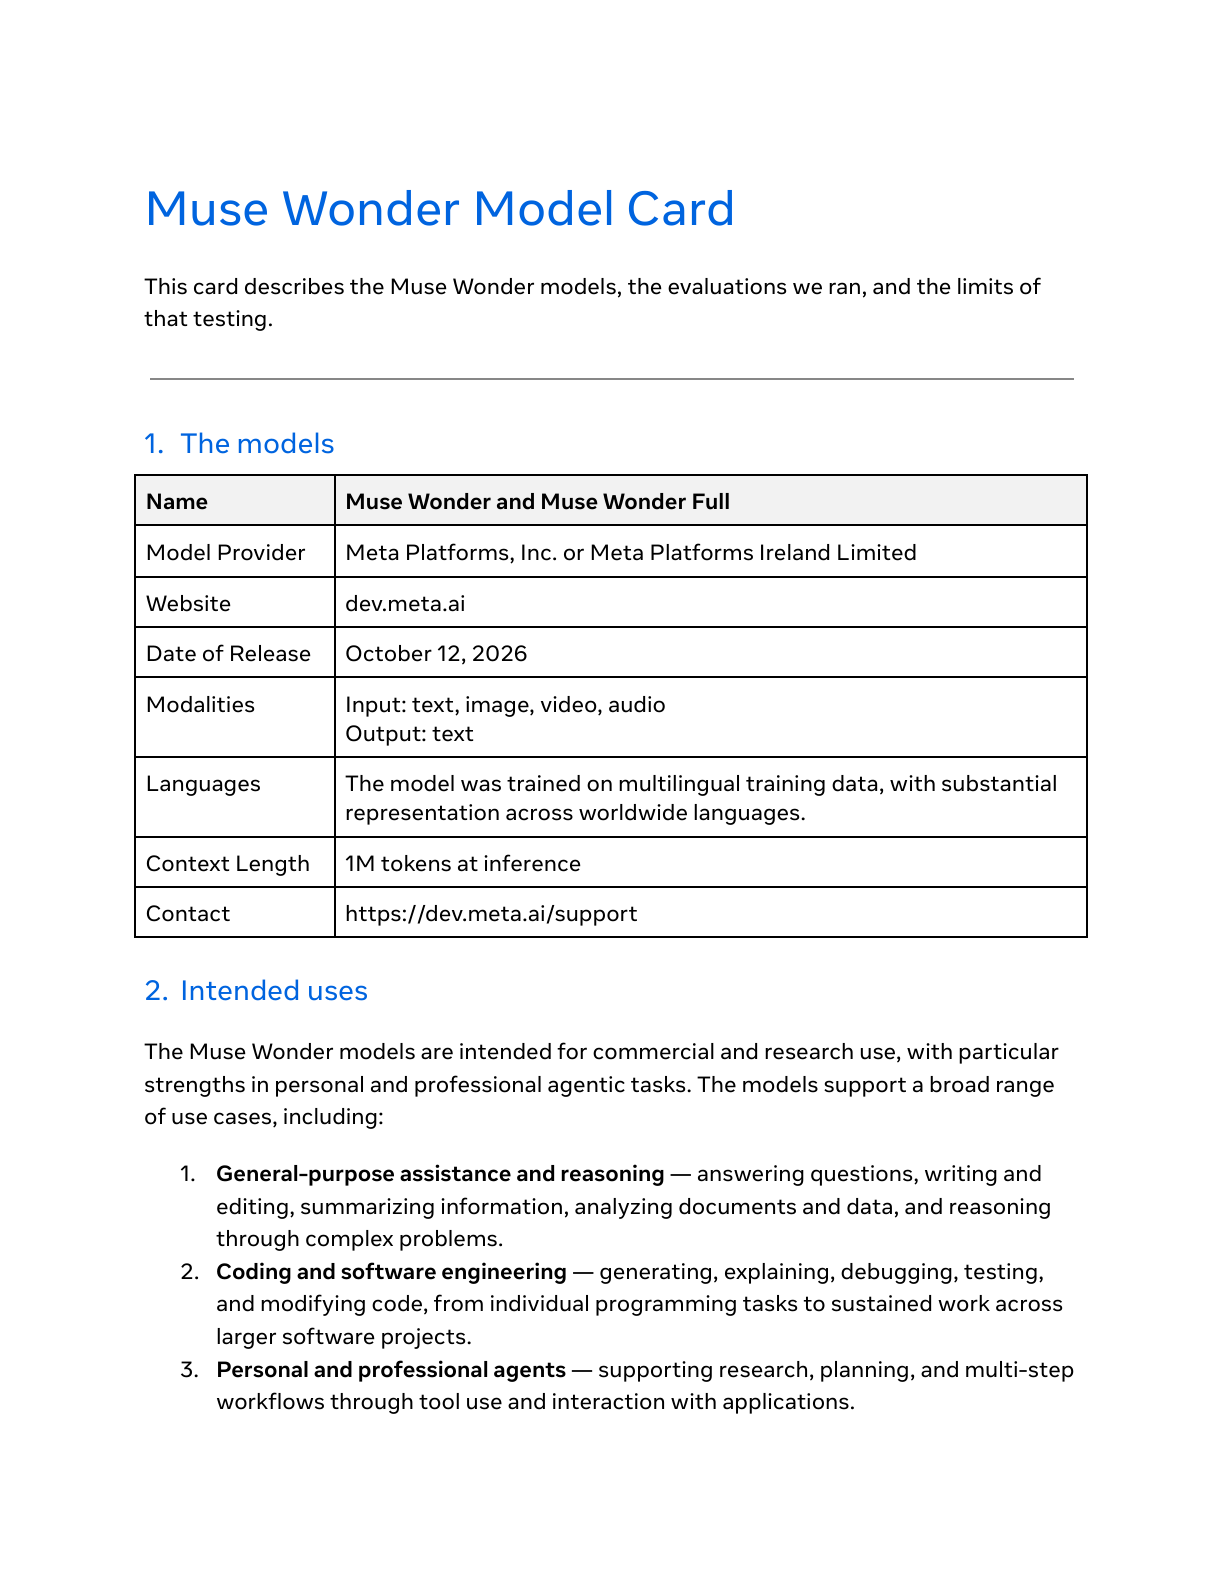
| 项目 | Muse Wonder | Muse Wonder Full |
|---|---|---|
| 获取方式 | Meta Model API + Muse Code | 仅 Muse Code 订阅者,不经 API |
| 定价 | 约 $4 / 百万输入 token、$20 / 百万输出 token | 未单独定价 |
| 上下文 | 100 万 token(推理时) | 同系列 |
| 输入模态 | 文本、图像、视频、音频(输出为文本) | 同系列 |
| 发布日期 | 2026-10-12 | 2026-10-12 |
TechCrunch 对定价的解读是「大致等于 GPT-6 Sol 或 Opus 5.5 的成本」。开闸方式是这次发布里最容易被忽略、但对开发者影响最大的一条:两款模型都会用来驱动 Muse agent,Wonder 会先向订阅者铺开,而能力最强的那档 Wonder Full 只走订阅,不提供 API。也就是说,开发者能通过 API 拿到的,不是 Meta 自测分数最高的那个版本。
模型卡里另一处值得注意的空白:13 页文档交代了名称、提供方、网站、发布日期、模态、语言、上下文长度与联系方式,但没有披露参数量、训练算力与训练数据规模。
安全自评:一处「不排除达到高风险阈值」
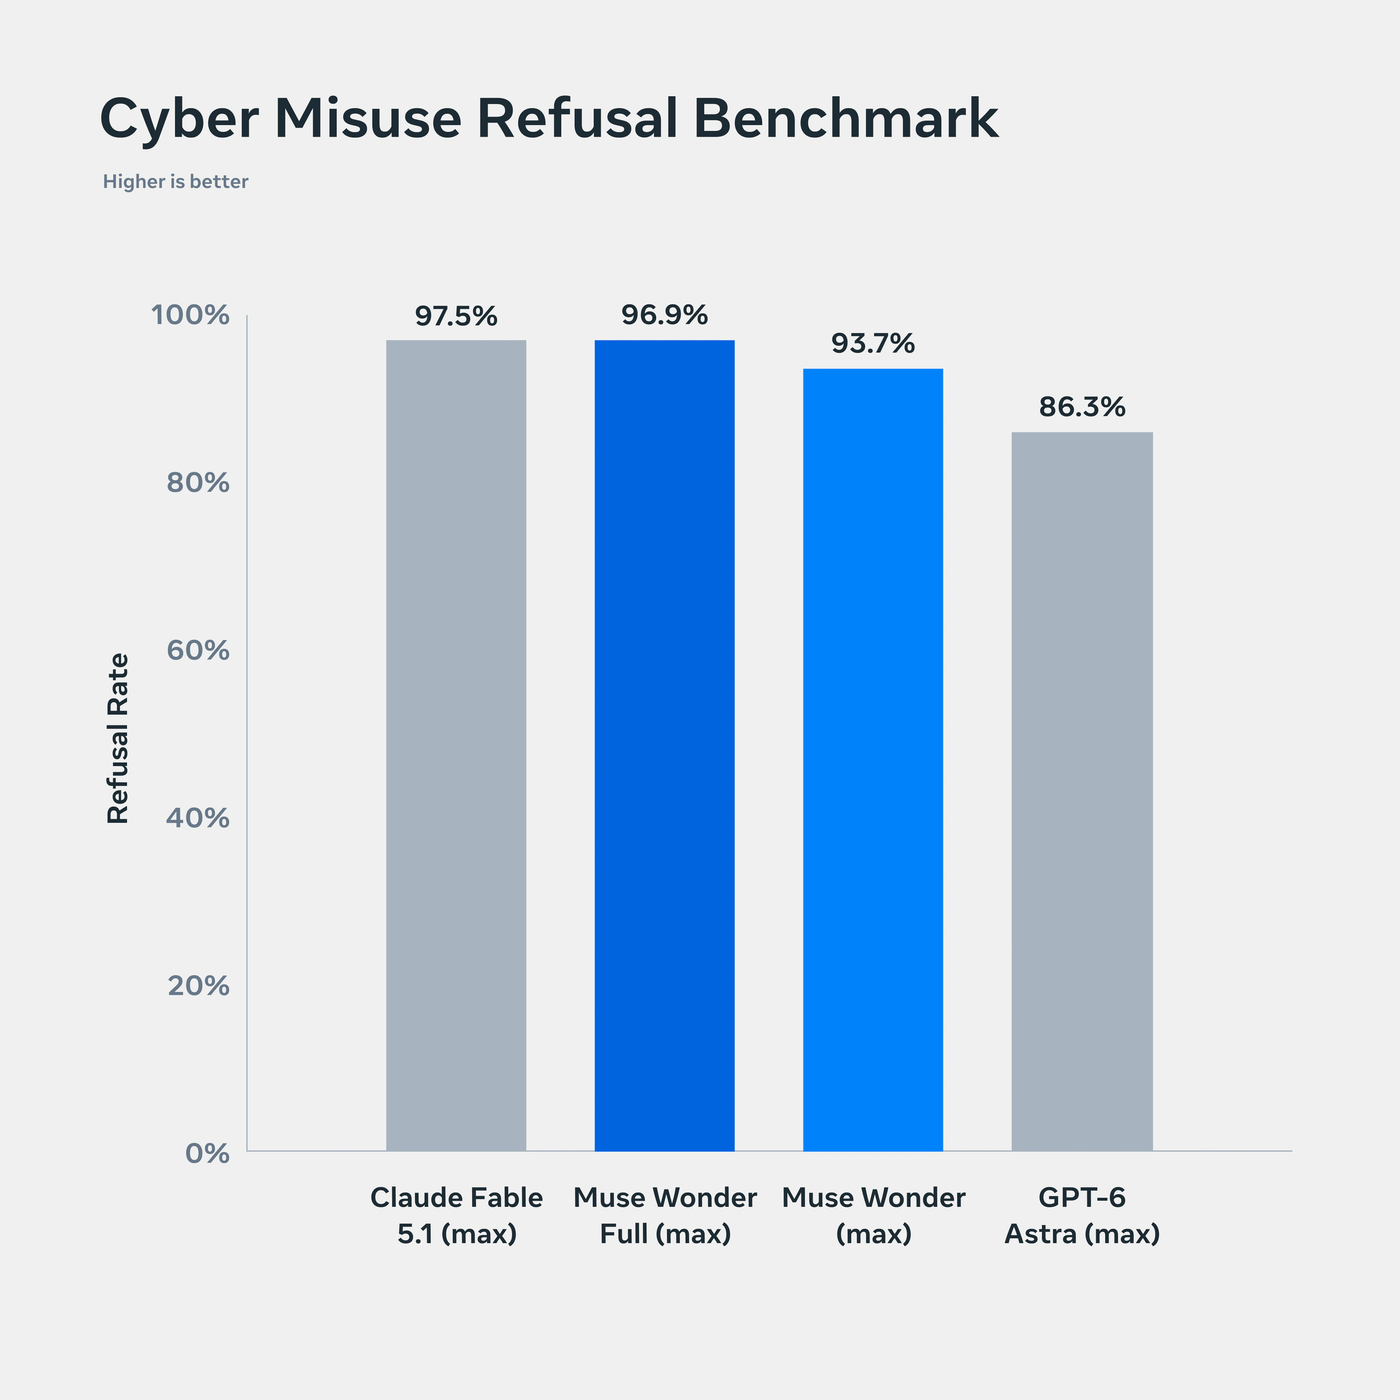
模型卡按 Meta 的 Superintelligence Scaling Framework 给出了三域评估,其中一句需要原样引用:
如果没有缓解措施,我们不排除模型在化学与生物(Chemical & Biological)域达到这一高风险阈值。
官方为此加上了域内缓解措施,包括安全后训练与系统级分类器;而在**网络安全与失控(Loss of Control)**两域,未缓解版本的评估是「moderate or lower」,加缓解后可全域维持在「moderate or lower」,这构成了部署决策的依据。
给出的具体数字包括:
- 网络能力:CyberGym 88.4%、ExploitBench 58.9%、ExploitGym 拿到 92 面旗——但官方自己注明,验证复核发现这 92 面里只有 21 面走的是预期漏洞,另外 71 面是非预期漏洞,而 ExploitGym 的公开榜只计预期漏洞,所以可与公开榜对比的数字是 21。
- 对抗性拒答(越低越好):CyberBench 单轮/多轮均为 0.8、PolyGuard 网络子集 1.1 / 2.3、RedCode 9.0 / 8.0。
- 化生拒答(越高越好):BioTIER 英文与多语言均 98.7%,对抗变形下 98.2%;内部化学拒答英文与多语言均 100%,对抗下 99.8%。
- 双用途能力:SecureBio 的 MBCT / HPCT / VCT 分别为 59.6% / 66.5% / 55.9%,平均 60.7%;Lab-Bench ProtocolQA 89.0%;ABC Bench 的碎片设计与筛选规避两项因安全训练拒答率过高而无法评分。
- 失控:MASK(抗压保持诚实)87.3%,Agentic Misalignment(为达成目标而采取有害行动的比例)0%。
官方还留了一句:「包含更多安全评估的完整报告将在不久后提供。」 也就是说这份 13 页模型卡并非终版。另外,模型卡把 3D / 空间推理、以及对训练数据未覆盖语言的表现列为已知限制。
三个需要打问号的地方
第一,几乎所有「领先」都是自测,而且模型卡自己承认了对比条件不完美。 模型卡的评估方法一节写明:内部生成的对标模型运行「是 best-effort」——prompts、工具与运行时可能没有针对专有模型做最优调校。这句话的分量不轻:它的意思是对手可能是「没调好的」对手。表中部分行(如 DeepSWE)用的是第三方或厂商自报结果,SWE-Marathon 那一行官方直接标注「不是受控的同 harness 对比」。
第二,模型卡没给底座信息。 参数量、训练算力、数据规模都没披露,官方博客也只给了「千兆瓦级数据中心」这类设施口径。而在同一周,官方叙事的关键正是「更大的底座带来更好的陌生任务迁移」——迁移能力的解释建立在一个外部无法核查的前提上。
第三,「前沿」与它的对比表之间还有距离。 通用智能指数 56 对 Opus 5.5 的 58、Terminal-Bench 4.0-AA 57.1 对 Astra 的 59.1、ProgramBench 59.0 对 Opus 的 70.5、HealthBench Pro 62.3 对 Astra 的 65.3。更实际的问题是开闸方式:最强的一档 Wonder Full 不进 API。The Verge 也提到,这次的模型如何与 Google 的 Gemini 4 Argon 对比仍不清楚(后者的能力仍在逐步公布)。
不过这三点都不改变一个事实:Meta 这次拿出的不是一款「全能冠军」,而是一款目标明确的模型——把记忆与长周期代理做到领先,然后把它塞进 Muse 这个面向普通用户的产品里。
图片出处:封面与「14 个月 scaling 阶梯」示意图由 UU AI Hub 自制;Muse Wonder 评测表、MemoryBench、DeepSWE、Cyber Misuse Refusal、分布内/分布外迁移图取自 Meta 官方博客(research.meta.ai,2026-10-12)原文配图;模型卡首页取自 Meta 官方发布的《Muse Wonder Model Card》PDF。
数据口径说明:本文基准数字均为 Meta 官方自测结果(模型卡与官方博客图表),第三方独立复现结果在本文写作时尚未公布。