一句话总结
10 月 13 日,Google 把 Gemini 4 Argon 推向 Gemini app 的 Pro / Ultra 订阅者、Search 的 AI mode、付费 API 客户,以及 agentic 开发平台 Antigravity 的 Ultra 用户。这次官方最实在的一条技术变化不是参数,而是输出 token 上限从 64K 提到 100 万——按 Google 的说法,模型因此可以在一次轨迹里连续生成几十万个 token 做长周期推理。成绩单上,DeepSWE v1.1 拿到 77.9%(对比 Claude Opus 5.5 的 74.2%、GPT-6 Astra 的 74.1%);引入价 $2 / $10 每百万 token,11 月底翻倍。最特殊的一档:对受信网络防御者与 Google 内部团队,Argon 不带网络护栏发布。
数据来源
本文事实来自三个一手来源与两家媒体报道:Google 官方博客《Gemini 4 Argon: our next era of frontier intelligence》(blog.google,署名 Koray Kavukcuoglu,Google DeepMind 高级副总裁兼 Google 首席 AI 架构师,发布于 2026-09-30);9to5Google 对该发布的技术拆解(2026-09-30)与 Gemini app 灰度上线报道(2026-10-13);The Verge 报道《Google finally releases Gemini 4 Argon》(2026-10-13);以及 TechCrunch 同一周的模型发布对照报道。
需要分清口径:文中所有基准分数、内部案例数字都来自 Google 官方博客或其对照图表,属于厂商自测/自报口径;「Gemini app 已开始向 Pro 与 Ultra 灰度」「定价约为同级竞品的五分之一」这类判断来自 The Verge 的报道与 Google 官方定价页口径;两者在文中分开表述。
Google 这次给的第一手材料
Google 在 9 月 30 日就宣布了 Argon,但当时只向 Fairwind 计划里的一批「受信网络防御者」开闸,并说明自己正在参与美国政府的自愿预发布模型访问流程。官方博客里那句关于节奏的话值得原样引用:
安全地发布这个级别的前沿能力,需要分阶段进行。
到 10 月 13 日,闸门才真正打开:Gemini app 的 Pro 与 Ultra 订阅者、Search 的 AI mode、付费 API 客户、以及 Antigravity 平台的 Ultra 用户陆续拿到。Plus 订阅者与免费用户什么时候能用,官方和 The Verge 都没有给出时间表。
从竞争位置看,The Verge 的评价相当直接:这是 Google 自 2025 年末 Gemini 3 之后的首个重大前沿发布;中间这几个月,Anthropic 与 OpenAI 的模型让 Google 明显落在了后面,而 Argon 的到来是「不能把 Google 排除在 AI 竞赛之外」的提醒——它落地的时间点,只比 Meta 发布 Muse Wonder Full 晚了一天。
时间线:宣布到开闸隔了两周
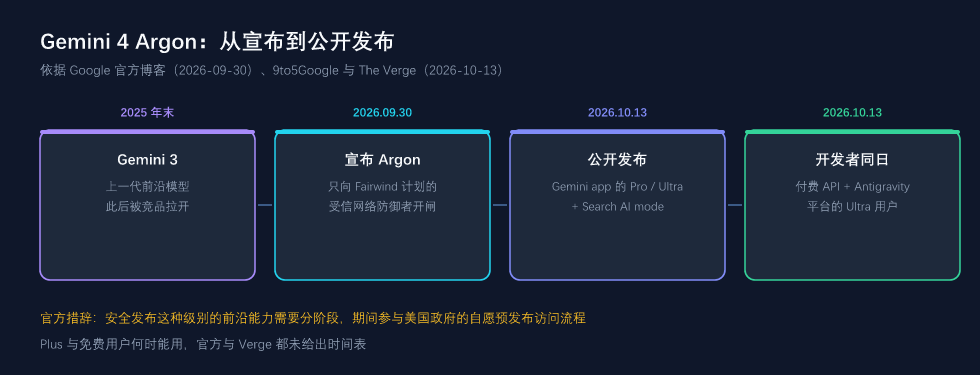
| 时间 | 事件 | 拿到访问权的人 |
|---|---|---|
| 2025 年末 | Gemini 3 发布 | 公开 |
| 2026-09-30 | Argon 宣布 | Fairwind 计划的受信网络防御者 |
| 2026-10-13 | 公开发布 | Gemini app Pro / Ultra、Search AI mode |
| 2026-10-13 | 开发者渠道同日 | 付费 API、Antigravity 的 Ultra 用户 |
对国内开发者来说,这张表里最实际的一行是第三行:API 与 Antigravity 是同日开放的,也就是说「先在 API 上试、再决定是否升级订阅」这条路是通的。反过来,如果你用的是免费档或 Plus,目前仍然拿不到 Argon。
一百万个输出 token 意味着什么
官方把这次的技术变化说得很清楚:输出 token 上限从 64K 提高到 100 万,并称这是「行业领先」。Google 给出的理由不是「能写更长的文章」,而是:
当模型有余量深入思考、并在一次轨迹里生成几十万个 token 时,它能一次性解决困难问题,推理的深度因此上了一个台阶。
这个方向与最近几个月整个行业的变化是同一件事:测试时算力(test-time compute)正在从「多轮对话」变成「单次长轨迹」。对使用者的实际影响是,过去需要人拆成十几轮的复杂任务(大型重构、跨文档研究、长流程自动化),现在有可能在一次调用里跑完,代价是单次调用的输出 token 费用会显著上升——这也是为什么下面这段定价需要连着附加条件一起看。
四张成绩单:编码、经济影响、业务流程、长视频
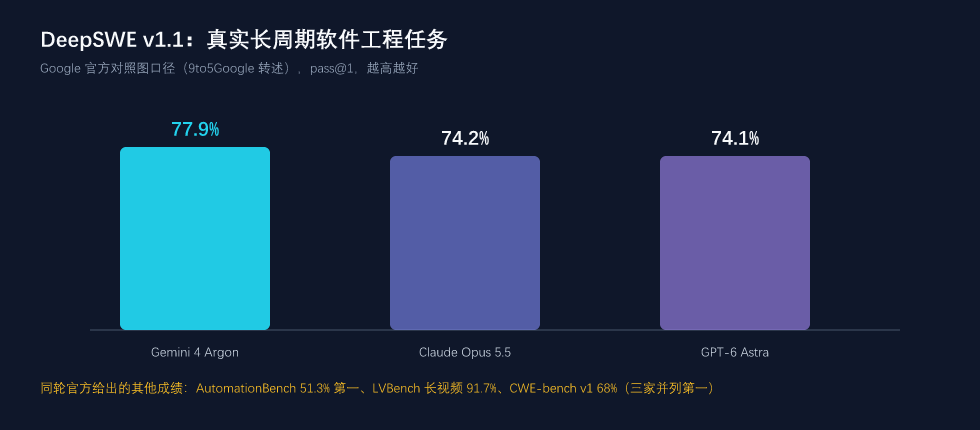
官方这一轮列出的评估集中在专业工作上,而不是通用问答:
- DeepSWE v1.1:77.9%,官方称其为真实长周期软件工程任务的新 SOTA。9to5Google 转述的同一张对照图里,Claude Opus 5.5 是 74.2%、GPT-6 Astra 是 74.1%。
- Vals Index 领先:这是一个按各行业对美国 GDP 的贡献加权来衡量「经济影响」的指数,覆盖金融、编码、法律与税务工作。除了总指数,Argon 在 Vals Finance Agent v2(多步金融研究)与 Harvey 的法律 Agent 基准(法律检索与起草)上也领先。
- AutomationBench 51.3%,排名第一:这是 Zapier 的基准,测的是跨核心企业职能的端到端执行。
- LVBench 91.7%,SOTA:衡量长视频理解。官方另外强调 Argon 在「需要视觉理解的知识工作」上尤其强——分析专业图表、从长视频里定位细节、并依据一系列文档采取行动。
把四张成绩单放在一起看,Argon 的定位很清楚:不主打聊天,主打「能连续干几小时的专业任务」。这也解释了为什么官方博客里列出的落地场景全部是工程与知识工作,而不是对话。
Google 自己怎么用它:四个内部案例
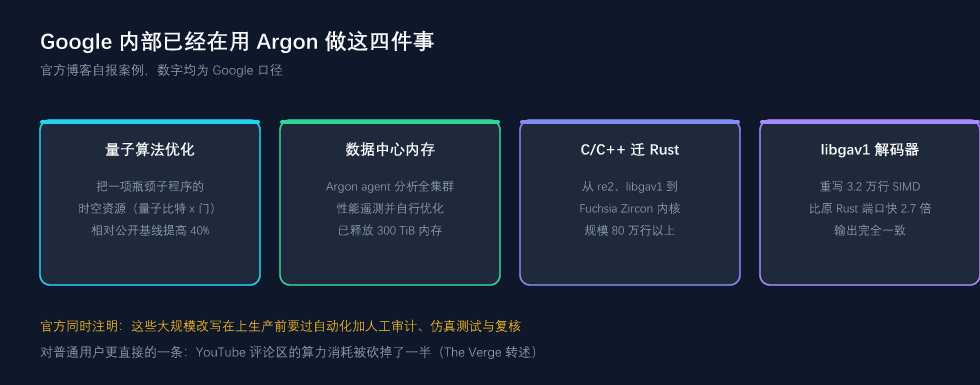
这是这次发布里最有信息量的一段——因为它是可被外部间接验证的产品级使用,而不是跑分:
- 量子算法优化:Argon 帮量子计算研究团队优化瓶颈子程序的时空资源(量子比特 x 门)。官方给了一个例子:几分钟内把已发表的基线提高了 40%。
- 数据中心内存:一队 Argon agent 分析全集群的性能剖析遥测数据,自主识别并应用内存优化,落地后释放超过 300 TiB 内存,官方估计总节省量在 500 TiB 到 1 PiB 之间。
- C/C++ 迁 Rust:从 re2、libgav1 这类核心库的「几万行」规模,一直到 Fuchsia Zircon 内核的 80 万行以上。官方注明这些改写在上生产前要过自动化加人工审计、仿真测试与复核。
- libgav1 视频解码器:Argon agent 拿着一份已有的 Rust 端口,重写了 3.2 万行 SIMD 代码(靠反复的 profile 引导实验 + 研究编译器输出,产出能让编译器自动向量化的安全 Rust)。结果是比原 Rust 端口快 2.7 倍、视频输出完全一致,并更接近优化过的 C++ 版本。
The Verge 另外补充了两个 Google 未在博客里展开的用途:帮助发现并修补网络安全漏洞,以及把 YouTube 评论区的算力消耗砍掉了一半。后者是这几个案例里,普通用户能最直接感知到的一个。
网络安全:这是发布里最特殊的一档
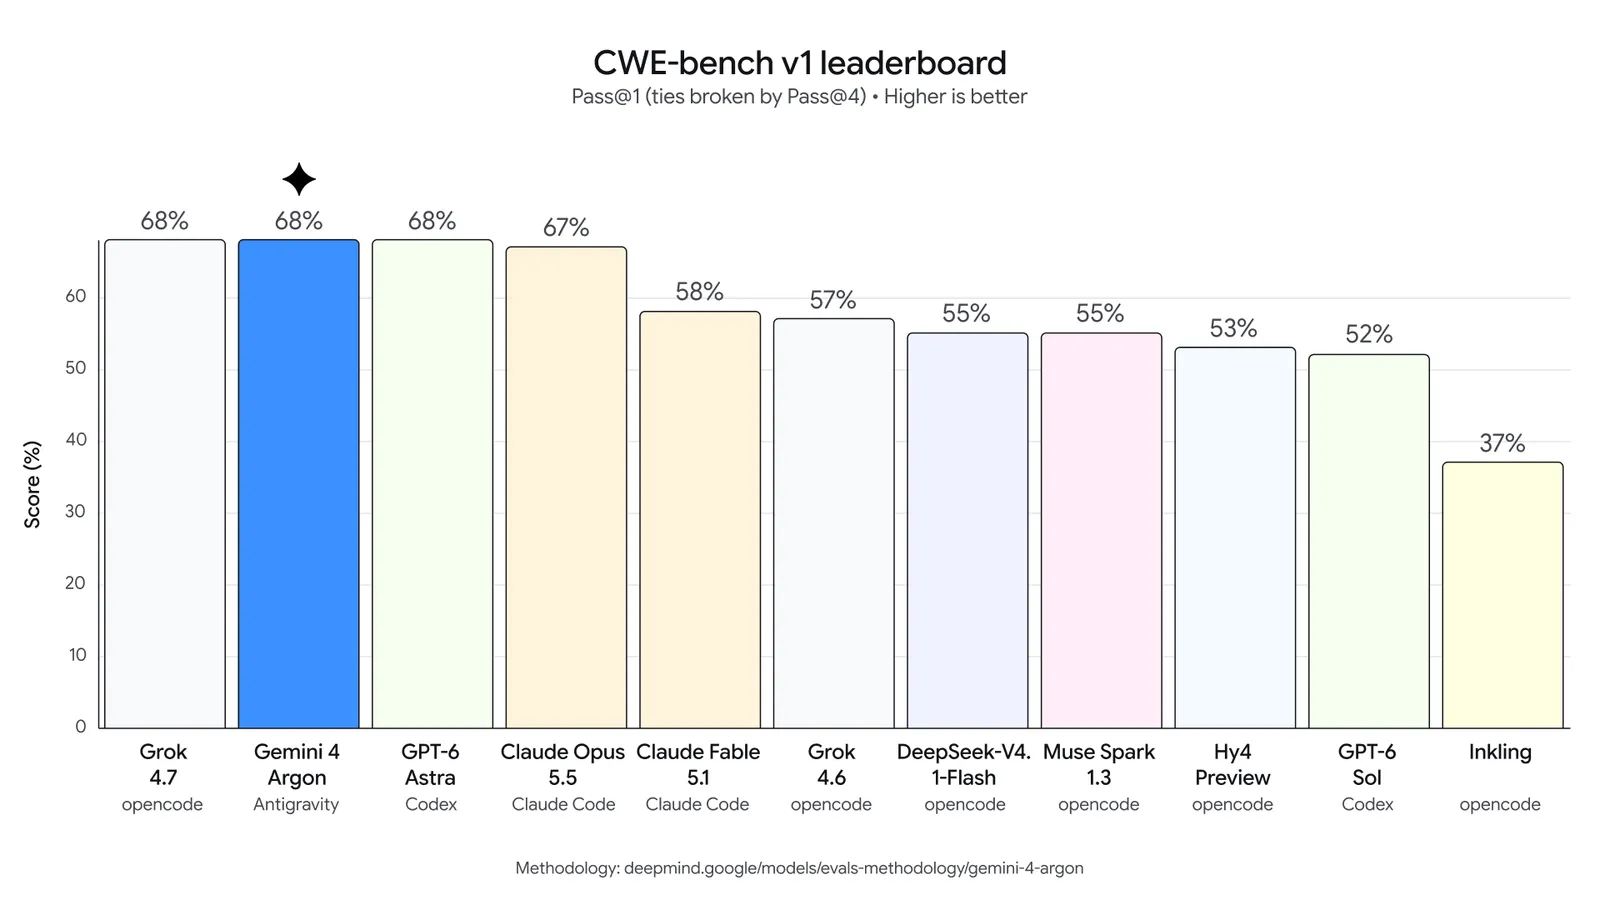
Google 把网络安全单独拎成一节,并给出了这次发布里唯一一处能力限制被主动放开的安排:
对受信防御者与我们在 Google 的内部团队,我们将不带网络护栏发布 Argon,让他们能用到完整的前沿网络安全防御能力。
具体能力与数字:
- CWE-bench v1:68%,并列第一。官方口径是「与最高分并列」,官方图表显示 Grok 4.7 与 GPT-6 Astra 同样是 68%,Claude Opus 5.5 是 67%。
- 相对上一代安全专版 3.8 Flash Cyber,Google 称 Argon 在漏洞发现上有明显跃升:在跨 20 种编程语言的复杂代码库内部漏洞基准上发现了大量暴露面。
- **Wiz 的「Scan for Good」**计划里已经在用 Argon 为关键公共基础设施免费找并修高危暴露。官方给的一个早期案例是:Argon 发现了一处影响全球医院所用医疗软件的严重漏洞,而之前的前沿模型都漏掉了它。
不过「不带护栏」这四个字需要连着下一段一起读——因为它对应的是官方对滥用防护的另一套安排。
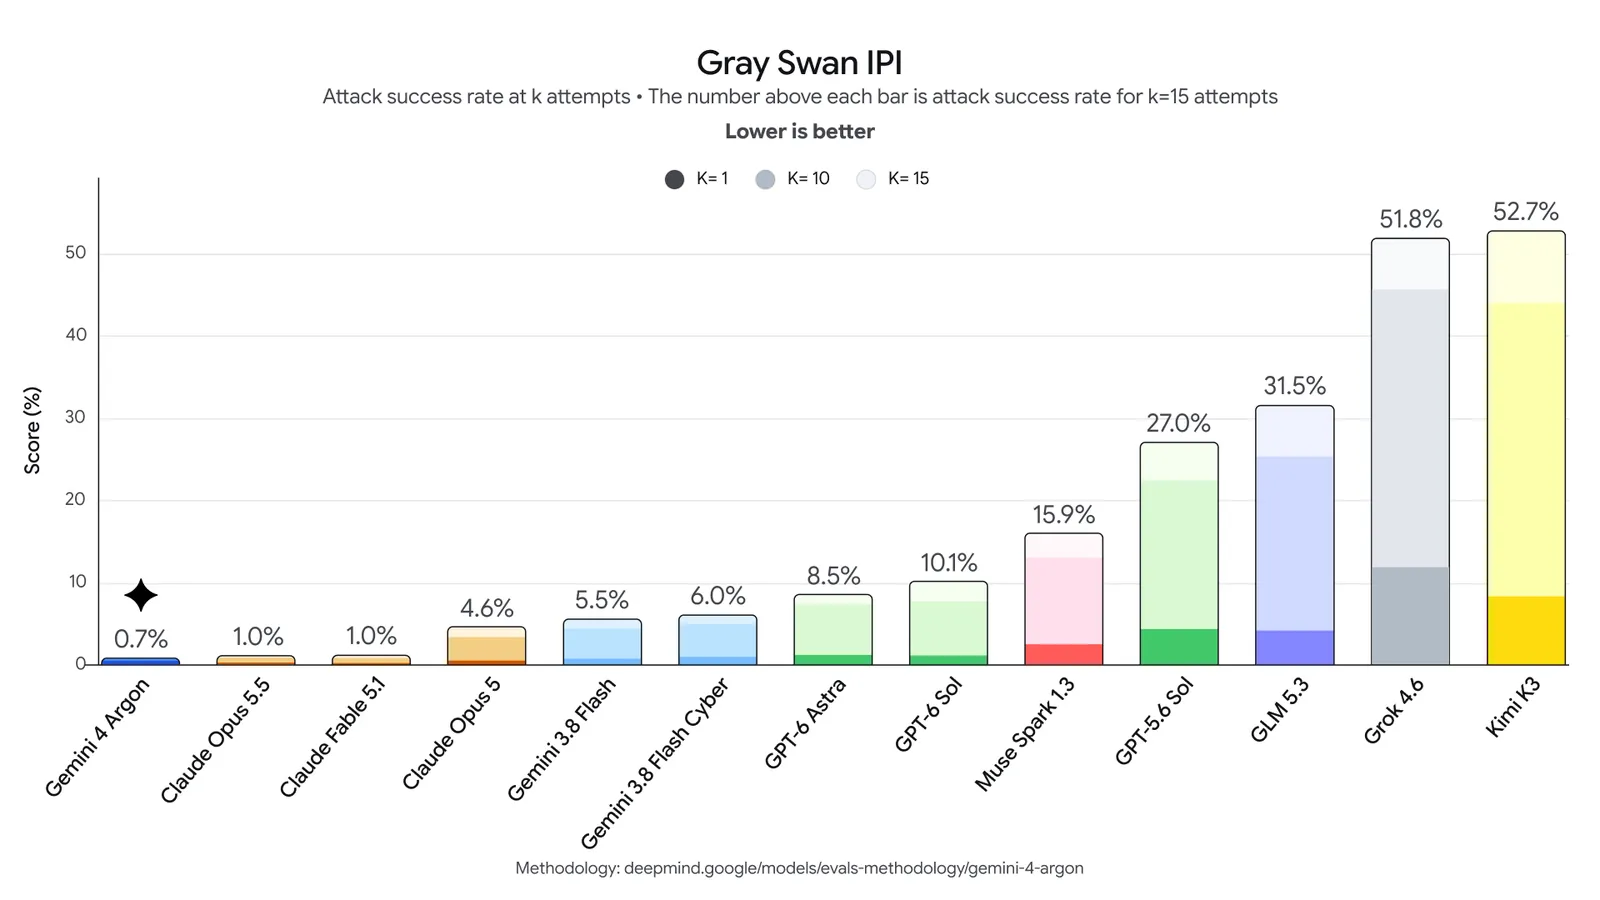
同一次发布里,Google 用一张横跨 13 个模型的图展示了自己在间接提示注入(Indirect Prompt Injection)上的位置:攻击成功率越低越好,Gemini 4 Argon 是 0.7%,全场最低;Claude Opus 5.5 与 Claude Fable 5.1 分别是 1.0%,GPT-6 Astra 是 8.5%、GPT-6 Sol 是 10.1%,而 GLM 5.3 是 31.5%、Grok 4.6 是 51.8%、Kimi K3 是 52.7%。
这组数字值得单独记住:「模型能力强」和「抗注入能力强」并不在同一根轴上。间接提示注入是 agent 时代的头号攻击面(网页、文档、邮件里的恶意指令劫持模型行为),而这张图里排名靠后的几个模型同样是一线模型。
官方列出的另外两条防护安排:CBRN 域按 Frontier Safety Framework 设计为拒绝有害请求,同时保留合法的双用途科研,并加强了监控模型内部激活的技术;失控域部署了错位缓解措施,用来防止模型为了实现任务目标而越过用户意图行事。所有这些防护都经过内外部红队的稳健性测试。
定价、开闸与三个必须记住的条件
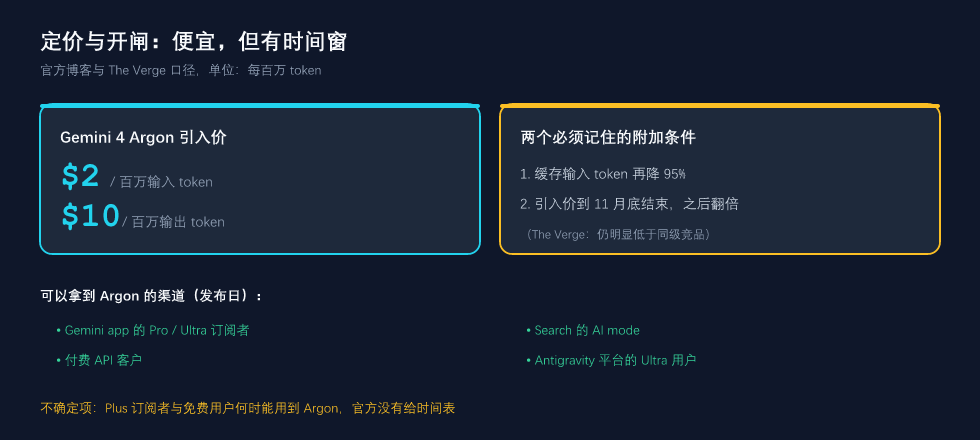
| 项目 | 官方口径 |
|---|---|
| 引入价 | $2 / 百万输入 token、$10 / 百万输出 token |
| 缓存输入 | 再降 95% |
| 有效期 | 引入价到 11 月底结束,之后翻倍 |
| 发布日开闸 | Gemini app Pro / Ultra、Search AI mode、付费 API、Antigravity Ultra |
| 未开闸 | Plus 订阅者、免费用户的时间表未公布 |
The Verge 的判断是:即便引入价翻倍之后,Argon 的每 token 价格仍明显低于同级前沿模型,引入期大约是 OpenAI GPT-6 Astra 与 Anthropic Claude Fable 5 的五分之一。但同一篇报道也点了一句重要的限定词:
这不必然等于实际成本更低,因为完成同样的任务,不同模型消耗的 token 数量并不相同。
结合前面「100 万输出 token」的设计,这句话的含义是:Argon 每一次可以吐出的内容远超同类,所以单次调用可能更贵而不是更便宜——它的经济性取决于任务能否被它一次性做完,而不是单价本身。
三个值得留意的问题
第一,全部是自测口径。 DeepSWE、Vals Index、AutomationBench、LVBench、CWE-bench 的分数都来自 Google 官方对照图;官方博客也说明这些对标运行由 Google 自己执行。The Verge 转述了 Google「在编码、网络安全、科学、金融、法律等基准上超过 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5」的主张,但这些都是厂商自报,第三方独立复现要等后续。
第二,「不带网络护栏」的边界在哪。 官方把无护栏版本限定在受信防御者与 Google 内部,同时强调滥用防护与内部激活监控。这两件事能不能同时成立、边界怎么划,是这次发布中最需要外部审视的一点。
第三,输出上限 1M 与成本结构的矛盾。 官方把「一次生成几十万 token」当成能力卖点,Verge 把「token 数不同、不必然更便宜」当成提醒。对使用者来说,真正的判断标准是同一个真实任务的总账单,而不是每百万 token 的价格牌。
总结
- 这次的主线是「长」,不是「聪明」:输出上限 64K → 100 万 token,是官方唯一强调的技术变化。
- 成绩单集中在专业工作:DeepSWE v1.1 77.9%、Vals Index 领先、AutomationBench 51.3% 第一、LVBench 91.7%。
- 内部案例是最好的一手证据:量子算法基线 +40%、数据中心释放 300 TiB、C/C++ 迁 Rust 上到 80 万行、libgav1 重写 3.2 万行 SIMD 后快 2.7 倍。
- 安全这条线是「放开 + 收紧」同时做的:对受信防御者不带网络护栏,同时用防护与激活监控管住滥用。
- 价格要连着附加条件看:$2 / $10 引入价、11 月底翻倍、Plus 与免费档没有时间表。
对普通用户,最直接的三个动作是:Pro / Ultra 用户现在就能在 Gemini app 里试;开发者可以从付费 API 或 Antigravity 起;如果你只关心成本,等 11 月底的价格变化再决定要不要把生产任务搬上去。
图片出处:封面与示意图由 UU AI Hub 自制;Gemini 4 Argon 官方视觉、CWE-bench v1 对照图与 Gray Swan 间接提示注入对照图取自 Google 官方博客该篇发布原文。数据来源:Google 官方博客(2026-09-30)、9to5Google(2026-09-30、2026-10-13)、The Verge(2026-10-13)。