一句话
权重是放出来了,官方连 FP8、base 模型、GGUF 和部署 recipe 都备齐了;但从腾讯自己的对比图看,它赢的是「在图形界面里点鼠标」这一类活,写代码、跑终端任务这种最常被拿来比的场景,它并不是第一名。
 图源:huggingface.co/tencent/Hy4
这次放出的到底是什么
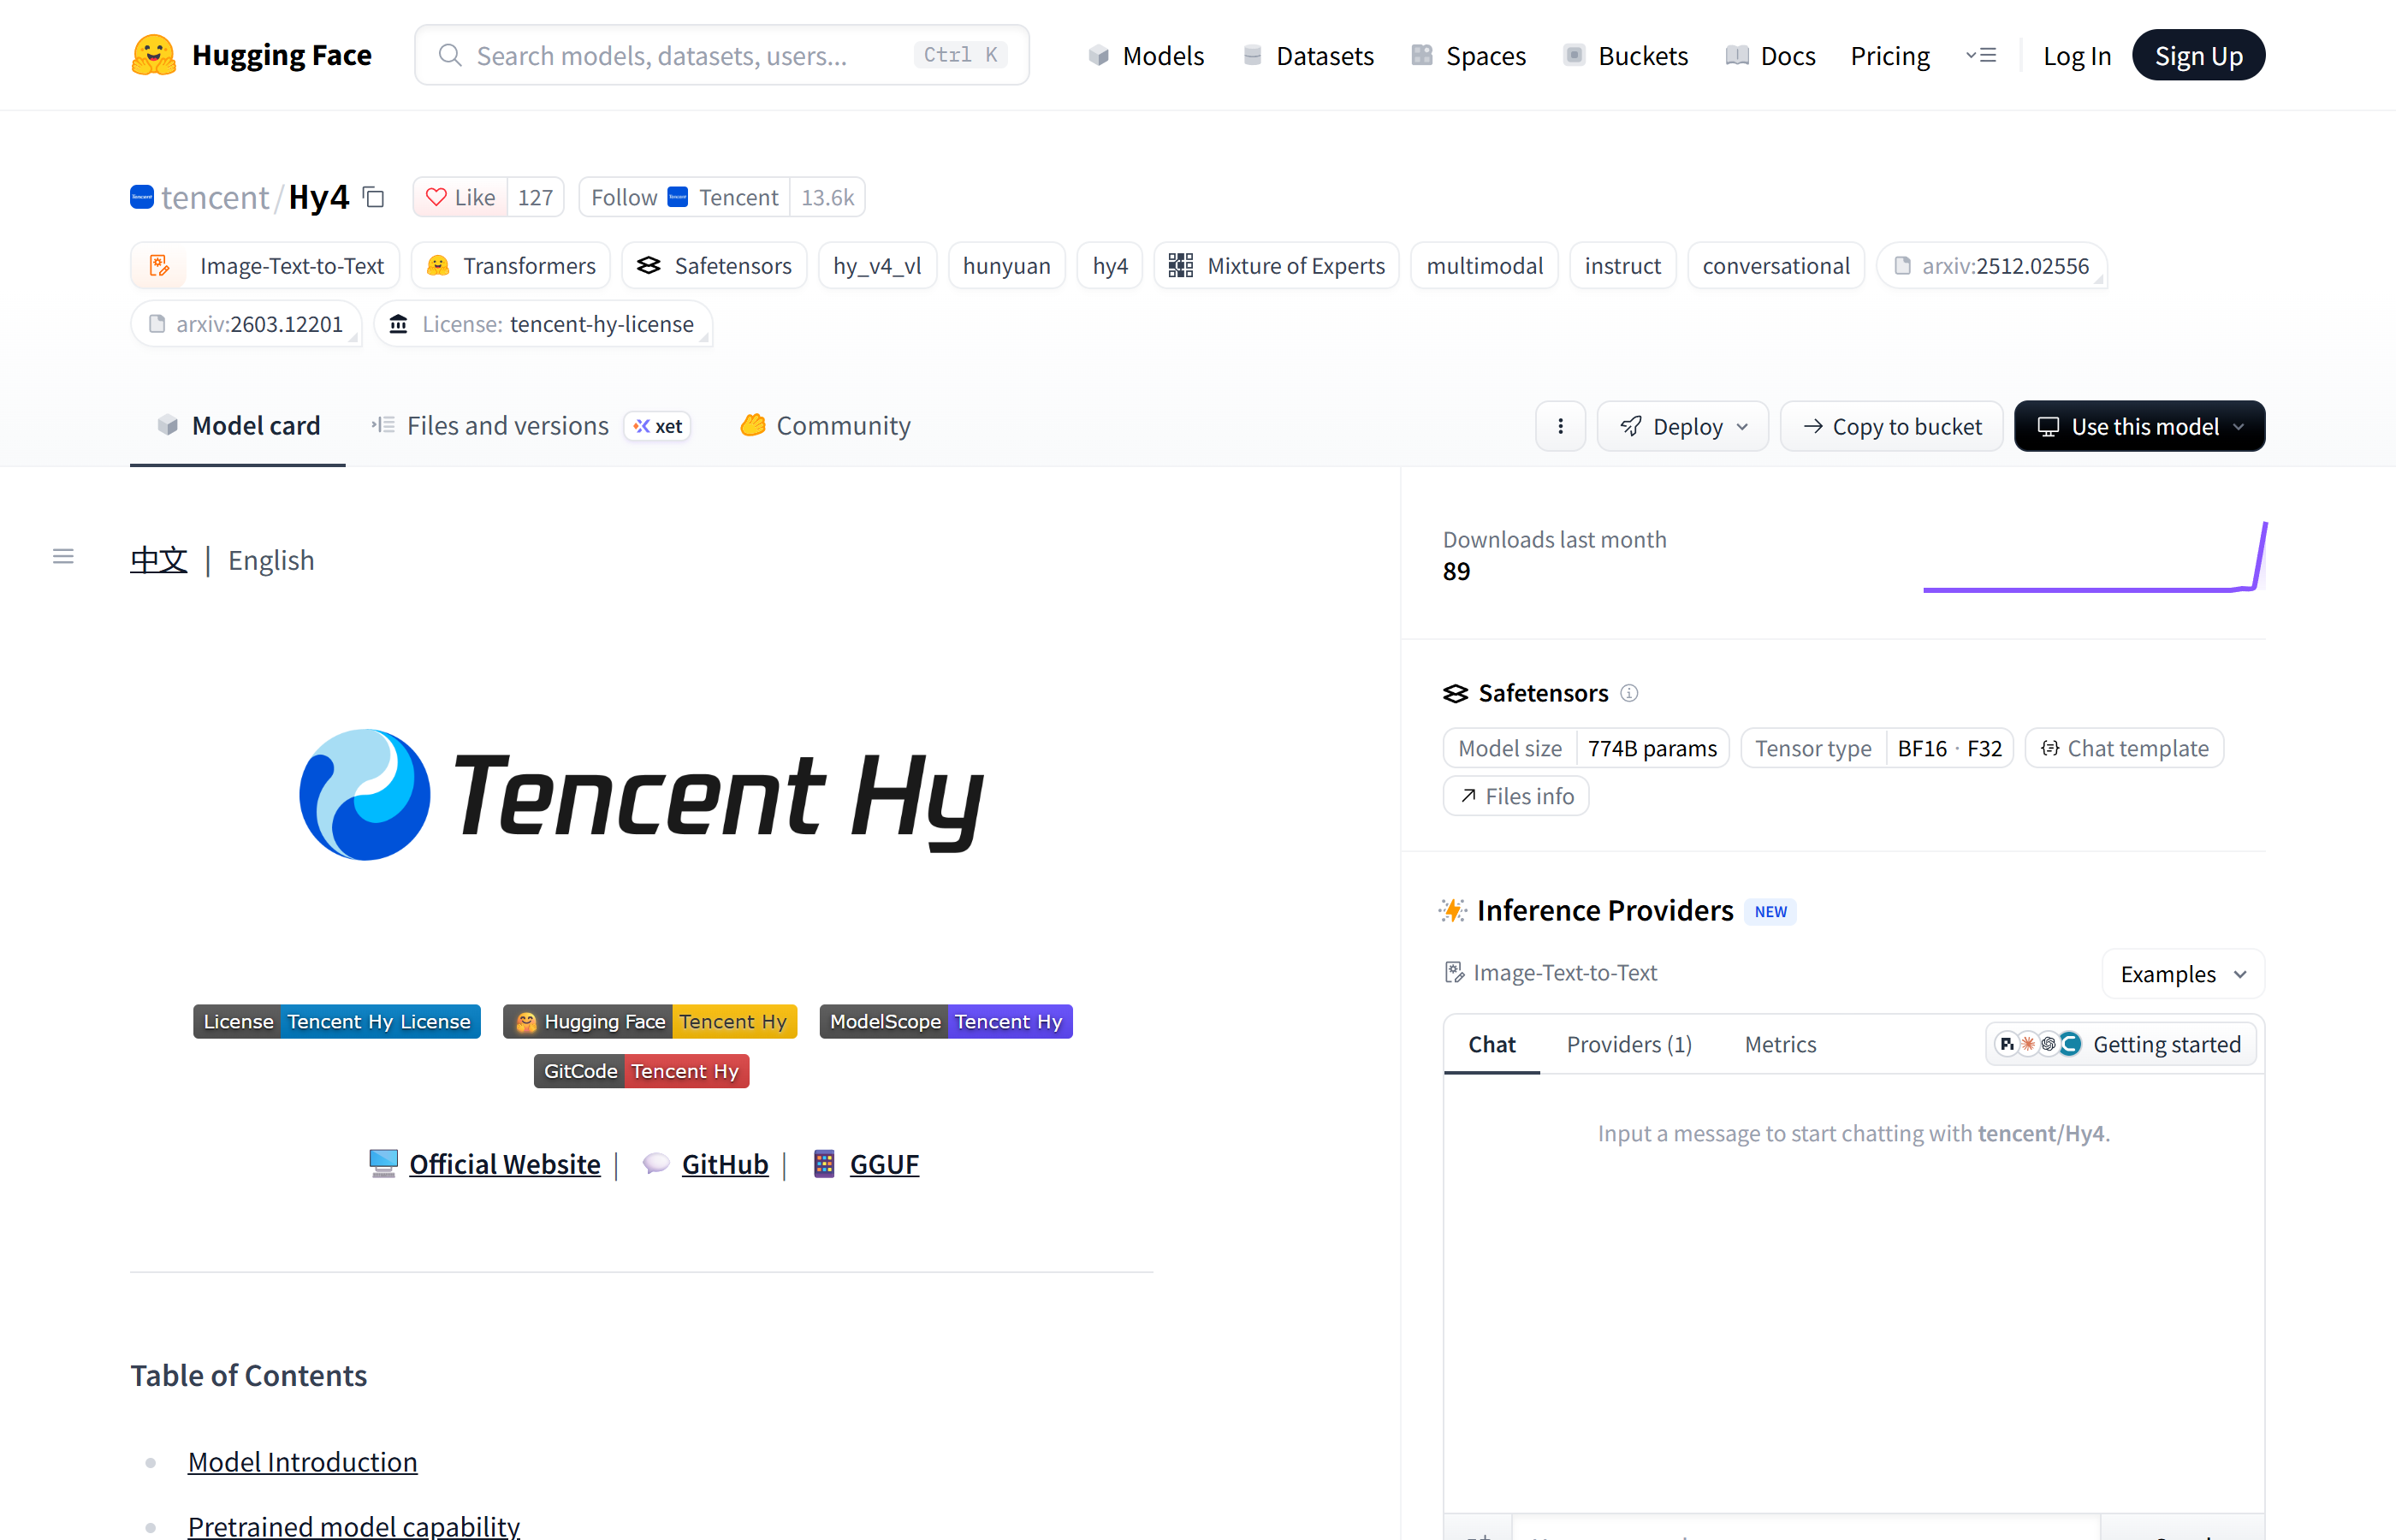
11 月 20 日,腾讯混元团队把 Hy4 系列从「发布」推进到「可下载」:Hy4(指令版)、Hy4-FP8(FP8 量化版)、Hy4-base(预训练基座) 三套权重同时上架 Hugging Face、ModelScope 和 GitCode,另外给了 GGUF 版本用于端到端试跑(量化工具是他们自家的 AngelSlim)。
配套的东西也算齐:系统卡单独成文;推理框架给了官方 recipe——vLLM 有预构建镜像 vllm/vllm-openai:hy4,SGLang 有 lmsysorg/sglang:hy4(x86 与 Arm 双架构);两者都带投机解码参数(--speculative-config '{"num_speculative_tokens":5,"method":"dfly"}')和 Hy4 专属的 reasoner / tool parser。
一句要单独拎出来说的:许可证不是 Apache 2.0,模型卡上写的是 Tencent Hy License。想商用的团队别按「开源大模型 = 随便用」的默认假设推进,先把 LICENSE 那一页读完。9 月那版 preview 的条款和现在这份不一定一样,以模型卡当前的 LICENSE 为准。
架构:770B 里每次只动 49B
- MoE:770B 总参(不含 ViT、adapter 与 DFly2),单 token 激活 文本 49B + 视觉 1.23B;78 层里第 1 层是稠密 FFN,后面 77 层是 MoE,每层 256 个路由专家 + 1 个共享专家,每个 token 走 top-8 + 共享。
- 上下文:1M(1,048,576 tokens)。
- 注意力:Gated DeepSeek Sparse Attention 配 IndexCache(跨层复用稀疏索引),底层是 MLA,64 个注意力头;每 token 只对索引器选出的 top-2,048 个 token 做稀疏注意力。
- 残差:iHC(identity Hyper-Connections),4 条残差流,用来加宽层间信息通路。
- 视觉:40 层 ViT,动态分辨率,2×2 特征合并,转成视觉 token 后跟文本一起进语言模型。
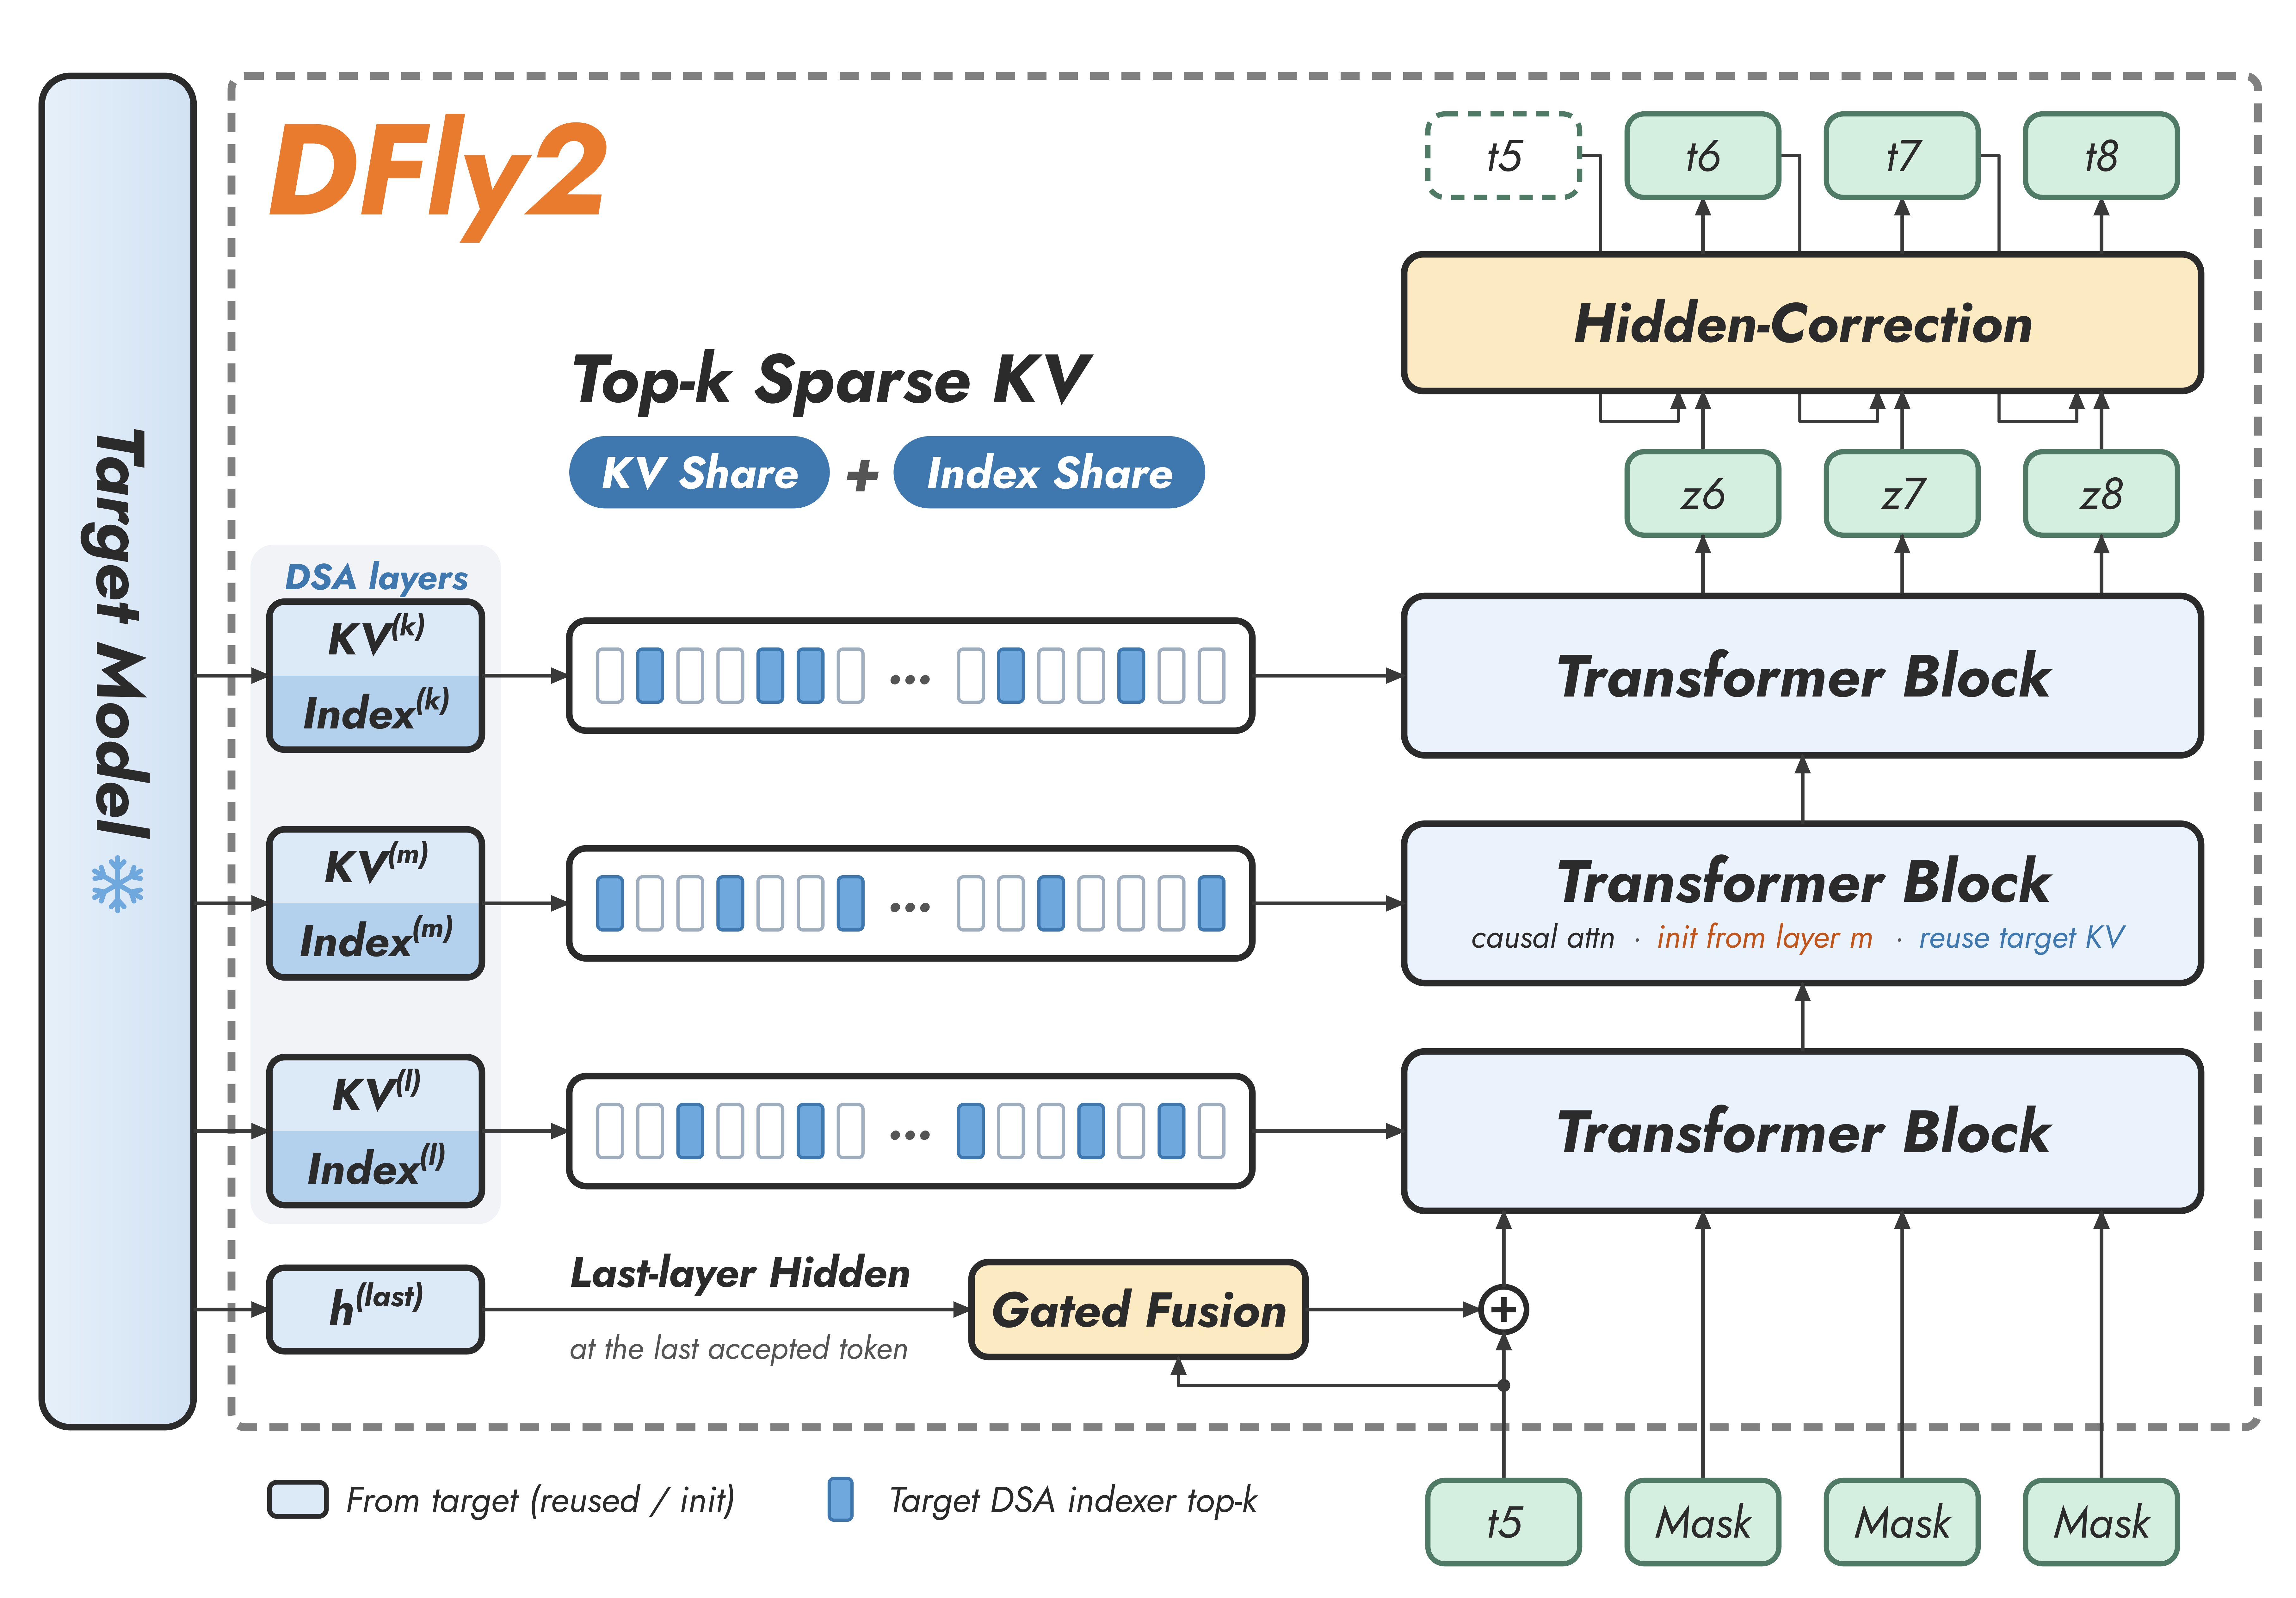
- 投机解码:内置 5 层、3.3B 参数的 DFly2 drafter,复用主模型的 KV cache 与稀疏索引。
 图源:huggingface.co/tencent/Hy4
官方自己的图:12 项里只赢 1 项
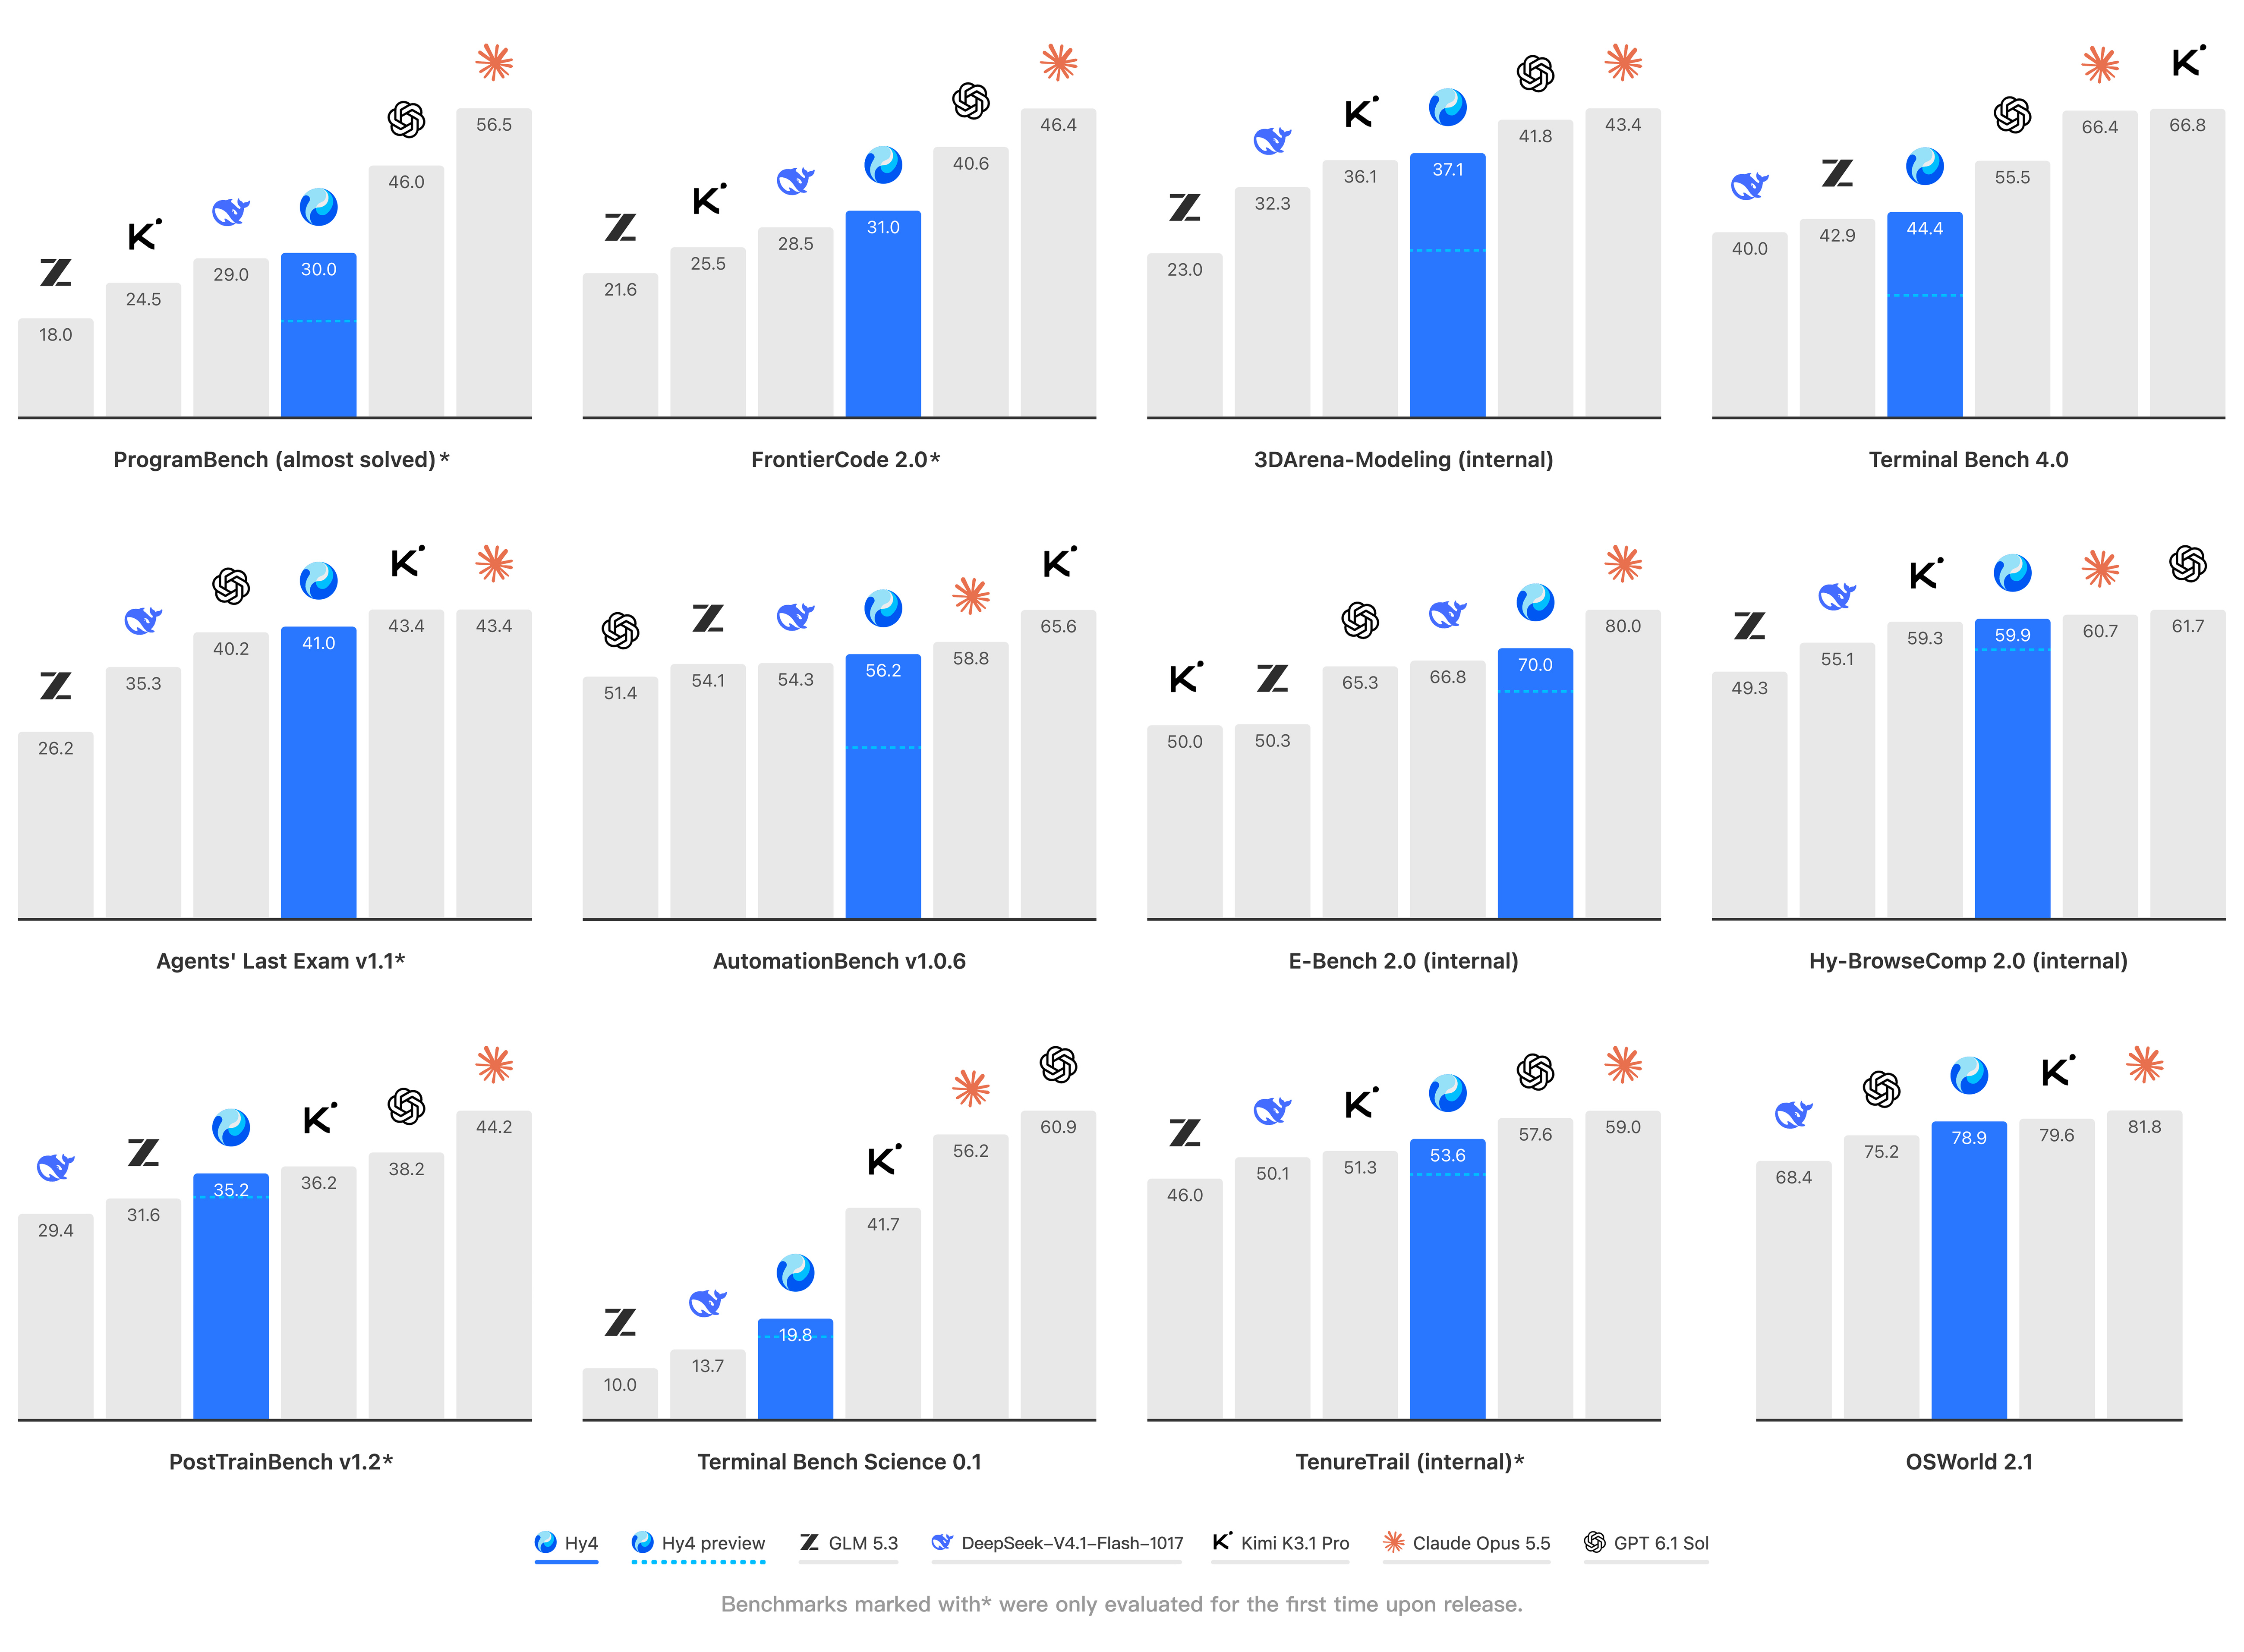
模型卡里放了一组 12 张柱状图,横向比 Hy4、Hy4 preview、GLM-5.3、DeepSeek-V4.1-Flash-1017、Kimi K3.1 Pro、Claude Opus 5.5、GPT-6.1 Sol。把颜色看清楚(深蓝是 Hy4)会发现一个比宣传口径更有意思的事实:
| 基准 | Hy4 | 该项最高 |
|---|---|---|
| OSWorld 2.1 | 81.8 | Hy4 自己 |
| E-Bench 2.0(内部) | 70.0 | 80.0 |
| TenureTrail(内部) | 53.6 | 59.0 |
| AutomationBench v1.0.6 | 56.2 | 65.6 |
| Hy-BrowseComp 2.0(内部) | 59.9 | 61.7 |
| Terminal Bench 4.0 | 44.4 | 66.8 |
| PostTrainBench v1.2 | 35.2 | 44.2 |
| FrontierCode 2.0 | 31.0 | 46.4 |
| ProgramBench | 30.0 | 56.5 |
| Terminal Bench Science 0.1 | 19.8 | 60.9 |
| Agents’ Last Exam v1.1 | 41.0 | 43.4 |
| 3DArena-Modeling(内部) | 37.1 | 43.4 |
它只在 OSWorld 2.1 这一项(GUI 里操作电脑)拿到第一;差距最大的是 Terminal Bench Science 0.1(19.8 对 60.9)和 Terminal Bench 4.0(44.4 对 66.8,对手是 Kimi K3.1 Pro),ProgramBench 也只有 30.0。这些数字全部来自腾讯自己的评测,标注「内部」的基准没有公开数据集可复现;带 * 的项目官方注明是「发布时首次评测」。
 图源:huggingface.co/tencent/Hy4
这张图真正说明的事:Hy4 的强项被官方定位在「多模态 + 长程 GUI/工具操作」这条线上,而不是「最强的编码与终端智能体」。选型时按这条线去对活,比看「国产开源新旗舰」这种说法靠谱得多。
预训练基座:BPB 曲线和几项硬指标
基座对标里放了自家 Hy3 preview base、Hy4 flash base 和 DeepSeek-V4-flash/Pro 的 base:
| 基准 | Hy4 Base | DeepSeek-V4-Pro-Base |
|---|---|---|
| MMLU(5-shot) | 91.6 | 91.1 |
| MMLU-Pro | 73.9 | 73.4 |
| C-Eval | 95.0 | 93.4 |
| SimpleQA | 57.2 | 52.1 |
| Chinese-SimpleQA | 83.9 | 76.6 |
| ARC-Challenge | 97.3 | 97.0 |
| MBPP-plus(3-shot) | 74.0 | 79.1 |
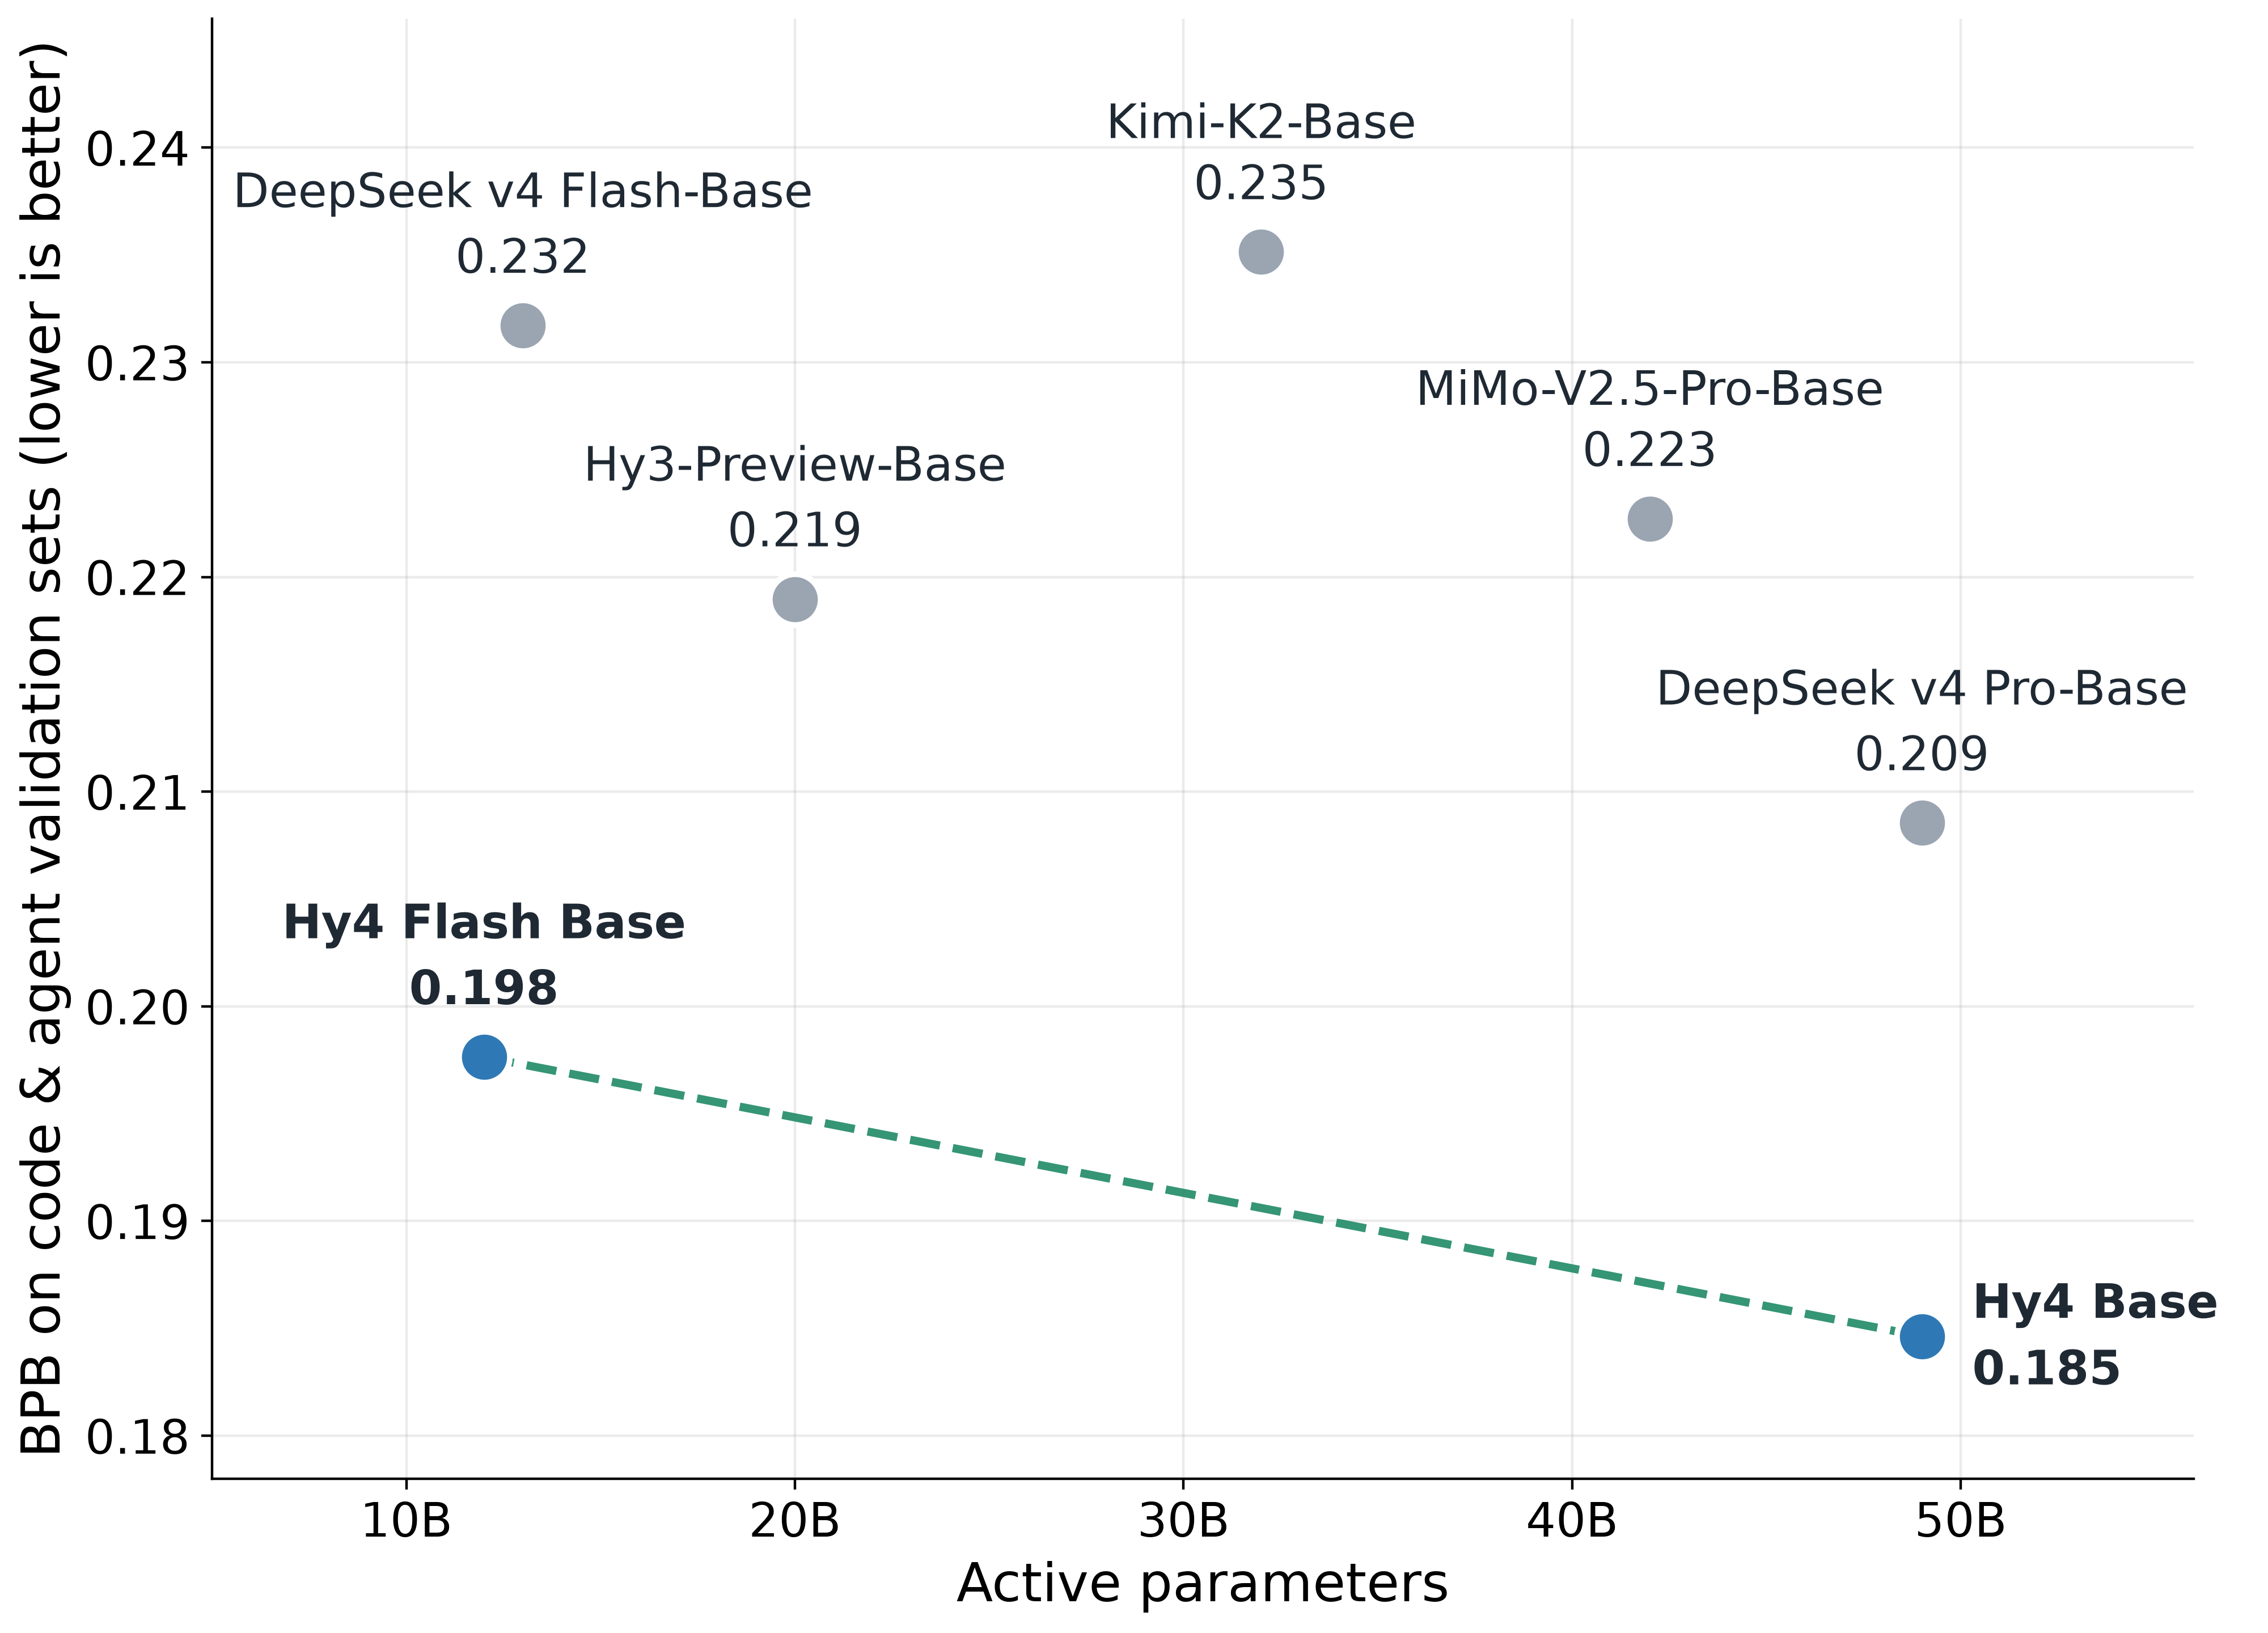
预训练曲线用的是内部代码与 agent 验证集上的 bits-per-byte(越低越好):
 图源:huggingface.co/tencent/Hy4
模型卡自己加了一条免责说明,值得记住:基座在中训练阶段接触了大量合成指令数据,在 few-shot 评测里偶尔不按预期格式作答,可能让分数失真。这类自评数字的可比性本来就有限。
从 preview 到正式版:涨在哪
相比 9 月那版 preview,官方点名的改进是:
- 视觉与 computer use:支持 CLI 与 GUI 两类操作,针对 Blender、CAD 这类专业软件做了定向训练;
- 前端与游戏开发:与腾讯互娱的开发者共建训练数据与评测,对 Unreal、Unity、Godot 做了适配,GameDev +19.1%、GameLogic +9.8%;
- 金融与办公:与腾讯金融科技一起用 213 位金融从业者评测(其中 153 位来自头部机构、超七成有 5 年以上经验),579 个真实任务上均分 3.04/4(DeepSeek-V4.1-Flash-1017 为 2.97);内部评测里幻觉率从 15.76% 降到 5.45%,推测性错误从 23.1% 降到 5.6%;
- 长程任务与研究:长上下文理解、深研究、跨应用长流程都有提升。
上述百分比全部是厂商自报,没有第三方复测。
想自己跑?先算三笔账
- 显存:770B 参数在 BF16 下约 1.5TB,FP8 下约 770GB。官方 vLLM recipe 直接
--tensor-parallel-size 8——也就是说入门配置就是 8 张卡,用 141GB 的 H200 是 1128GB,装得下 FP8 权重但余量不宽裕;想跑 BF16 得翻倍。个人机器不用想,单机 4090/5090 这条路走不通。 - 许可:Tencent Hy License,商用前逐条读;这不是 OSI 认证的开源协议。
- 运维:稀疏注意力要
--attention-backend FLASHMLA_SPARSE,投机解码要 DFly2 的镜像支持,套错镜像或漏参数会直接起不来或性能大打折扣。官方给了 recipe,但没给「最小可用集群」的验收清单。
如果只是想把能力接进产品,用 API 或走 OpenRouter 上已经挂出的推理端点比自己搭集群便宜得多——模型卡上就标着 OpenRouter 是它的推理提供方之一。
数据来源
- Hugging Face 模型卡:tencent/Hy4(2026-11-20 更新),含架构参数表、预训练/后训练基准、部署 recipe、许可证入口
- 腾讯混元官方账号关于 Hy4 开源的公告(2026-11-20):权重、GGUF、系统卡与许可证链接
- Hy4 System Card(hy.tencent.ai)
- 文中所有分数、百分比与配置参数均取自上述官方材料,属厂商自报结果