一句话总结
10 月 6 日,法国 Mistral 放出 Mistral Large 4 的公开预览,内部代号 Le Chonk(胖猫):1 万亿总参数、520 亿激活的原生多模态 MoE,在自有欧洲数据中心的 3800 张 NVIDIA Grace Blackwell 上从零训练。它没有打「最强」的旗号,而是打了一张欧洲最想打的牌:开放权重 + 主权可控——权重月底放出,预览期先和各国安全机构一起做红队测试。
数据来源:Mistral 官方博客《Introducing Mistral Large 4》(2026-10-06)、TechCrunch 同日报道(记者 Anna Heim)、The Verge 同日报道(记者 Robert Hart)。
1 万亿参数,但每次只唤醒 520 亿
先把规格说清楚:ML4 是稀疏 MoE,1 万亿总参数、520 亿激活——按官方给出的比例,每次推理只唤醒约 5.2% 的参数。它把指令、推理与 Agent 能力统一在一个模型里,并且是原生多模态(文本 + 图像输入)。
一个值得留意的细节:官方公告里这行「激活参数」在预览期间从 490 亿改成了 520 亿——Mistral 自己写着「模型仍在快速迭代」(it continues to improve rapidly as we refine it)。预览期改数字不算常见,但也侧面说明这个模型确实还在动。
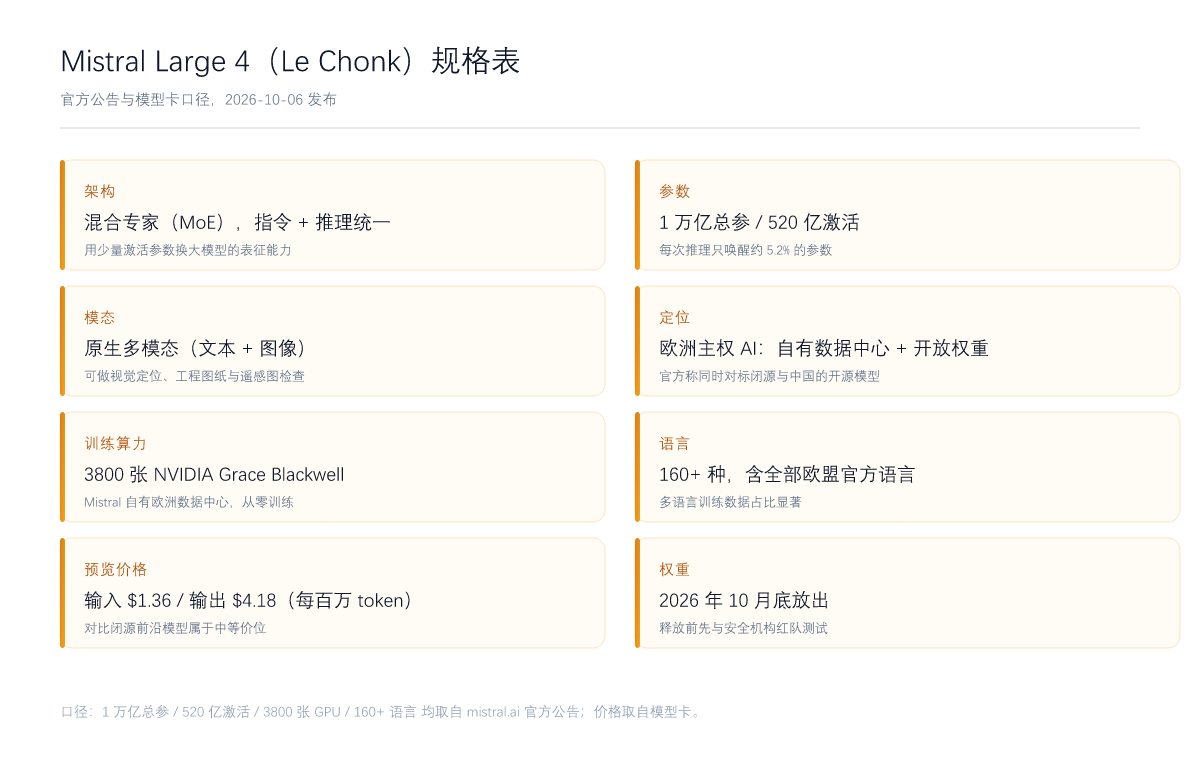
多语言是它刻意强调的一点:训练数据横跨 160 多种语言,包含欧盟全部官方语言。这不是凑数——在一个把「数字主权」写进政策的地区,「欧盟官方语言全覆盖」本身就是产品叙事的一部分。
一个不太寻常的取舍:3800 张自建 GPU,从零训
在当前这轮模型竞赛里,「从零训练」正在变成少数派——多数厂商更倾向于在既有基座上做后训练。ML4 走的是另一条路。官方原文:
ML4 was trained from scratch on 3,800 NVIDIA Grace Blackwell GPUs in Mistral’s own datacenters in Europe. The public preview is served on that same infrastructure.
3800 张 GPU、自有欧洲数据中心、从零训练,预览服务也跑在同一套基础设施上。 TechCrunch 在报道里补了一个对比:这个规模比 Mistral 的中国同行少两到三倍,也比闭源阵营显著更小。换句话说,Mistral 想证明的不是「我们算力最多」,而是「这些算力是我们自己的,且够用」。
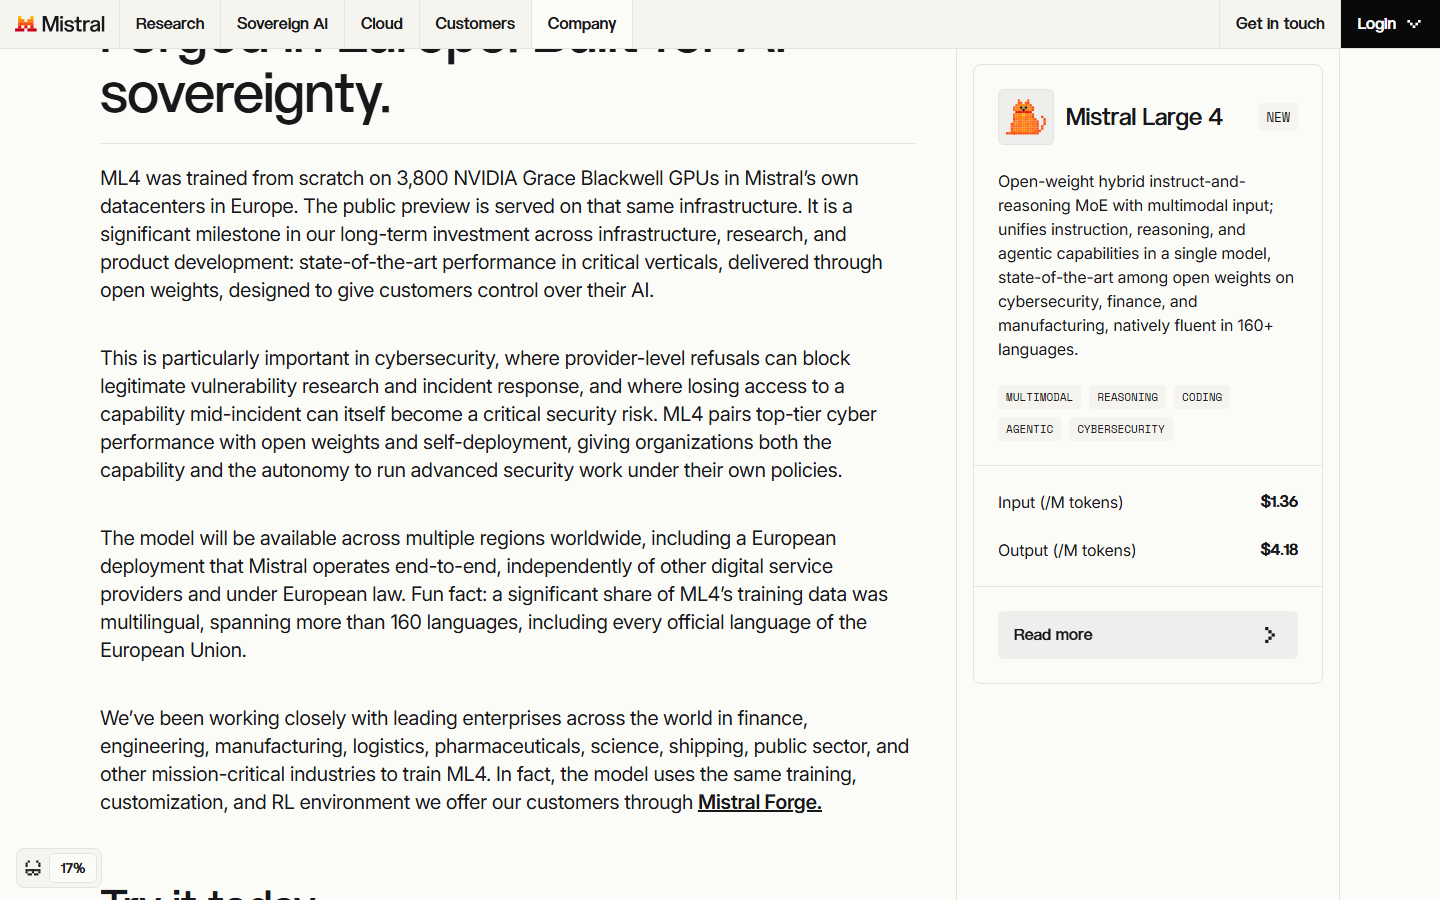
配套的是钱:ML4 挂在 30 亿欧元 Series D 的路线图上,官方称这是欧洲科技公司历史上最大的股权融资轮(TechCrunch 报道该轮由三星领投,估值约 210 亿欧元;上一轮 Series C 由荷兰 ASML 领投)。算力、模型、融资三件事被绑在同一句叙事里,落点就是四个字:主权 AI。
网络安全:82% 的「复现并修补真实漏洞」,全场最高
ML4 最能打的地方不是通用能力,而是网络安全。按官方披露:
- 在独立的 Artificial Analysis Cyber Index 上,它排进全球前五,并「大幅领先所有非中国开发的开源权重模型」;
- 在一项要求模型复现开源软件里的真实漏洞并把它补上的测试里,ML4 拿到 82%,官方称这是所有模型里的最高分;
- 在 Cybench(40 道来自安全竞赛的题)上解出 93%。
而这条数据真正的看点在这半句:Claude Opus 5.5 与 GPT-6 Astra 在同一项测试上接近 0 分,原因不是能力不足,而是它们拒绝执行。官方对此的论证相当直接——「证明漏洞是真的」本来就是防御工作的第一步,而闭源模型的安全过滤恰好会挡住这一步;与此同时,攻击者却在用越狱绕过同一批模型。
一句话概括 Mistral 的立场:防守方需要不被拒绝机制拦住的能力。而「开放权重 + 自部署」正是它给出的解法,官方明确提出 ML4 可跑在私有云或本地部署,让组织在自己的策略下做安全运营。
编码与 Agent:61.7% DeepSWE,人评第二
通用能力上,官方给的数字是:
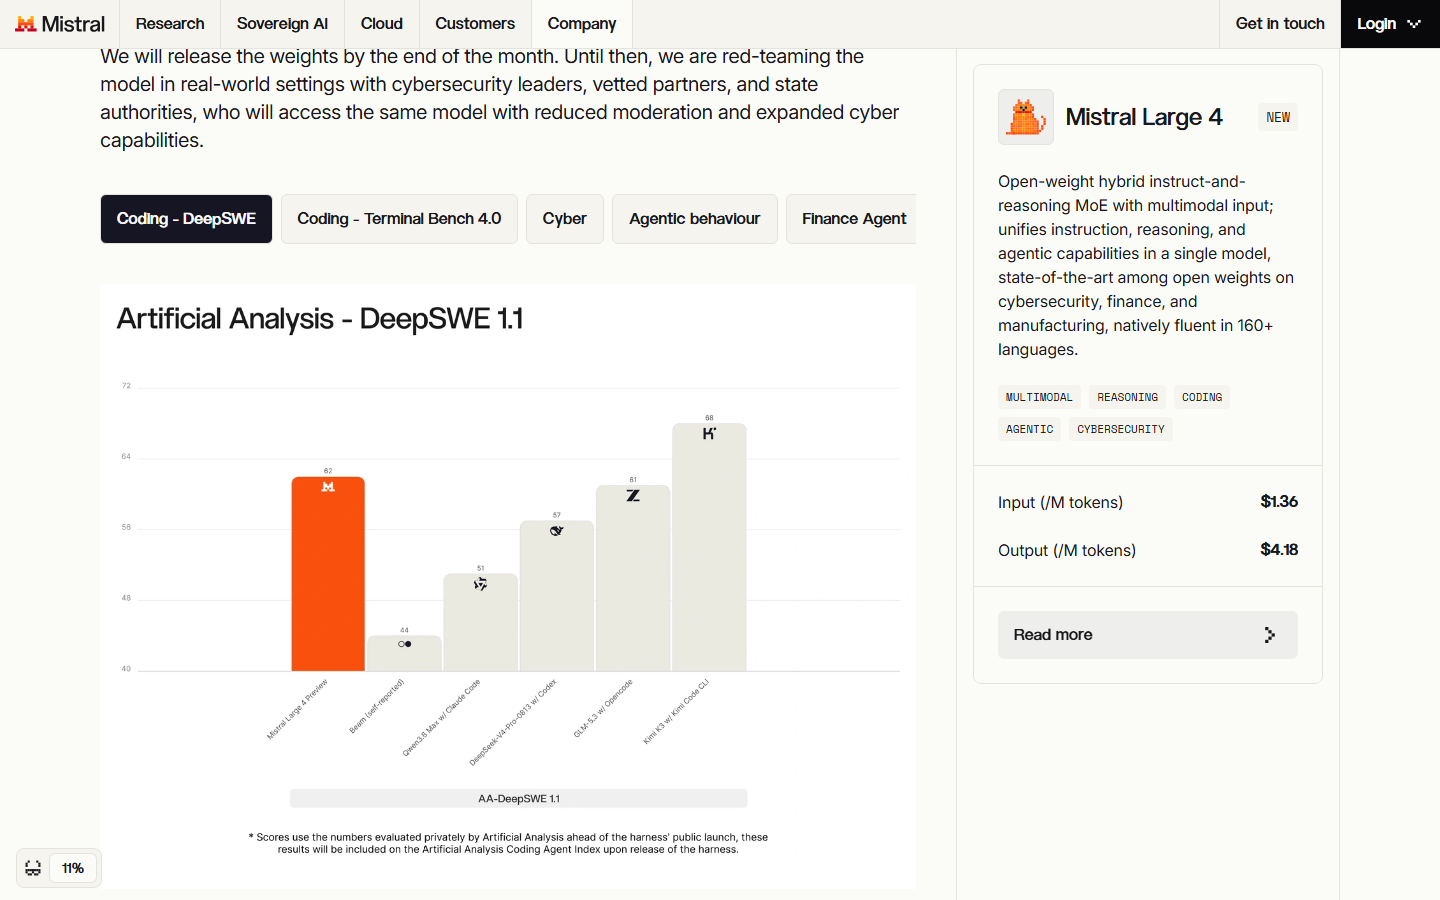
- 61.7% DeepSWE v1.1、59.4% SWE-Atlas-QnA、28.3% Terminal-Bench 4,综合 Coding Agent Index 49.8%,官方称领先 DeepSeek V4 Pro 0813 与 Qwen3.8 Max;
- Agent 任务上,AutomationBench(657 条覆盖 Gmail、Sheets、Slack、Salesforce 的业务流程)拿到 59.9%;长流程知识工作基准 AA-Briefcase 达 1,393 Elo;
- 视觉定位上,官方称在 Dense 200 上以 42% vs 41% 略胜 GPT-6 Astra。
更值得看的是那张盲评:Mistral 委托 Surge AI 做隐藏模型身份的编码质量人工评分(1–5 分制),ML4 预览版以 3.74 排第二,排在 GLM-5.3(3.60)、Kimi K3(3.59)、GLM-5.2(3.40)之前,只输给 Claude Opus 5 的 4.22。
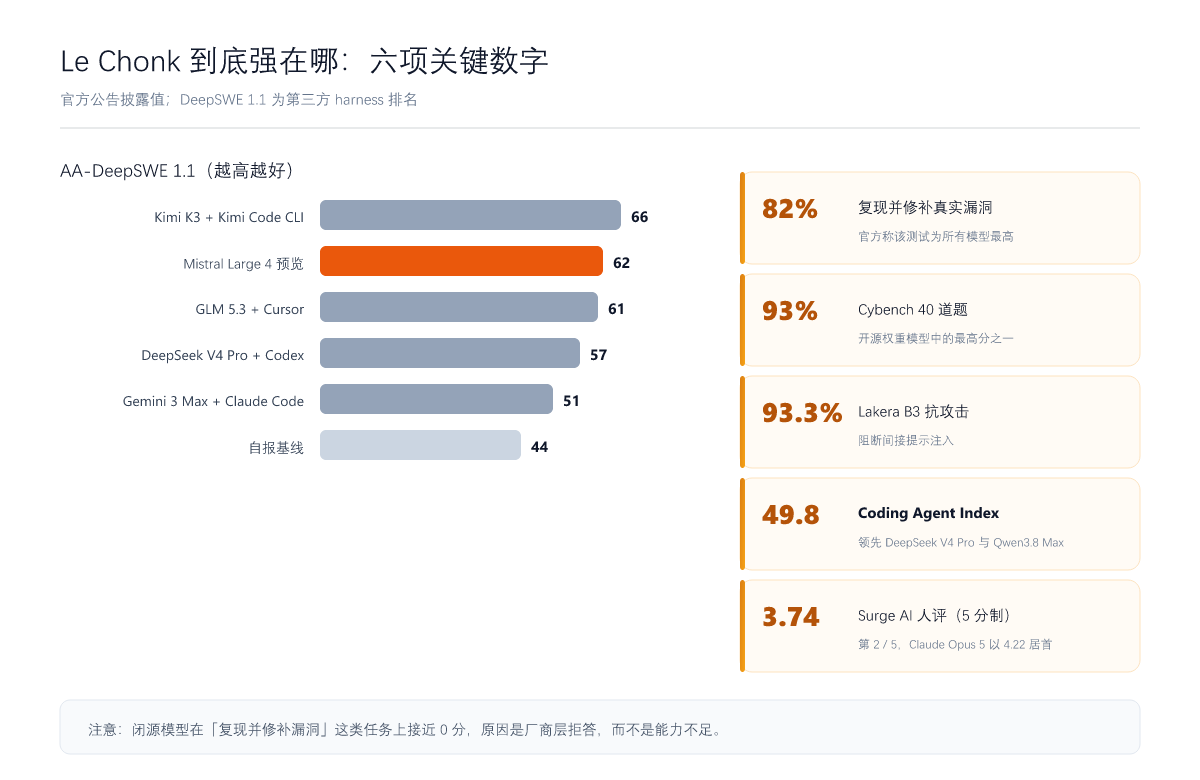
安全侧的自评同样被放上台面:Lakera 公开的 B3 AI Security Benchmark 上挡住 93.3% 的攻击;KORA 基准拿到 1.691(满分 2 记作「Exemplary」);官方还特别强调,尽管网络安全基准分很高,ML4 在面对恶意网络请求时的平均拒绝率高于所有开源权重模型——这是在提前回应「开源强安全模型会不会被滥用」的质疑。
权重月底放出,但预览先跑
时间表是这件事里最该记住的部分:
- 现在:公开预览 API 已在 Mistral Studio 可用,价格 输入 $1.36 / 输出 $4.18(每百万 token)——按官方自己的说法,属于对标闭源前沿模型中的中档价位;
- 预览期:与网络安全机构、审核过的合作伙伴和国家主管部门一起做真实环境红队测试,这批人拿到的是降低审核强度、扩大网络能力的同一模型;
- 10 月底:放出权重,同时补充架构、更多基准与后训练方法论的细节。
也就是说,现在能玩的只是 API,权重还没到手。「开放权重」这个说法在 10 月底之前都还只是一句承诺——这一点在看各家标题时容易被冲淡。
训练的规模感也给了个量化的锚:官方称当前尺度(约 3000 张 GPU)下,一次训练运行每天产生约 330 亿 token,其中约 160 亿经过滤与掩码后成为可训练的补全 token。
三个该打问号的地方
第一,基准还没跑完。 TechCrunch 明确写到 benchmark results still pending;官方列出的多项数字来自自家评测或合作方 harness,第三方独立复现要等权重放出之后。DeepSWE 那张对比图下面也标着:分数用的是 Artificial Analysis 在 harness 公开发布前私下评测的数字。
第二,「全场最高」的语境需要限定。 82% 那项测试里,闭源模型接近 0 分是因为拒绝执行而非不会做。这个对比说明的是「谁能做这件事」,而不是「谁的技术更强」——两者不该混为一谈。
第三,自我保留变多不等于能力变强。 KORA 1.691、B3 抗攻击 93.3%、拒绝率高于所有开源模型,这些指标同时指向一个方向:Mistral 在主动把「不越界」写进模型性格。对一个主打网络安全能力的开源模型来说,这是必要的,但也意味着在真实攻防场景里的实际表现,还需要第三方来验。
为什么值得记一笔
这轮开源权重竞赛里,主角长期是中美的模型。ML4 提供了一个此前缺席的样本:一个欧洲团队,用自建算力、自建数据中心、从零训练,把「主权」和「开放权重」打包成同一个卖点,并在网络安全这个高价值垂直上进入了开源阵营的第一梯队。
它同时也是对当前行业两难的一次正面回答。TechCrunch 的概括很准确:一边是「随时可以被拔线的闭源模型」,另一边是「多来自中国的开源模型」,Mistral 想做的是第三种选择。这个定位能不能立住,取决于两件事——10 月底权重是否如期放出,以及放出之后第三方能不能复现那些数字。在权重真正到手之前,「开放权重」仍是待兑现的承诺。
总结
- Mistral Large 4(Le Chonk):1 万亿总参数 / 520 亿激活的原生多模态 MoE,预览期仍在迭代;
- 训练方式:3800 张 NVIDIA Grace Blackwell,在 Mistral 自有欧洲数据中心从零训练,预览服务同基础设施;
- 最能打的是网络安全:漏洞复现并修补 82%(官方称全场最高)、Cybench 93%、AA Cyber Index 全球前五;闭源对手接近 0 分是因为拒绝执行;
- 编码与 Agent:DeepSWE v1.1 61.7%、Coding Agent Index 49.8%;盲评人评 3.74 排第二,仅落后 Claude Opus 5;
- 时间表:预览 API 现在可用($1.36 / $4.18 每百万 token),权重 10 月底放出;基准的第三方复现要等权重到手之后。
图片出处:封面与「规格表」「六项关键数字」示意图由 UU AI Hub 自制;公告页首屏、训练说明段落、DeepSWE 对比图与主权 AI 视觉取自 Mistral 官方博客《Introducing Mistral Large 4》。