一句话总结
11 月 2 日,美团发布新一代大模型 LongCat-2.5:总参数 1.6 万亿、每个 token 激活约 480 亿的原生多模态模型,面向长程智能体任务,训练全程由国产算力完成。它的独特之处不在参数规模,而在训练方法——把真实 Agent 的失败轨迹转化为可复现、可验证的训练任务,哪块能力弱就补哪块。自报评测介于 Claude Opus 4.8 与 Opus 5 之间,部分指标超过后者。
「不当 Token 工厂」:美团为什么做大模型
美团做这件事的动机,在 CEO 王兴 8 月财报电话会上已经讲得很直白:AI 能力的长期价值,是能否真正进入真实工作流、解决真实问题,形成长期稳定的基础设施能力。
「我们不会成为 Token 工厂,我们的模型和 AI 产品将用于支持我们的主业,提升用户、商户体验和公司经营效率。」
所以 LongCat-2.5 的定位不是做一个「通用聊天机器人」,而是重点强化商业分析、软件开发这两类能力,为本地生活商家配 AI 帮手。这解释了为什么一个外卖起家的公司,要把模型训练得「擅长看经营数据」。
1.6 万亿参数 + 全程国产算力
LongCat-2.5 延续了上一代 LongCat-2.0「完全由国产算力完成训练」的路线,把「国芯国模」再往前推了一步。几个关键数字:
- 总参数 1.6 万亿,每 token 激活约 480 亿(稀疏 MoE 架构);
- 中训练阶段采用最长 1M token 的序列做长上下文训练,累计训练量达数万亿 token;
- 强化了原生视觉理解(视觉信号统一成 token)与智能体编程能力。
一个绕不开的现实约束是:国产加速器单卡显存普遍不足 80GB。美团的做法是围绕超节点架构设计并行策略——FSDP 和 EP 并行度都与单个超节点的卡数一致,让参数 AllGather、专家 token AllToAll、KV AllGather 都在超节点内的高速互联域中完成。综合下来,这套 FSDP 配置在长序列 SFT 任务中的单卡吞吐量较 DDP 基线提升 86%。
视觉:把图像变成 token
LongCat-2.5 的视觉方案很「工程化」:把视觉信号表示为多层级离散 token,让主干模型以统一的 token 形式同时处理视觉与文本输入。具体做法是沿用 LongCat-Next 的方法,对语义对齐编码器(SAE)产生的原生分辨率特征做残差向量量化(RVQ),解决视觉离散化的信息瓶颈。
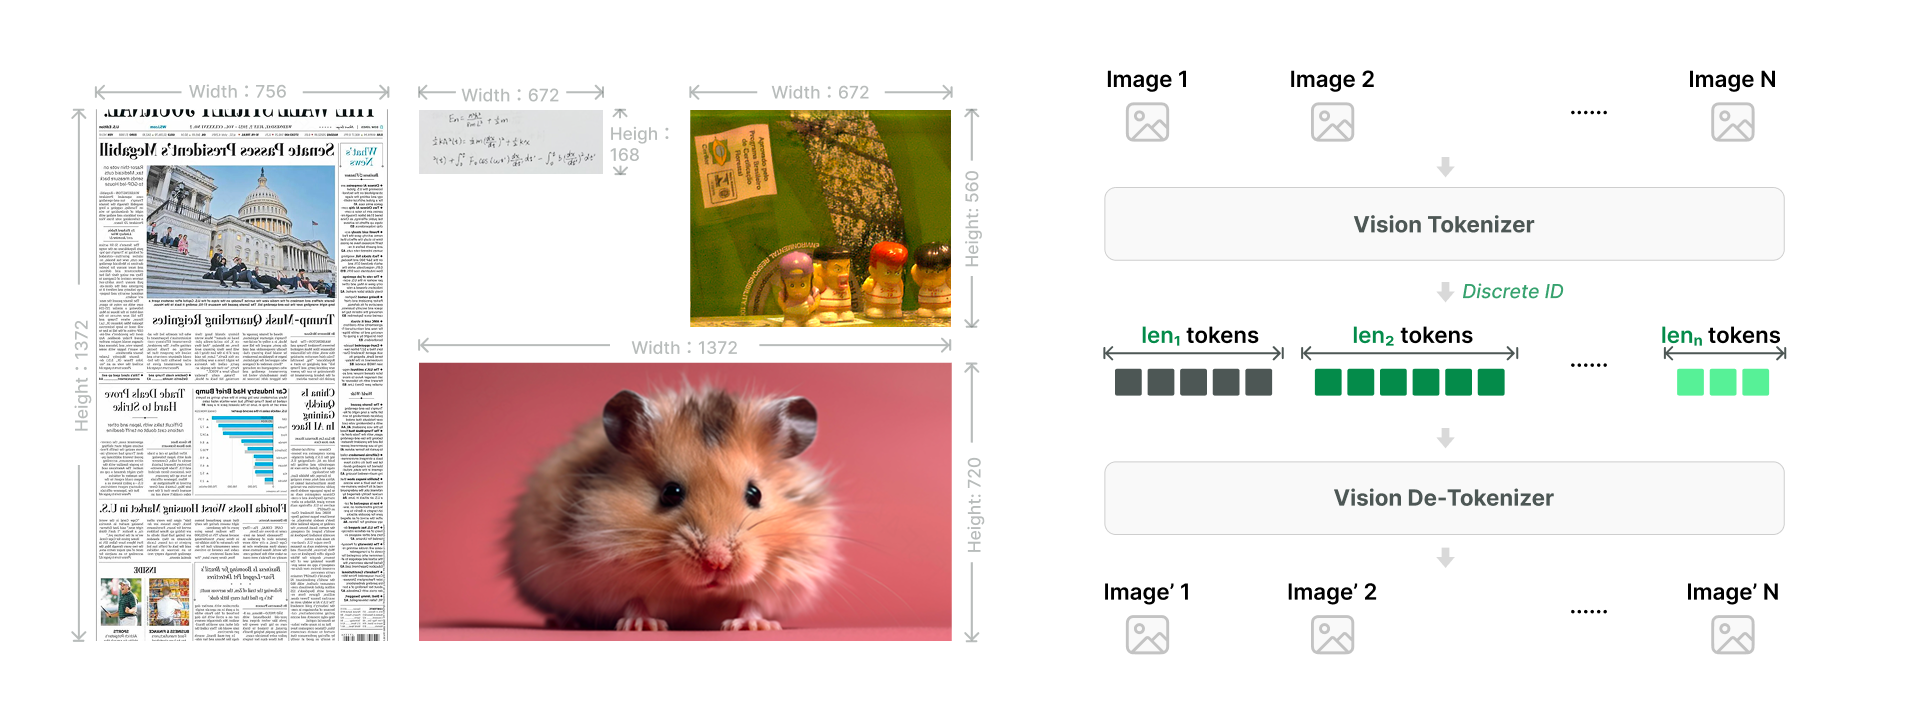
图源:tech.meituan.com 美团技术博客
这套设计让模型在 Visual Coding(视觉编程)上表现出色,并支持创意设计和 3D 等任务。一个有意思的细节:在平均激活参数约 3B 的小规模 MoE 模型上,视觉与文本 embedding 的 t-SNE 可视化呈交织分布,说明两者在共享语义空间里真正融合了。
智能体强化学习:拿失败轨迹当教材
这是 LongCat-2.5 训练链路里最值得说的部分。围绕长程智能体任务,它搭了一套完整的 Agentic RL 管线:
- 数据合成与环境构建:自动化生成训练任务、可交互环境和可验证的测试用例,数据来自 GitHub 公开仓库和内部真实场景的代码任务;对筛选后的 PR 和关联 issue,用 Agent 自动打标、合成环境,做 fail-to-pass / pass-to-pass 测试校验。
- 失败轨迹反哺:把真实 Agent 的失败轨迹转化为可复现、可验证的训练任务,针对模型能力短板持续补充训练数据——这相当于「考砸的题,下次专门练」。
- 异步 RL 与稳定性优化:用 partial rollout 异步训练缓解长尾效率问题,裁剪采样与训练时 logprob 的差异来限制样本陈旧性带来的梯度偏置。
- 防 reward hacking:在任务环境中断网、清除 git 历史和文件缓存,引入 LLM judge 监督轨迹,并对重复思考、重复工具调用施加惩罚。
图源:tech.meituan.com 美团技术博客
指标看板:介于 Opus 4.8 和 Opus 5 之间
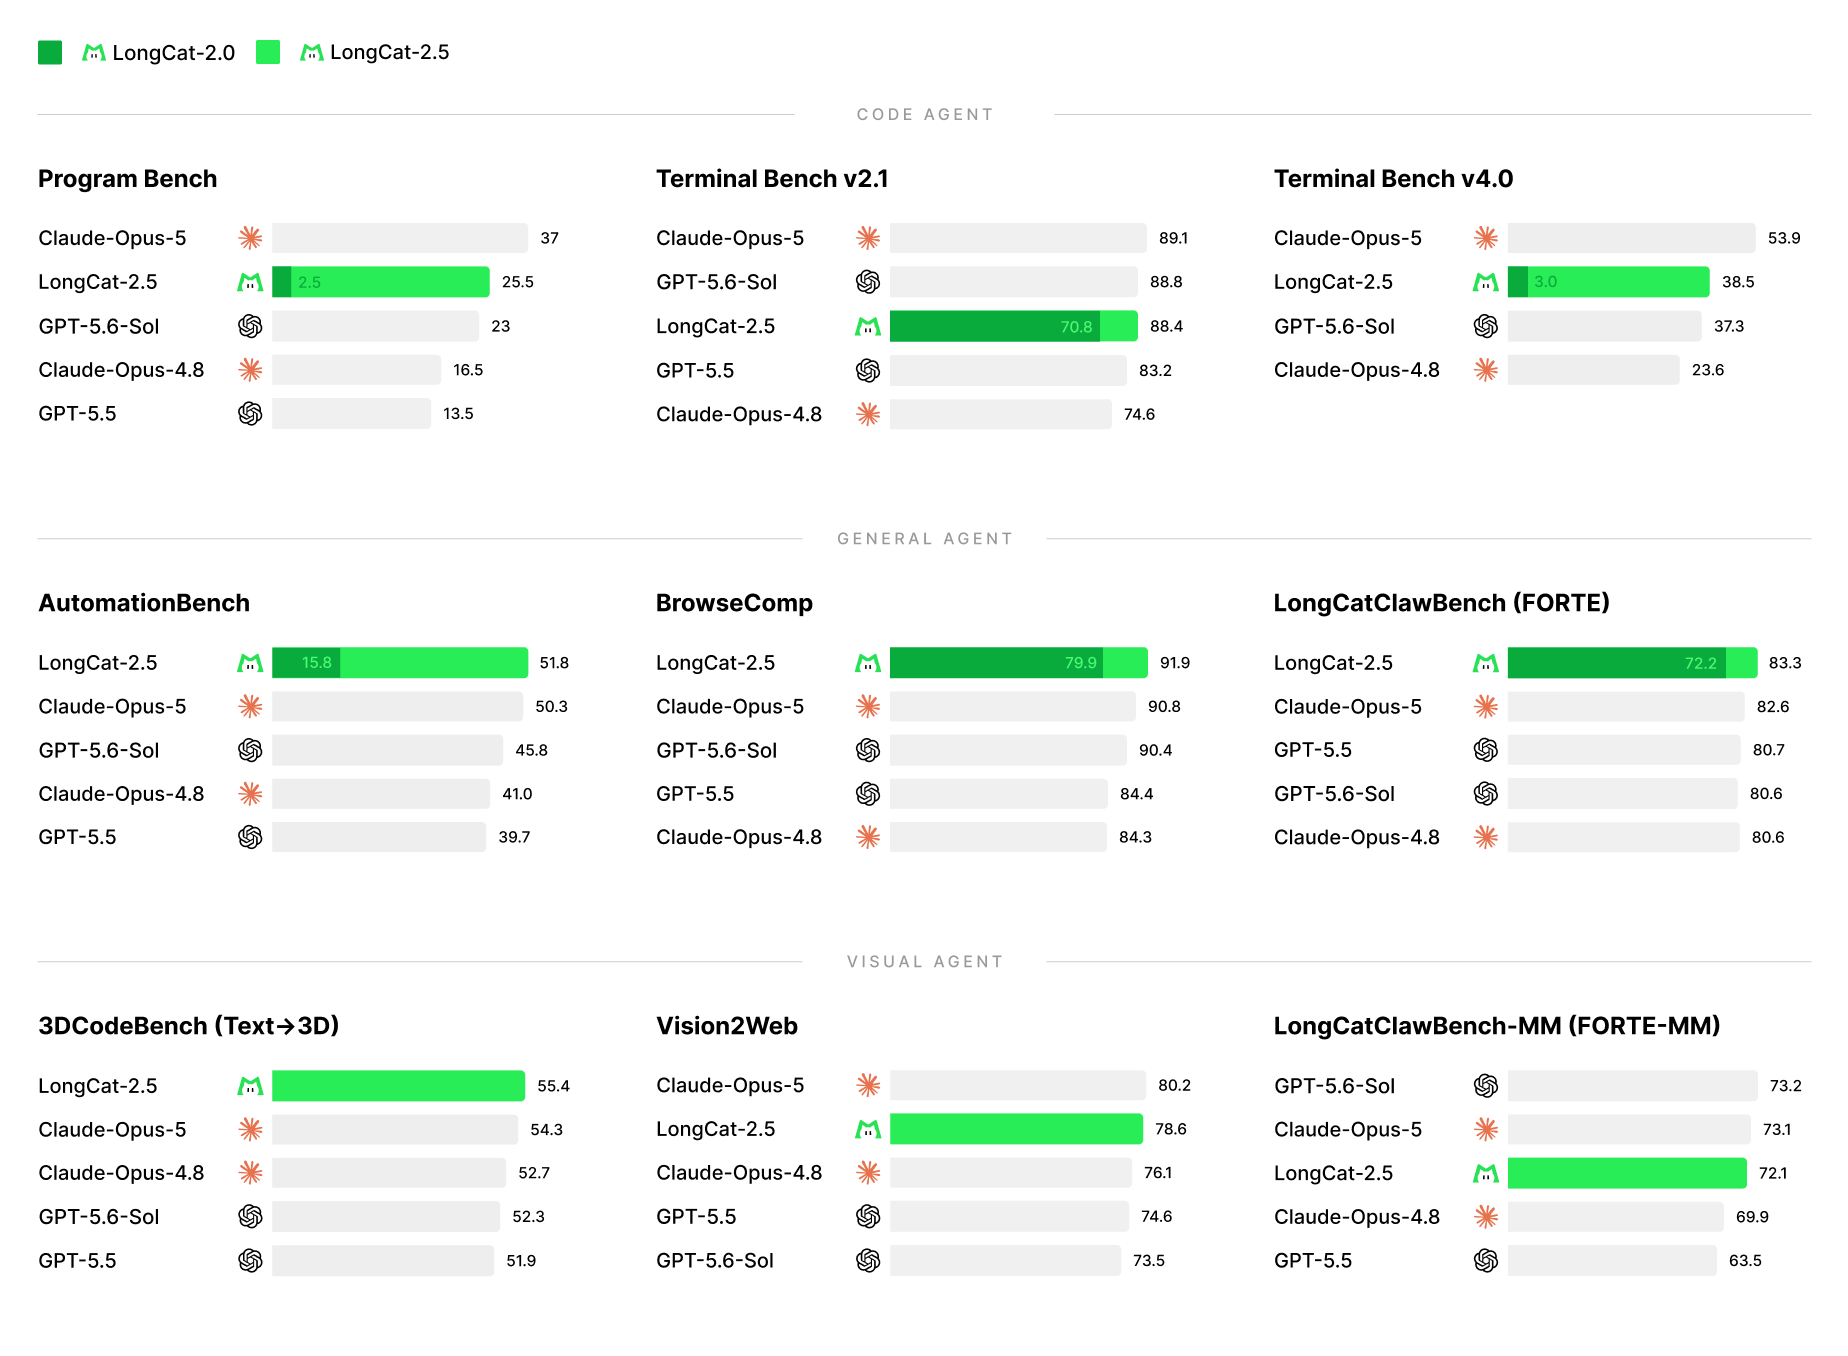
美团在技术博客里放了一张「指标看板」,选取 GPT-5.5、GPT-5.6-Sol、Claude-Opus-4.8、Claude-Opus-5 四个模型做对比。官方口径是:LongCat-2.5 的成绩介于 Claude-Opus-4.8 与 Claude-Opus-5 之间,并在部分评测中超过 Claude-Opus-5。
图源:tech.meituan.com 美团技术博客
需要提醒的是,这是厂商自报的评测结果,且对比模型的选择、口径都由美团自己设定——把它当作「能力定位参考」而非第三方权威结论更稳妥。
一个落地案例:看懂「增长的假象」
最能体现「服务主业」的,是技术博客里那个品牌多渠道经营分析的案例。模型能自主构建渠道利润表,识别出一个典型的增长质量问题:支付 GMV(商品交易总额)增长 23.2%,但渠道利润下降 1.7%,并结合清货经济价值、用户复购与库存风险,提出差异化资源配置建议——从经营核算、问题诊断到决策建议,完整走通一遍。
这个案例的价值在于:它演示的不是「写代码」或「写文章」这类通用能力,而是美团自己主业里最真实、最值钱的场景——帮商家看懂钱从哪里来、亏在哪里。
总结
- LongCat-2.5 的看点是「国芯国模 + 主业导向」:1.6 万亿参数全程国产算力训练,但目标不是通用聊天,而是商业分析与软件开发这两类主业能力。
- 训练方法上,把失败轨迹炼成训练数据是这套 Agentic RL 链路里最扎实的一步,比单纯堆算力更接近「把模型教聪明」。
- 视觉方案统一为「多层级离散 token」,与文本共享语义空间,为 Visual Coding / 3D / 创意设计打开空间。
- 自报评测介于 Claude Opus 4.8 与 5 之间,部分超过后者,但属厂商口径,第三方复现待观察。
- 那个「GMV 涨 23.2%、利润降 1.7%」的案例,是理解美团做模型逻辑的最好注脚:它要的不是一个更聪明的聊天机器人,而是一个能帮商家算清账的 AI 帮手。
图片出处:封面由 UU AI Hub 自制;正文配图取自美团技术博客 tech.meituan.com。