一句话总结
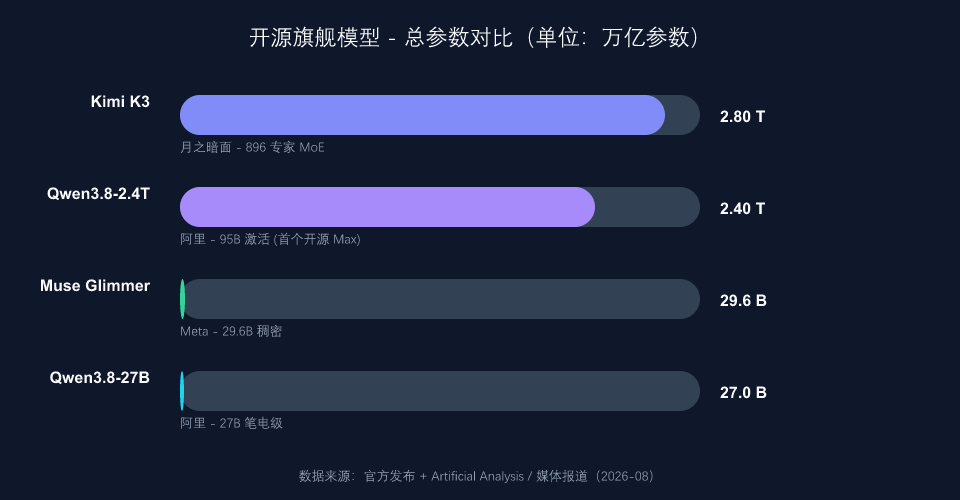
2026 年 8 月 13 日,阿里通义千问正式开放 Qwen3.8-2.4T-A95B 的模型权重——这是千问史上第一个开放权重的 Max 级旗舰,总参数 2.4 万亿、每 token 激活 95B,在 Artificial Analysis 开源权重榜单上以 58 分登顶。一周后的 8 月 18 日,阿里又发布可跑在笔记本上的 Qwen3.8-27B,正面迎战 Meta 的开源攻势。国产开源大模型,正从「能跑」进化到「能打」。
数据来源
本文事实依据来自:阿里通义千问官方发布、Artificial Analysis 榜单、PaperBench / Terminal-Bench 基准数据,以及 IT之家、至顶网、TechJuice、Capital & Compute 等多家媒体 2026-08-13 至 08-18 期间的报道。
什么是 Qwen3.8:阿里史上最大的开源模型
过去一年,国产大模型的竞争主轴从「闭源 API 拼价格」逐渐转向「开源权重拼能力」。阿里这次出手,直接把旗舰抬到了一个新高度。
Qwen3.8-2.4T-A95B 的核心参数:
| 维度 | 数值 |
|---|---|
| 总参数 | 2.4 万亿(阿里史上最大) |
| 激活参数 | 95B / token |
| 专家结构 | MoE,512 个专家,每 token 激活 11 个 |
| 原生上下文 | 262,144 tokens,可扩展至约 1.01M |
| 权重体积 | 约 893 GB,官方部署示例用 4 台 GB300 |
这里的关键词是「Max 级」。过去千问的 Max 系列(对标闭源旗舰)只通过 API 提供服务,权重从不开放;而开放权重的多是 7B、14B、72B 这类「小模型」。这一次,阿里把 2.4 万亿参数的旗舰直接开源,标志着开源模型的「天花板」被整体抬高了。
能力到底有多强:榜单数据说话
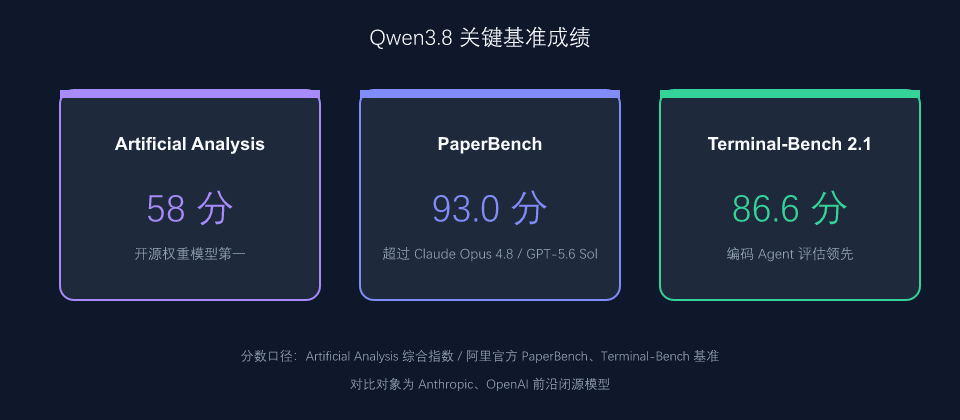
光参数大没用,得看分数。Qwen3.8 这次交出的答卷相当能打:
- Artificial Analysis Intelligence Index:58 分——截至 8 月 14 日,这是所有开源权重模型的最高分,超过了 Meta 的 Muse 系列和此前的 Kimi K3;
- PaperBench:93.0 分——阿里官方基准显示,它超过了 Anthropic 的 Claude Opus 4.8 和 OpenAI 的 GPT-5.6 Sol;
- Terminal-Bench 2.1:86.6 分——在编码 Agent 评估中领先 Anthropic 的旗舰。
换句话说,在「开源」这个赛道上,Qwen3.8 已经摸到了「闭源旗舰」的门槛。对开发者而言,这意味着不用付 API 费用、也不用把数据交给云端,就能在自家机房跑出接近前沿闭源模型的能力。
开源 ≠ 白送:Custom License 的门槛
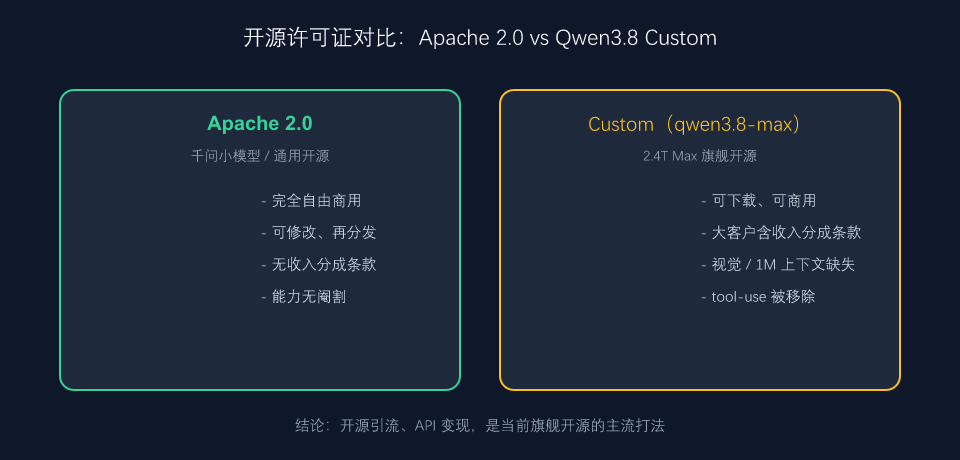
但「开源」这两个字,这次要打个引号。Qwen3.8-Max 使用的不是大家熟悉的 Apache 2.0,而是一份 custom(自定义)许可证:
- 据多家媒体报道,该许可证包含对大客户商业使用的「收入分成」条款;
- 开源版本阉割了部分能力:不支持视觉输入、上下文被封顶在 262K(而非 API 宣称的 1M)、内置工具调用(tool-use)被移除。
换句话说,阿里给的是「能跑起来、能商用」的旗舰权重,但把「完整的 Max 体验」留给了付费 API。这也是当前开源大模型的主流打法——用开源权重引流、建立生态,用完整能力的 API 变现。对个人开发者和中小团队,这份权重已经足够;对追求极致能力的大客户,依然需要回到云端。
27B 笔电级:把旗舰「塞进」笔记本
如果说 2.4T 是「给数据中心的核弹」,那 8 月 18 日发布的 Qwen3.8-27B 就是「给开发者的手枪」——小巧但趁手。
- 27B 稠密多模态模型,阿里官方称其 Agent 编码能力「逼近 Claude Opus 级」;
- 可配合高位量化跑在单张消费级 GPU 上,甚至适配笔记本;
- 与联发科天玑芯片达成 Day-0 全场景适配(手机→车机→端侧),打通端侧 AI 的「最后一公里」。
这套「旗舰开源 + 端侧小模型」的组合拳,正好踩在 Meta 的节奏上:Meta 在 8 月 5 日发布 Muse Spark 1.2(1M 上下文、异步工具调用),8 月 10 日又放出 29.6B 的 Muse Glimmer。中美两边的开源巨头,正在用同一套打法正面硬刚。
怎么部署:GB300 NVL72 / vLLM / SGLang
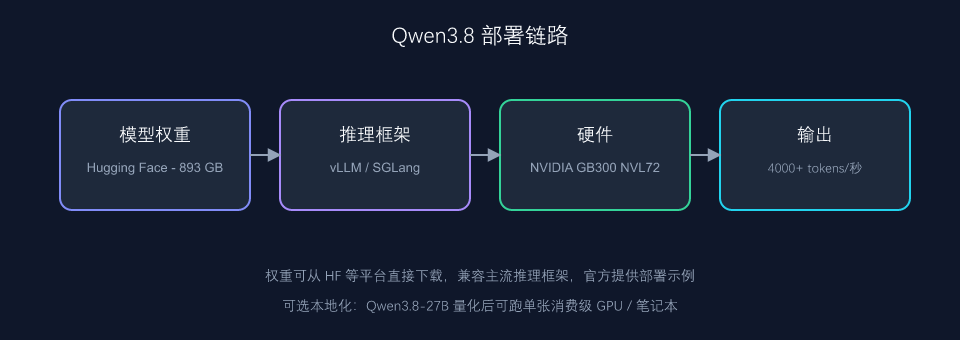
对想真正跑起来的人,部署门槛已经标准化:
- 推理框架:兼容 vLLM、SGLang 等主流框架;
- 硬件:官方针对 NVIDIA GB300 NVL72 优化,单 GPU 推理速度超过 4000 tokens/秒;
- 本地化:权重可从 Hugging Face 等平台直接下载,官方提供了从下载到服务的完整部署示例。
适合人群
- AI 应用开发者:想用接近前沿的能力、又不想被 API 价格和延迟绑架;
- 有私有化部署需求的企业:数据不出内网,模型自己掌控;
- AI 研究员:研究 MoE 架构、做微调和对齐实验;
- 端侧 / 硬件厂商:基于 27B 做本地化、车机、手机等落地场景。
总结
阿里这次的开源动作,释放了三个信号:
- 开源天花板被抬高:2.4T 旗舰权重首次开放,开源模型首次在 AA 榜单压过所有同行;
- 「开源引流 + API 变现」成为标配:Custom License 的收入分成条款,是商业上更成熟的打法;
- 中美开源正面交锋:阿里 2.4T + 27B 对标 Meta Muse 系列,开源竞赛进入「旗舰对旗舰」阶段。
对国内开发者,这是一次难得的窗口——用一台 GB300 或一块好显卡,就能跑起接近前沿的模型。开源生态越繁荣,普通人的选择就越自由。
相关阅读:阿里云通义千问工具页 · Kimi K3 深度解读