一句话
1.0 这个数字在本地推理圈里不代表「功能做完了」,而是代表「上下游的接口从此要有边界」——llama.cpp 选在 3.5 年的节点上把这个边界画出来,顺手把 llama-server 的一堆远程访问口子堵上了。 对普通用户,1.0 没有换引擎;对把 llama.cpp 当库用、或者把 llama-server 摆在局域网里的人,这一版是必须处理的。
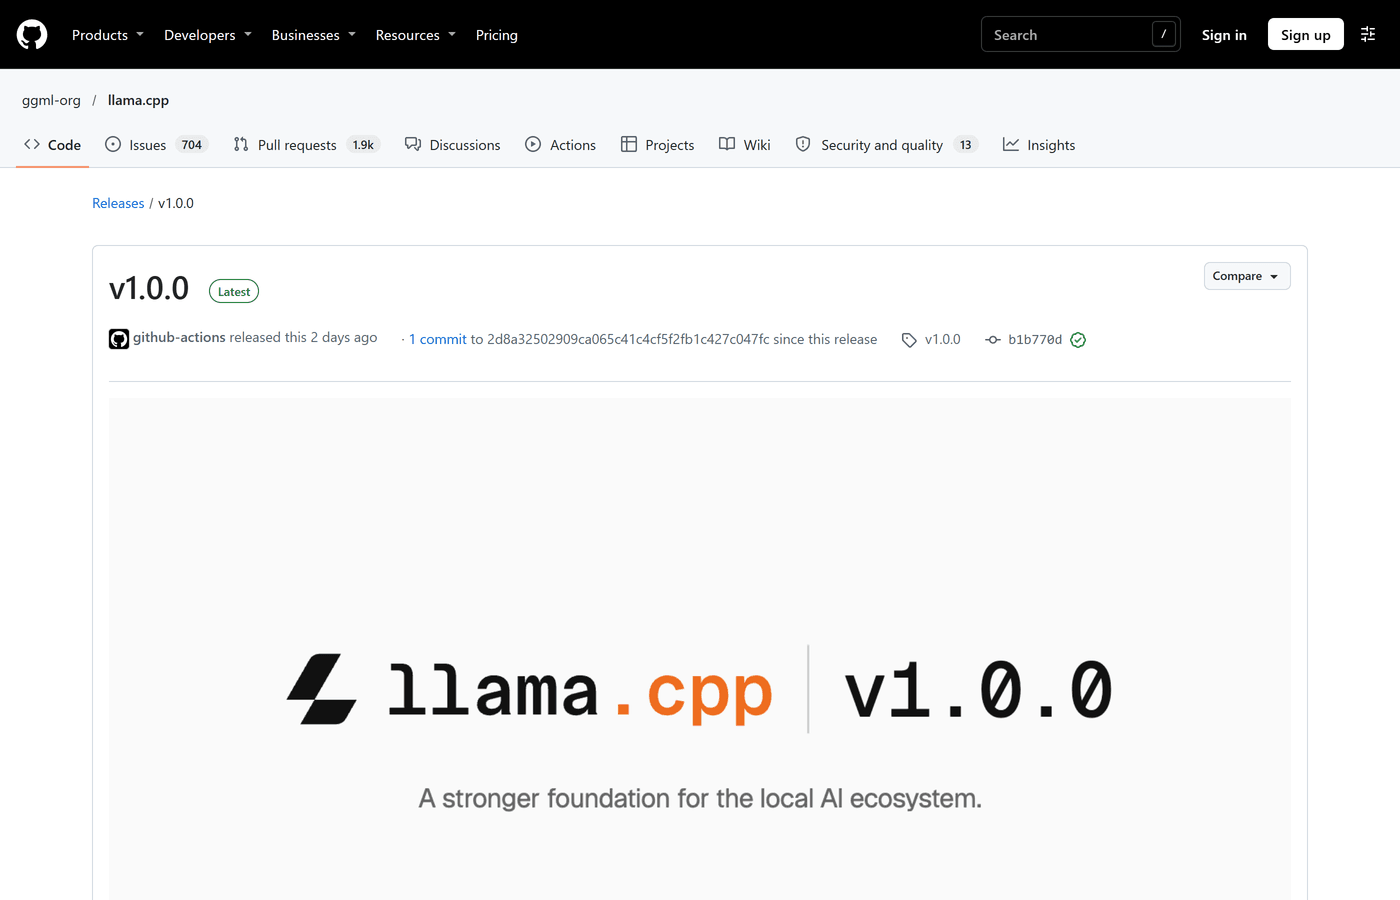 图源:github.com/ggml-org/llama.cpp releases/tag/v1.0.0
发布了什么
11 月 13 日,llama.cpp 与它的底层张量库 ggml 在同一小时内各打了一个 v1.0.0 标签(ggml 08:34 UTC,llama.cpp 10:20 UTC),并配了一篇名为《A stronger foundation for the local AI ecosystem》的公告。
| 项目 | 事实 |
|---|---|
| 版本 | llama.cpp v1.0.0(libllama)+ ggml v1.0.0(libggml) |
| 发布日 | 2026-11-13 |
| 起点 | 2023-03-10 首个提交,3.5 年 |
| 仓库规模 | 135,070 stars / 25,616 forks(2026-11-15 查询) |
| 夜间构建 | 编号已排到 b12387(2026-11-14 19:26 UTC) |
| 架构覆盖 | 官方称支持 150+ 模型架构变体,含主流投机解码方法 |
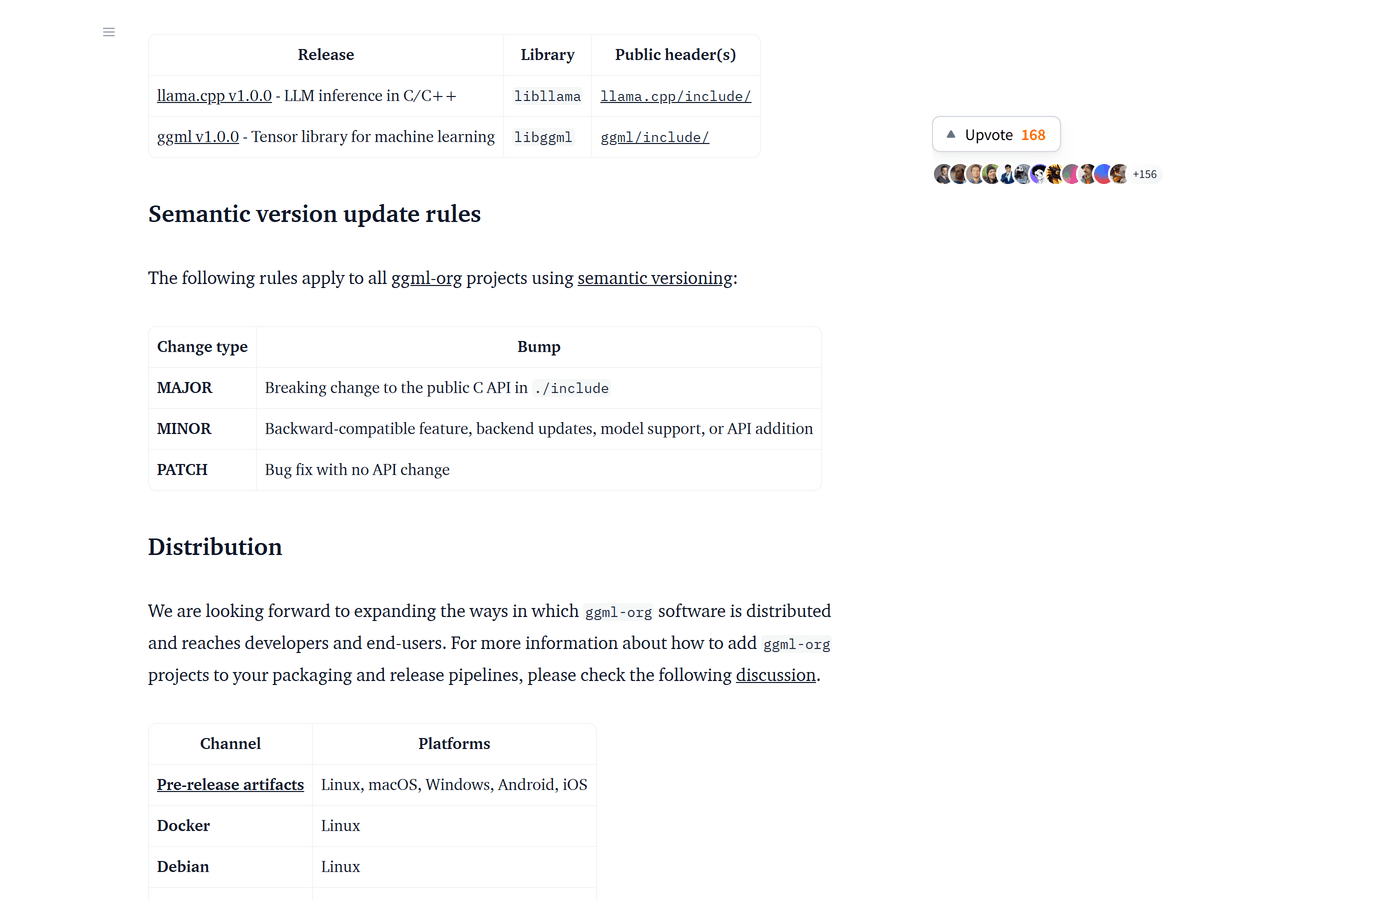
| 分发渠道 | 预编译产物(Linux/macOS/Windows/Android/iOS)、Docker、Debian、Homebrew、conda-forge、MacPorts、Winget、XCFramework |
把夜间构建号除以天数,这 3.5 年里平均每天落在 master 上的构建大约 9 个。这不是一个小项目在发版,而是一条一直在高速迭代的流水线,终于决定给自己装一个限速牌。
1.0 的意思:给下游一纸可执行的承诺
官方公告里最能说明问题的一句是:「每一个新集成都意味着更多开发者依赖我们的库接口,因此一个灵活但稳定的 API 至关重要。」 紧接着是规则:
| 变更类型 | 版本号怎么跳 |
|---|---|
| MAJOR | ./include 下的公开 C API 发生不兼容变更 |
| MINOR | 向后兼容的新特性、后端更新、新增模型支持、新增 API |
| PATCH | 纯 bug 修复,不动 API |
这套规则对三类人意义完全不同:
- 写应用的人:以前升级 llama.cpp 得逐条读 release notes,怕某个函数悄悄改名;现在 MAJOR 不动,就可以放心跟着 MINOR 走。
- 打包的人:Debian 的维护者在讨论区里说得很直白——有了语义化版本才能维护 SOVER,才敢把 llama.cpp 当共享库装进公共搜索路径。这解释了为什么这次的公告没有先讲性能,而是先讲版本规则。
- 跑本地模型的人:影响最小。1.0 不会让你的模型突然变快,也不会让旧脚本失效。
 图源:huggingface.co/blog/ggml-org/llama-cpp-v1
还有一个容易忽略的工程约束:llama.cpp 内部带着一份 ggml 副本,只有当这份副本与已发布的 ggml 完全一致时,官方才会打 vX.Y.Z 标签。这样从 release tag 构建、并链接系统级 ggml 的下游,才不会撞上 ABI 不匹配。同一份文档也承认,llama.app 桌面端目前仍只发布 nightly,还没切到 release tag。
版本号之外,这一版实际改了什么
安全修复之外,1.0.0 的内容对得上「MINOR 全都要塞进来」的定位:
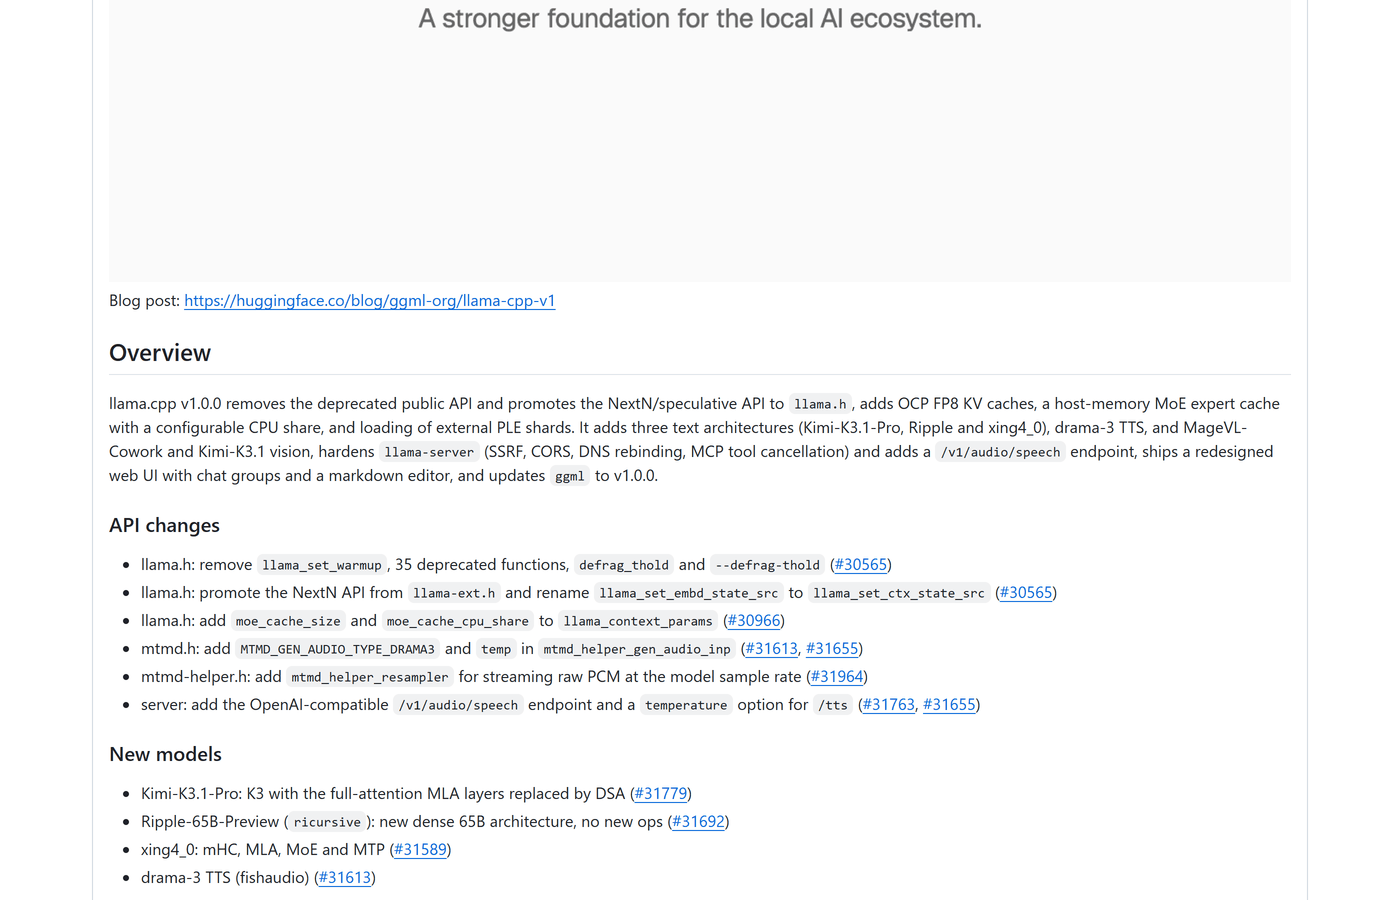
接口清理
- 从
llama.h删掉 35 个废弃函数、llama_set_warmup和defrag_thold(及其命令行参数) - 把 NextN(投机解码)API 从内部的
llama-ext.h提到公开的llama.h,llama_set_embd_state_src更名为llama_set_ctx_state_src llama_context_params新增moe_cache_size与moe_cache_cpu_share
省显存的两处
- FP8 KV cache:
-ctk/-ctv f8_e4m3可用,还能配静态的 per-tensor scale。KV cache 从 16 位降到 8 位,长上下文的显存占用直接减半,这是消费级显卡跑长文本最实际的一条。 - MoE 专家缓存可以把一部分未命中放到 CPU 上算,再异步拷回;替换策略换成 LRFU / ClassLRU,命中缓存时不再等 CPU。对「模型参数远大于显存」的 MoE 场景,这是能决定跑不跑得动的一档。
模型支持
新增 Kimi-K3.1-Pro(把 K3 的全注意力 MLA 层换成 DSA)、Ripple-65B-Preview(新的稠密 65B 架构,没有引入新 op)、xing4_0(mHC + MLA + MoE + MTP)、drama-3 TTS,以及 MageVL-Cowork 与 Kimi-K3.1 的视觉输入。server 侧补了 OpenAI 兼容的 /v1/audio/speech。
ggml 侧
删掉废弃 API 与 DIAG_MASK_INF/DIAG_MASK_ZERO 两个旧 op,RPC 协议升到 v9 并会拒绝不兼容的对端;YaRN 的截断行为可用 ggml_rope_set_truncate 控制;CUDA/Metal 加了少行量化矩阵乘与 MoE 融合,Vulkan 有了 prefill 的 FlashAttention 路径。
 图源:github.com/ggml-org/llama.cpp releases/tag/v1.0.0
最该看的一段:llama-server 的安全修复
如果你只是在本机 llama-cli 里聊天,下面这段可以跳过;如果你把 llama-server 起在 0.0.0.0 上,让同一局域网、甚至公网能访问,这段就是升级理由:
| 修的问题 | 实际风险 |
|---|---|
--cors-origins 处理不当 | 任意网页都能跨域打到你的本地 server |
| DNS rebinding | 恶意网页通过域名重绑定绕过同源限制,直接操作你本机的模型服务 |
| CORS 代理的 SSRF | 让 server 去请求任意内网地址,变成打内网的跳板 |
| 子实例访问控制 | 多实例/子进程之间的边界没管住 |
| MCP 工具调用不取消 | 客户端断开或超时后,工具还在后台跑 |
同时新增两个「默认收紧、要用得显式打开」的开关:--allow-unauthenticated-tools 和 --media-allow-private-urls;HF_TOKEN 被限制成只发给 huggingface.co 的主机(避免被诱导把 token 送到别处)。
这一组问题的共同点是:它们只在「server 对别人可达」时才成立,所以本地自用的人几乎感受不到,而把它当家庭服务器 / 小团队共享端点的人风险最大。升级不需要改配置,默认值就是更安全的那一侧——但如果你之前依赖「不鉴权也能调工具」的行为,升级后会失败,这是预期内的。
什么时候该升,什么时候可以等
- 该升:llama-server 对外可达;显存吃紧想上 FP8 KV;跑 MoE 但显存小于模型;你在打 Debian/Homebrew/conda 包。
- 可以等:只在本机用某个图形前端(Ollama、LM Studio 之类各有自己的升级节奏,它们内置的 llama.cpp 版本通常滞后一段时间);或依赖某个已被删掉的废弃函数。
- 别误解:1.0 不等于服务端 REST 接口冻结。官方讨论里明确说,只有推理端点(completions、embeddings)的破坏性变更才算 MAJOR,router、工具、CORS 代理这些改动仍按 patch 处理。
 图源:llama.app
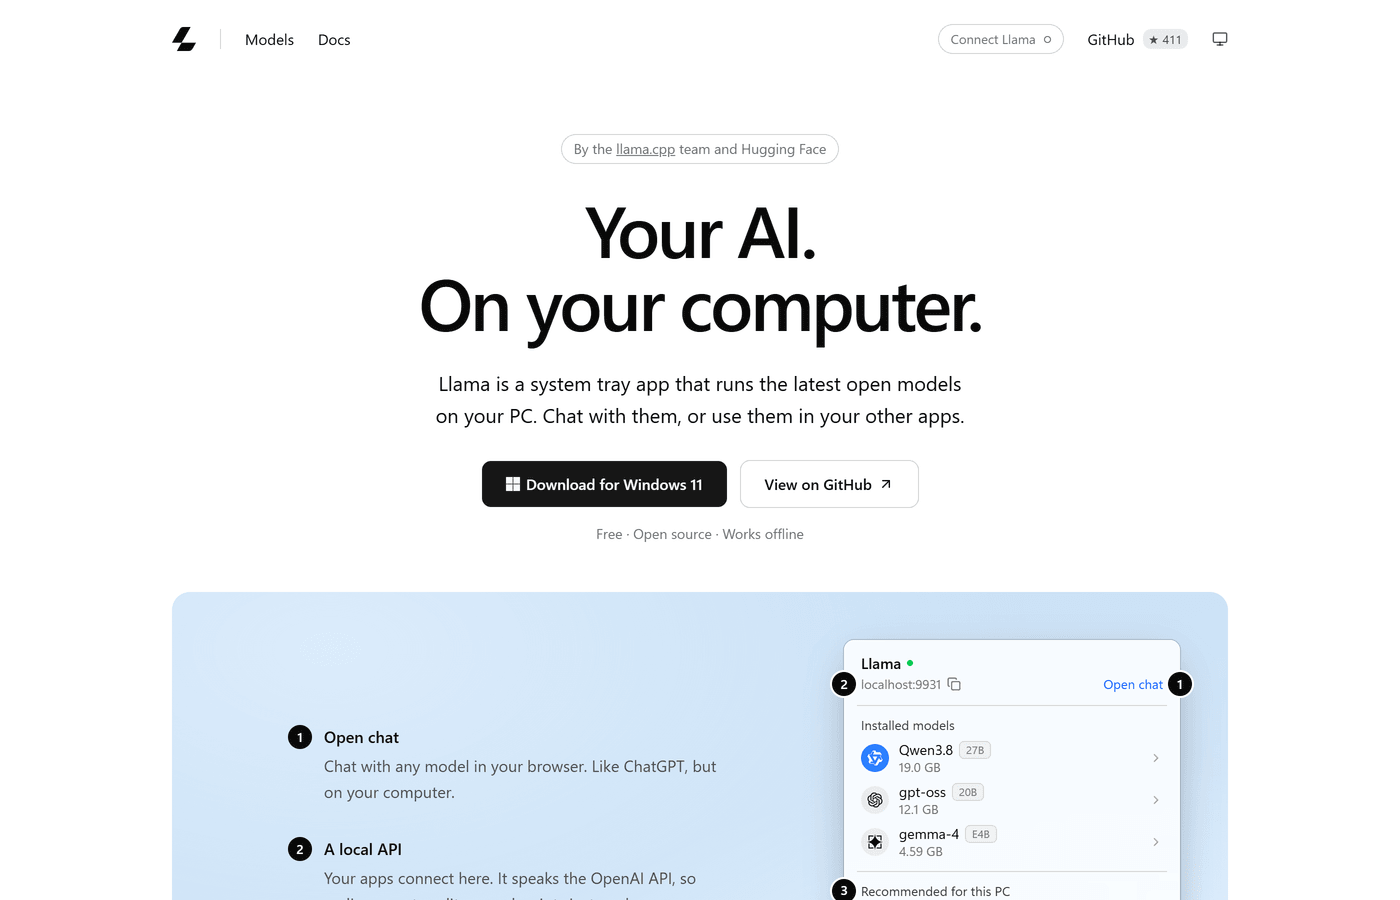
顺带说一句官方桌面端:llama.app 由 llama.cpp 团队与 Hugging Face 一起做,装上就是本地跑模型 + 一个 OpenAI 兼容的 localhost:9931 本地 API。它现在跟的仍是 nightly 通道,所以「1.0 发布了」这句话暂时不适用于它的下载包——想要 release 版本,得走 GitHub 的 release 清单或各发行版的包管理器。
一句话结论
这次 1.0 是一次「接口立规矩 + 安全补洞」的发布,功能增量排在第二位。 对生态来说,这是本地推理从「大家各自跟 master」走向「可以当依赖」的分界线;对个人用户来说,真正的行动项只有一条:把对外可达的 llama-server 升上来,然后确认自己的配置没有依赖那些默认关闭的新开关。
数据与截图取自 2026-11-15:GitHub 仓库 API、llama.cpp 与 ggml 的 v1.0.0 Release 说明、Hugging Face 官方公告、ggml-org 的版本与分发讨论帖(#1579)。