一句话
Edge0 把 145B 参数搬到了个人电脑上,这是一件真事;但「在笔记本上、29GB、80 tok/s」这句话里的四个数字,分别属于三层存储、一个没写型号的机型,和厂商自己的测速表。 工程部分值得读,宣传口号值得逐条对一遍。
它到底发布了什么
11 月 12 日,Edge0(公告署名 AutoArk)开源了两个模型和一个推理框架:
| Edge0-145B | Edge0-120B | |
|---|---|---|
| 总参数 | 145B | 120B(专家更小) |
| 每次推理激活 | 约 10.12B | 8.64B |
| 结构 | 48 层 × 512 个专家,每层激活 10 个 + 1 个共享专家 | 同构 |
| 上下文 | 256K(服务端默认按 131,072 起) | 同 |
| 基座 | 派生自 Qwen3.8-Flash-Next(Qwen 官方卡:125B / 6B 激活) | 同 |
| 量化版本 | Q3_K、NVFP4(官方称「原生按 4bit 训练」) | Q3_K、NVFP4 |
| 许可 | edge0-community-model-1.0 + 上游 Qwen 社区许可 | 同 |
官方定位是「世界首个开源的、145B 参数的端侧模型」,主打三件事:装得下、跑得动、数据不出本机。九月它还发过一个能在手机上跑的 35B(官方称 iPhone 18 Pro Max 上 37+ tok/s、约 2.5GB 内存)和一个 8B 检查点。
「29GB 峰值内存」是怎么算出来的
这是全篇最需要停下来算一笔账的地方。145B 参数塞进 29GB,等于每个参数 0.2 字节,也就是 1.6 bit——没有任何 3bit/4bit 格式能做到这个数。而实际下载下来的 Q3_K 权重是 105.4GB,折合每个参数 0.73 字节、约 5.8 bit。
差额藏在官方博客自己写的那段三级存储里:
- 约 40GB 的专家库常驻系统内存,需要时搬进显存;
- 约 48GB 的词表数据放在 SSD 上按需读取(就是仓库里那个 51.2GB 的
ple-fp8.gguf); - 显存里只留「热专家」。
官方技术文档给的实际测量更直接:Q3_K 构建的权重是 40.81 GiB,在内存压力下拆成 23.14 GiB 显存 + 31.28 GiB 主机内存,合计 54.4 GiB,文档强调「两套专家互不重叠,没有重复计算」。
所以 29GB 是这个流水线里某一层的峰值,不是「这个模型占 29GB 内存」。同一页的说明段落里,官方给出的峰值内存还比表里少 1GB——两处口径本身就是不一致的。
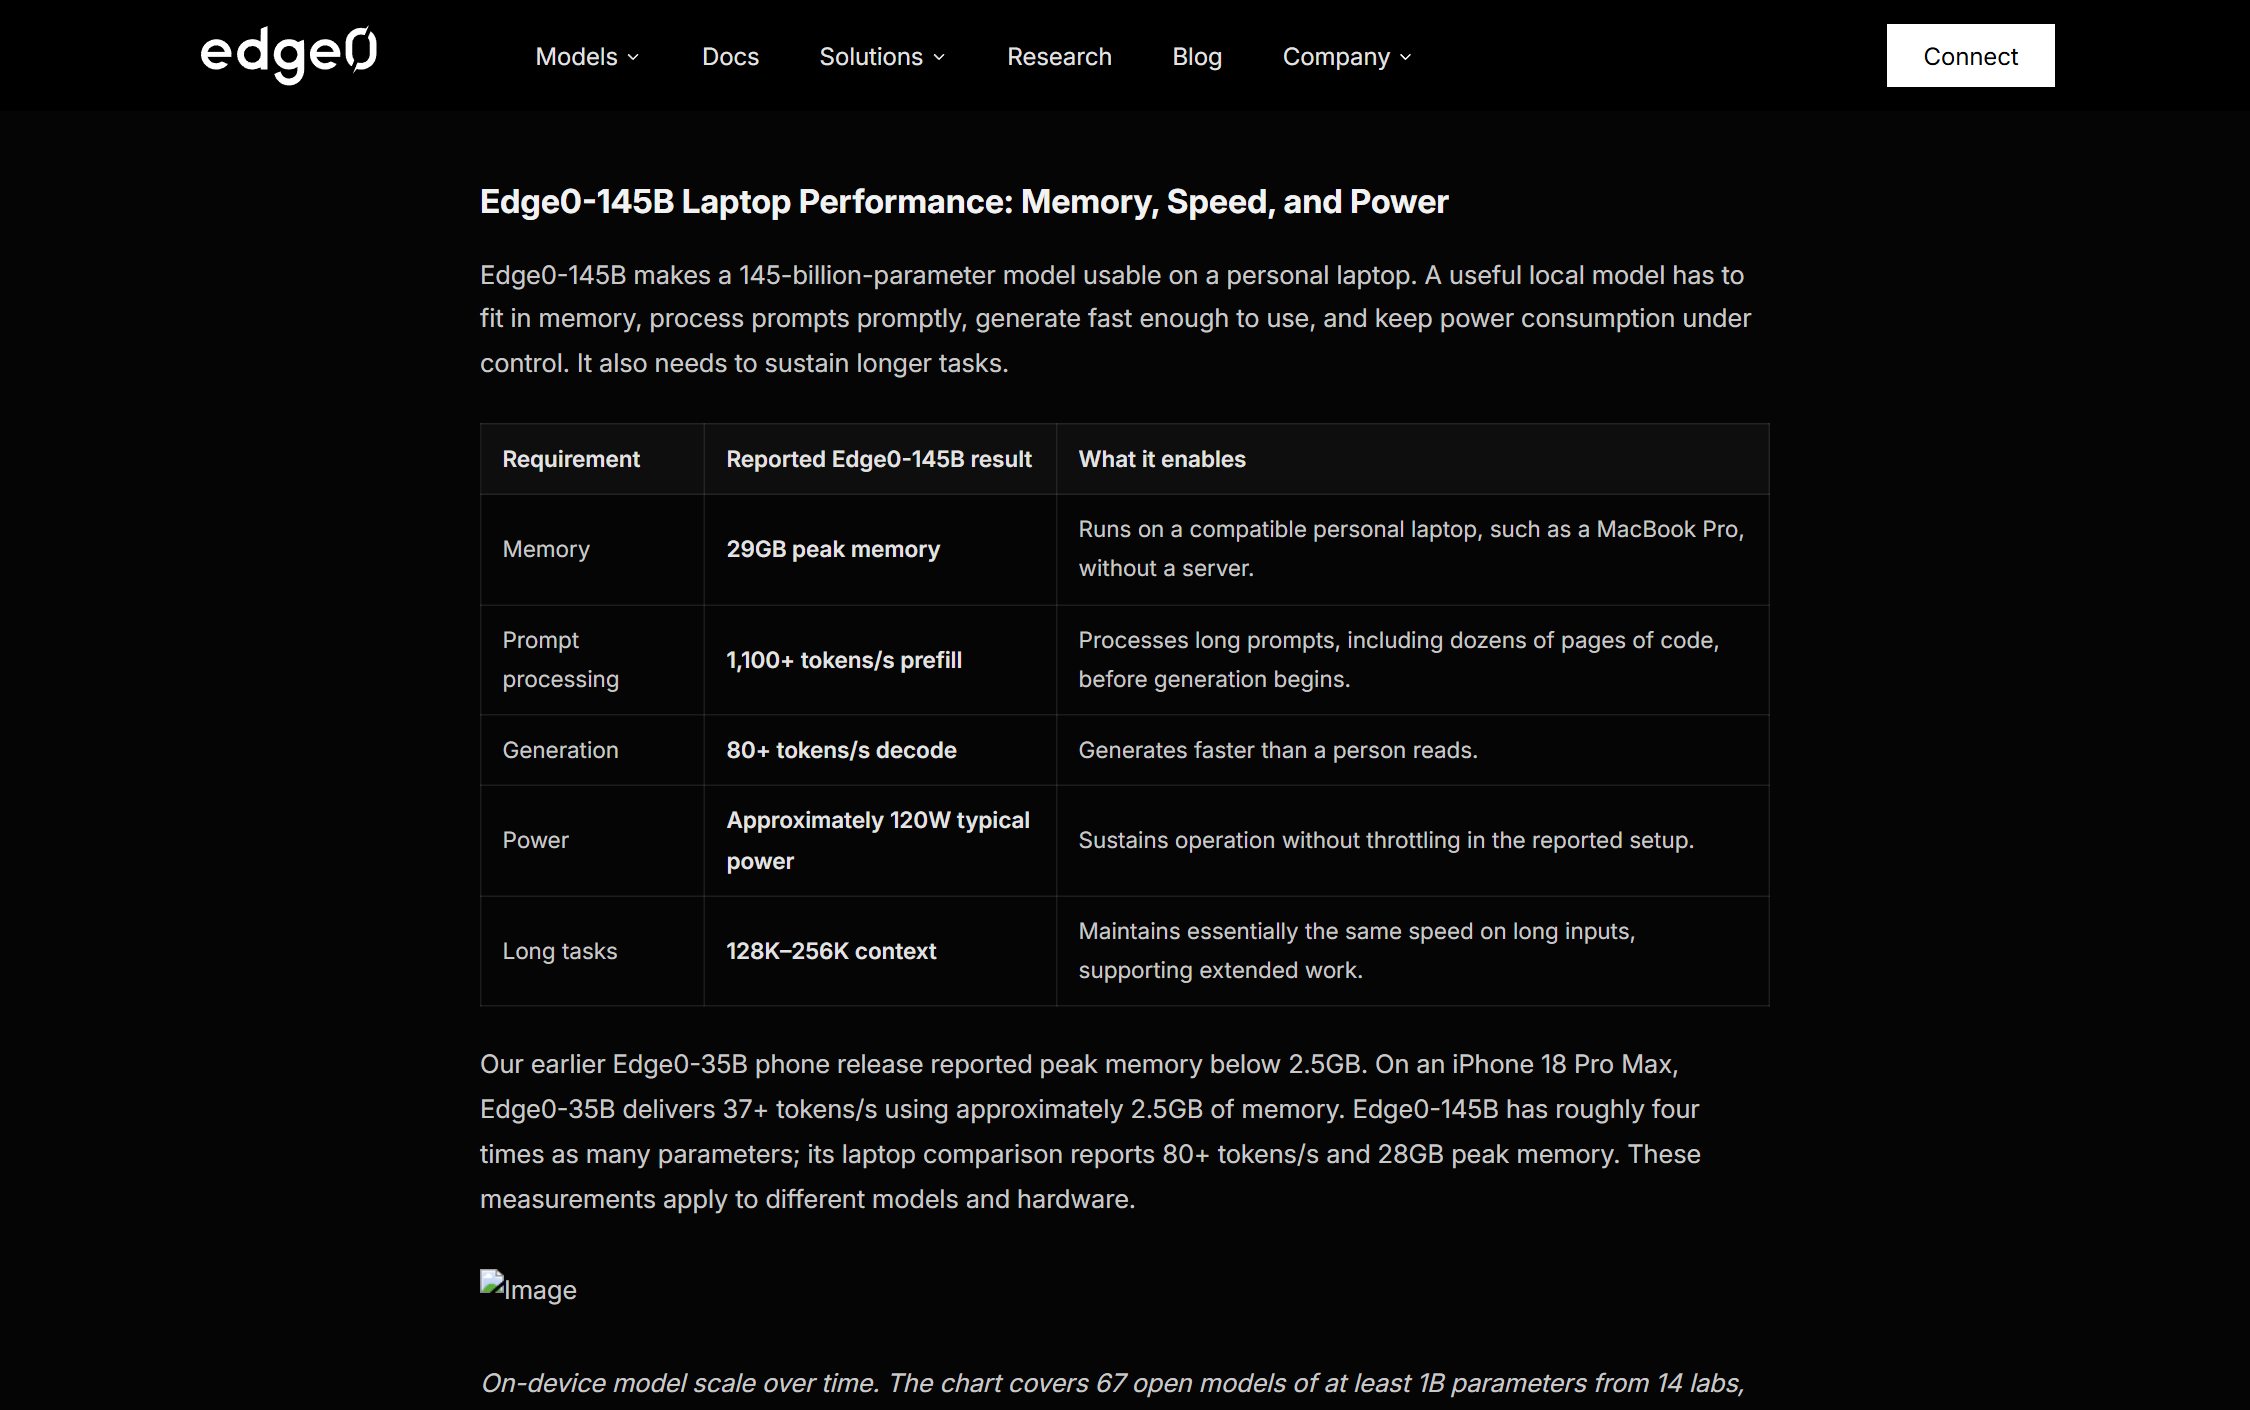
图:Edge0 官方发布文的性能表,注意下方说明段落给出的峰值内存比表里少 1GB。图片来源:edge0.ai
仓库里躺着的东西,比发布文更好读
权重是公开的,四个仓库都能直接下,没有申请门禁。截至 11 月 14 日的文件体积:
| 仓库 | 专家格式 | 文件数 | 下载体积 |
|---|---|---|---|
| Edge0-145B-q3k | Q3_K | 93 | 105.4 GB |
| Edge0-145B-NVFP4 | NVFP4 | 45 | 112.9 GB |
| Edge0-120B-q3k | Q3_K | 92 | 92.3 GB |
| Edge0-120B-NVFP4 | NVFP4 | 44 | 97.6 GB |
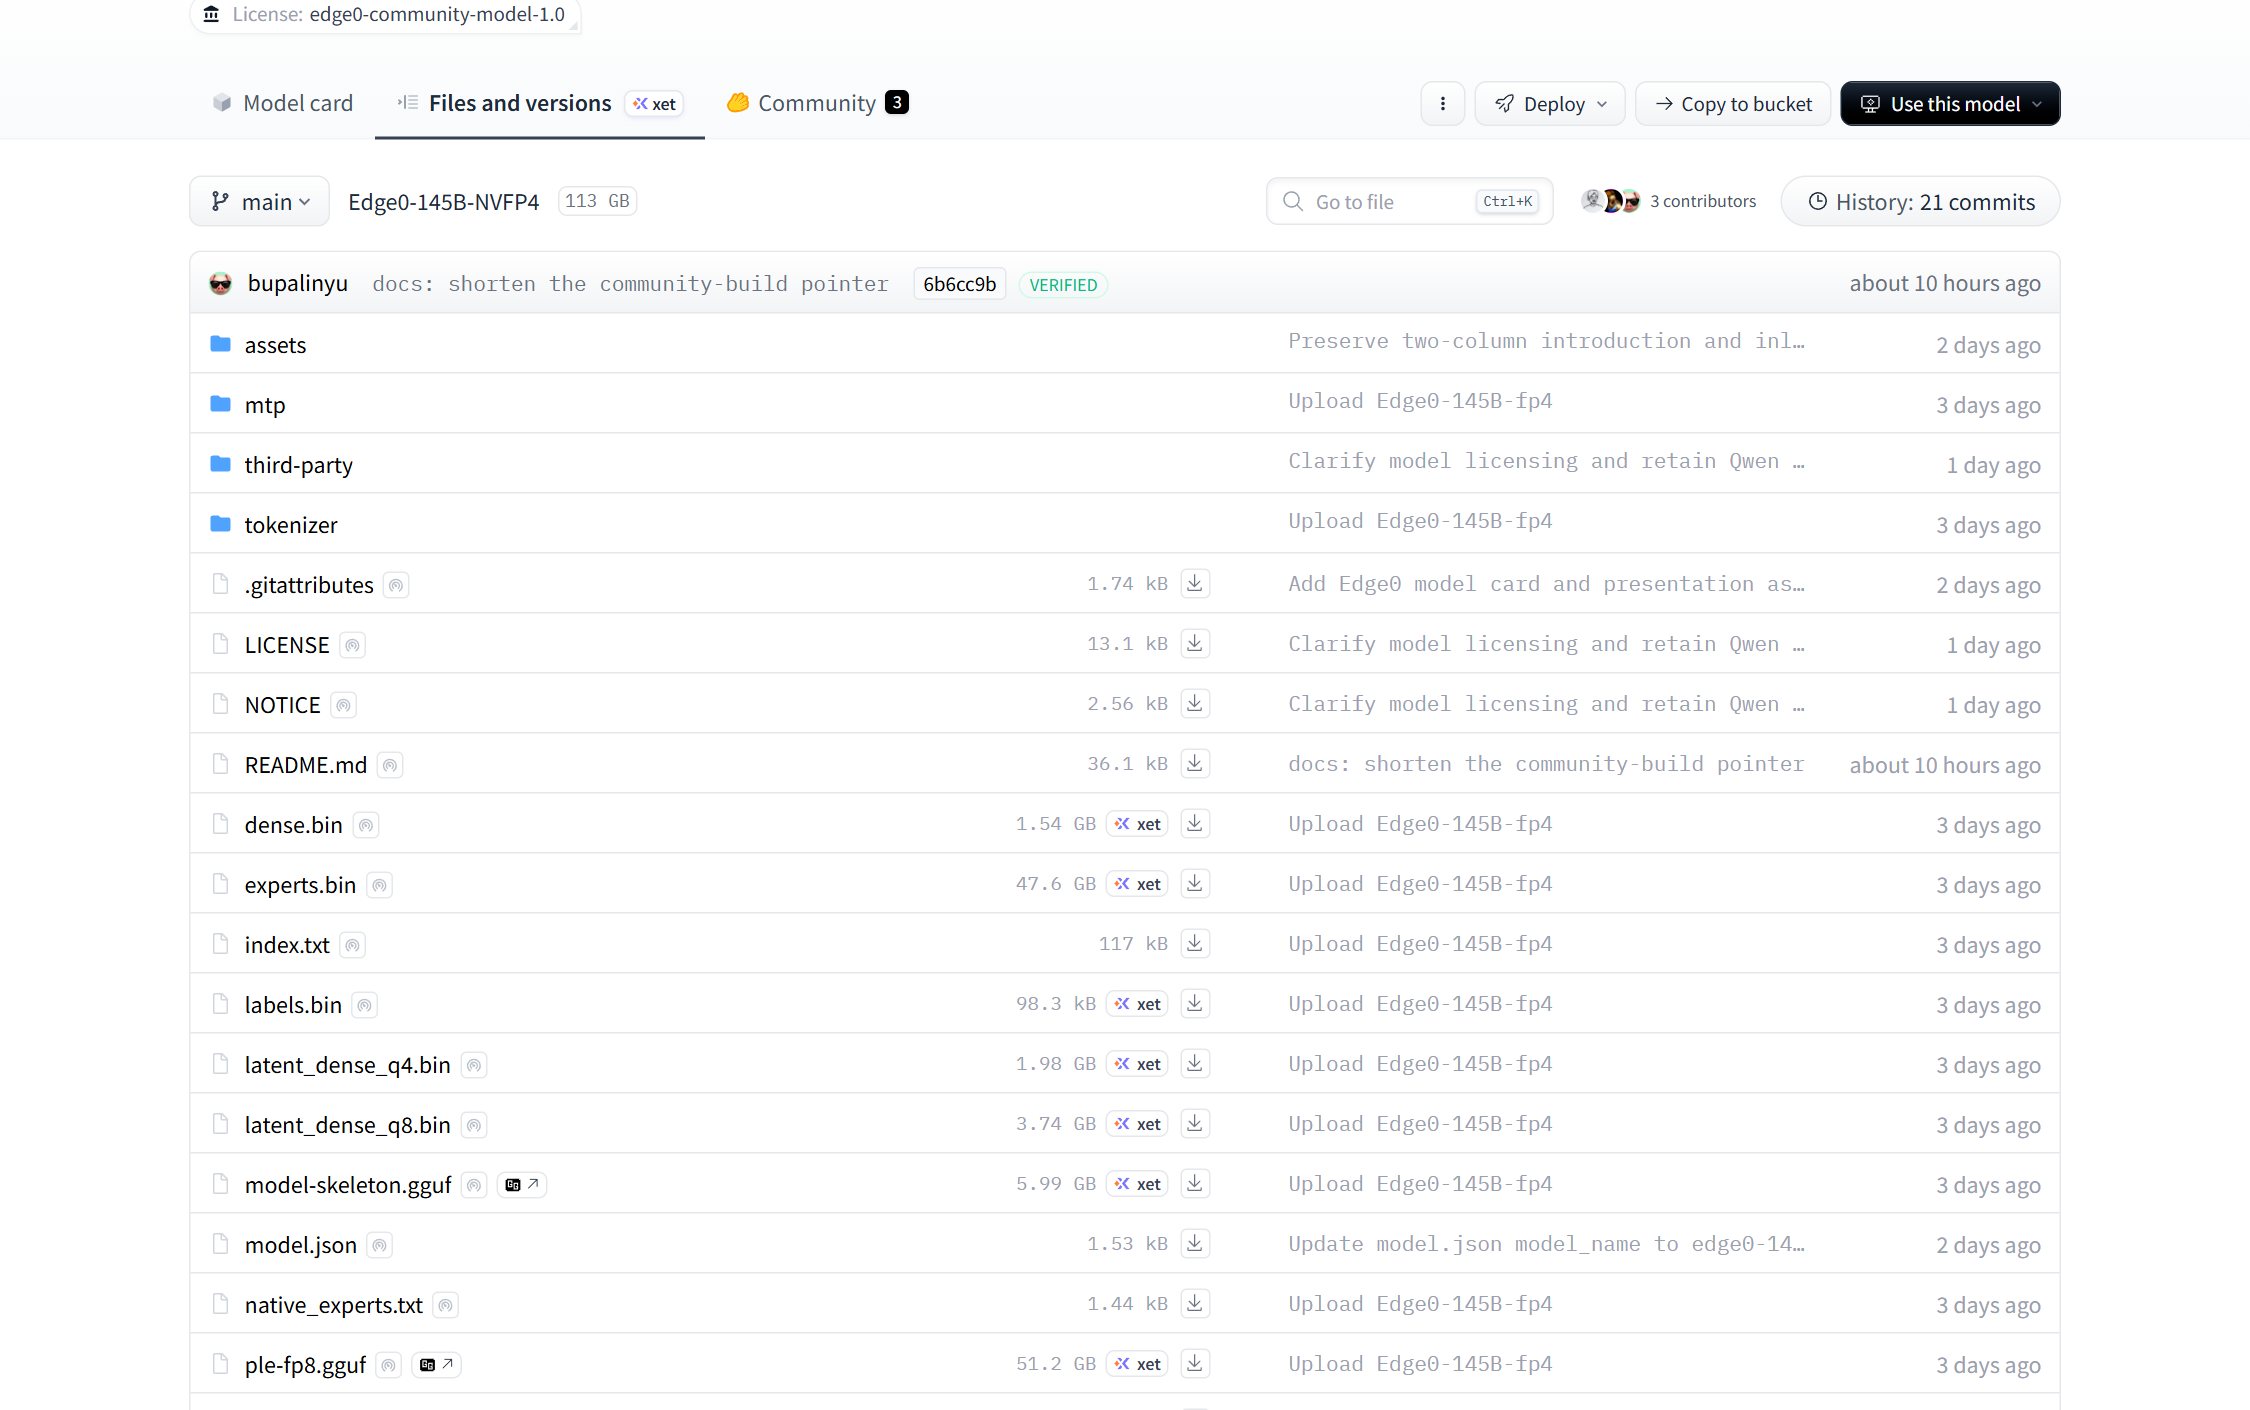
图:Edge0-145B-NVFP4 仓库文件与体积,最大两件是 47.6GB 的 experts.bin 和 51.2GB 的 ple-fp8.gguf。图片来源:huggingface.co/Edge0
这个文件结构决定了另一件事:它不是一个能塞进现成工具的 GGUF。仓库里是 5.99GB 的 model-skeleton.gguf 加一堆 experts.bin,Hugging Face 的参数计数器只读骨架,给这个「145B 仓库」报出来的是 4.95B 参数。Ollama、LM Studio、llama.cpp 都加载不了它,只能跑 Edge0 自己的推理引擎。
发布文和仓库文档对不上的四处
| 项目 | 发布文的说法 | 仓库/文档的说法 |
|---|---|---|
| 平台 | 「day-one 支持 macOS、Windows、Linux,含 Apple M 系列」 | 文档要求「Linux or Windows with an NVIDIA GPU and CUDA 13」;v0.2.0 发行版标注 Windows only;平台表里 macOS 是空的;模型页注明 M2 Ultra 的测速「不代表 macOS 已发布」 |
| 内存 | 29GB 峰值(同页说明段落少 1GB) | 权重 40.81 GiB,实测拆成 23.14 GiB 显存 + 31.28 GiB 内存 |
| 机型 | 「兼容的个人笔记本,例如 MacBook Pro」 | 速度表里全是 RTX 5090 D 24GB、RTX 4090、RTX Spark N1X 60GiB——一台台式卡 |
| 许可 | 「open-sourcing」 | 许可名 other/edge0-community-model-1.0:个人与研究可用、可改、输出可商用;模型销售、付费推理服务、独立的商用编码或办公助手需要另外的书面许可,上游 Qwen 社区许可同时适用 |
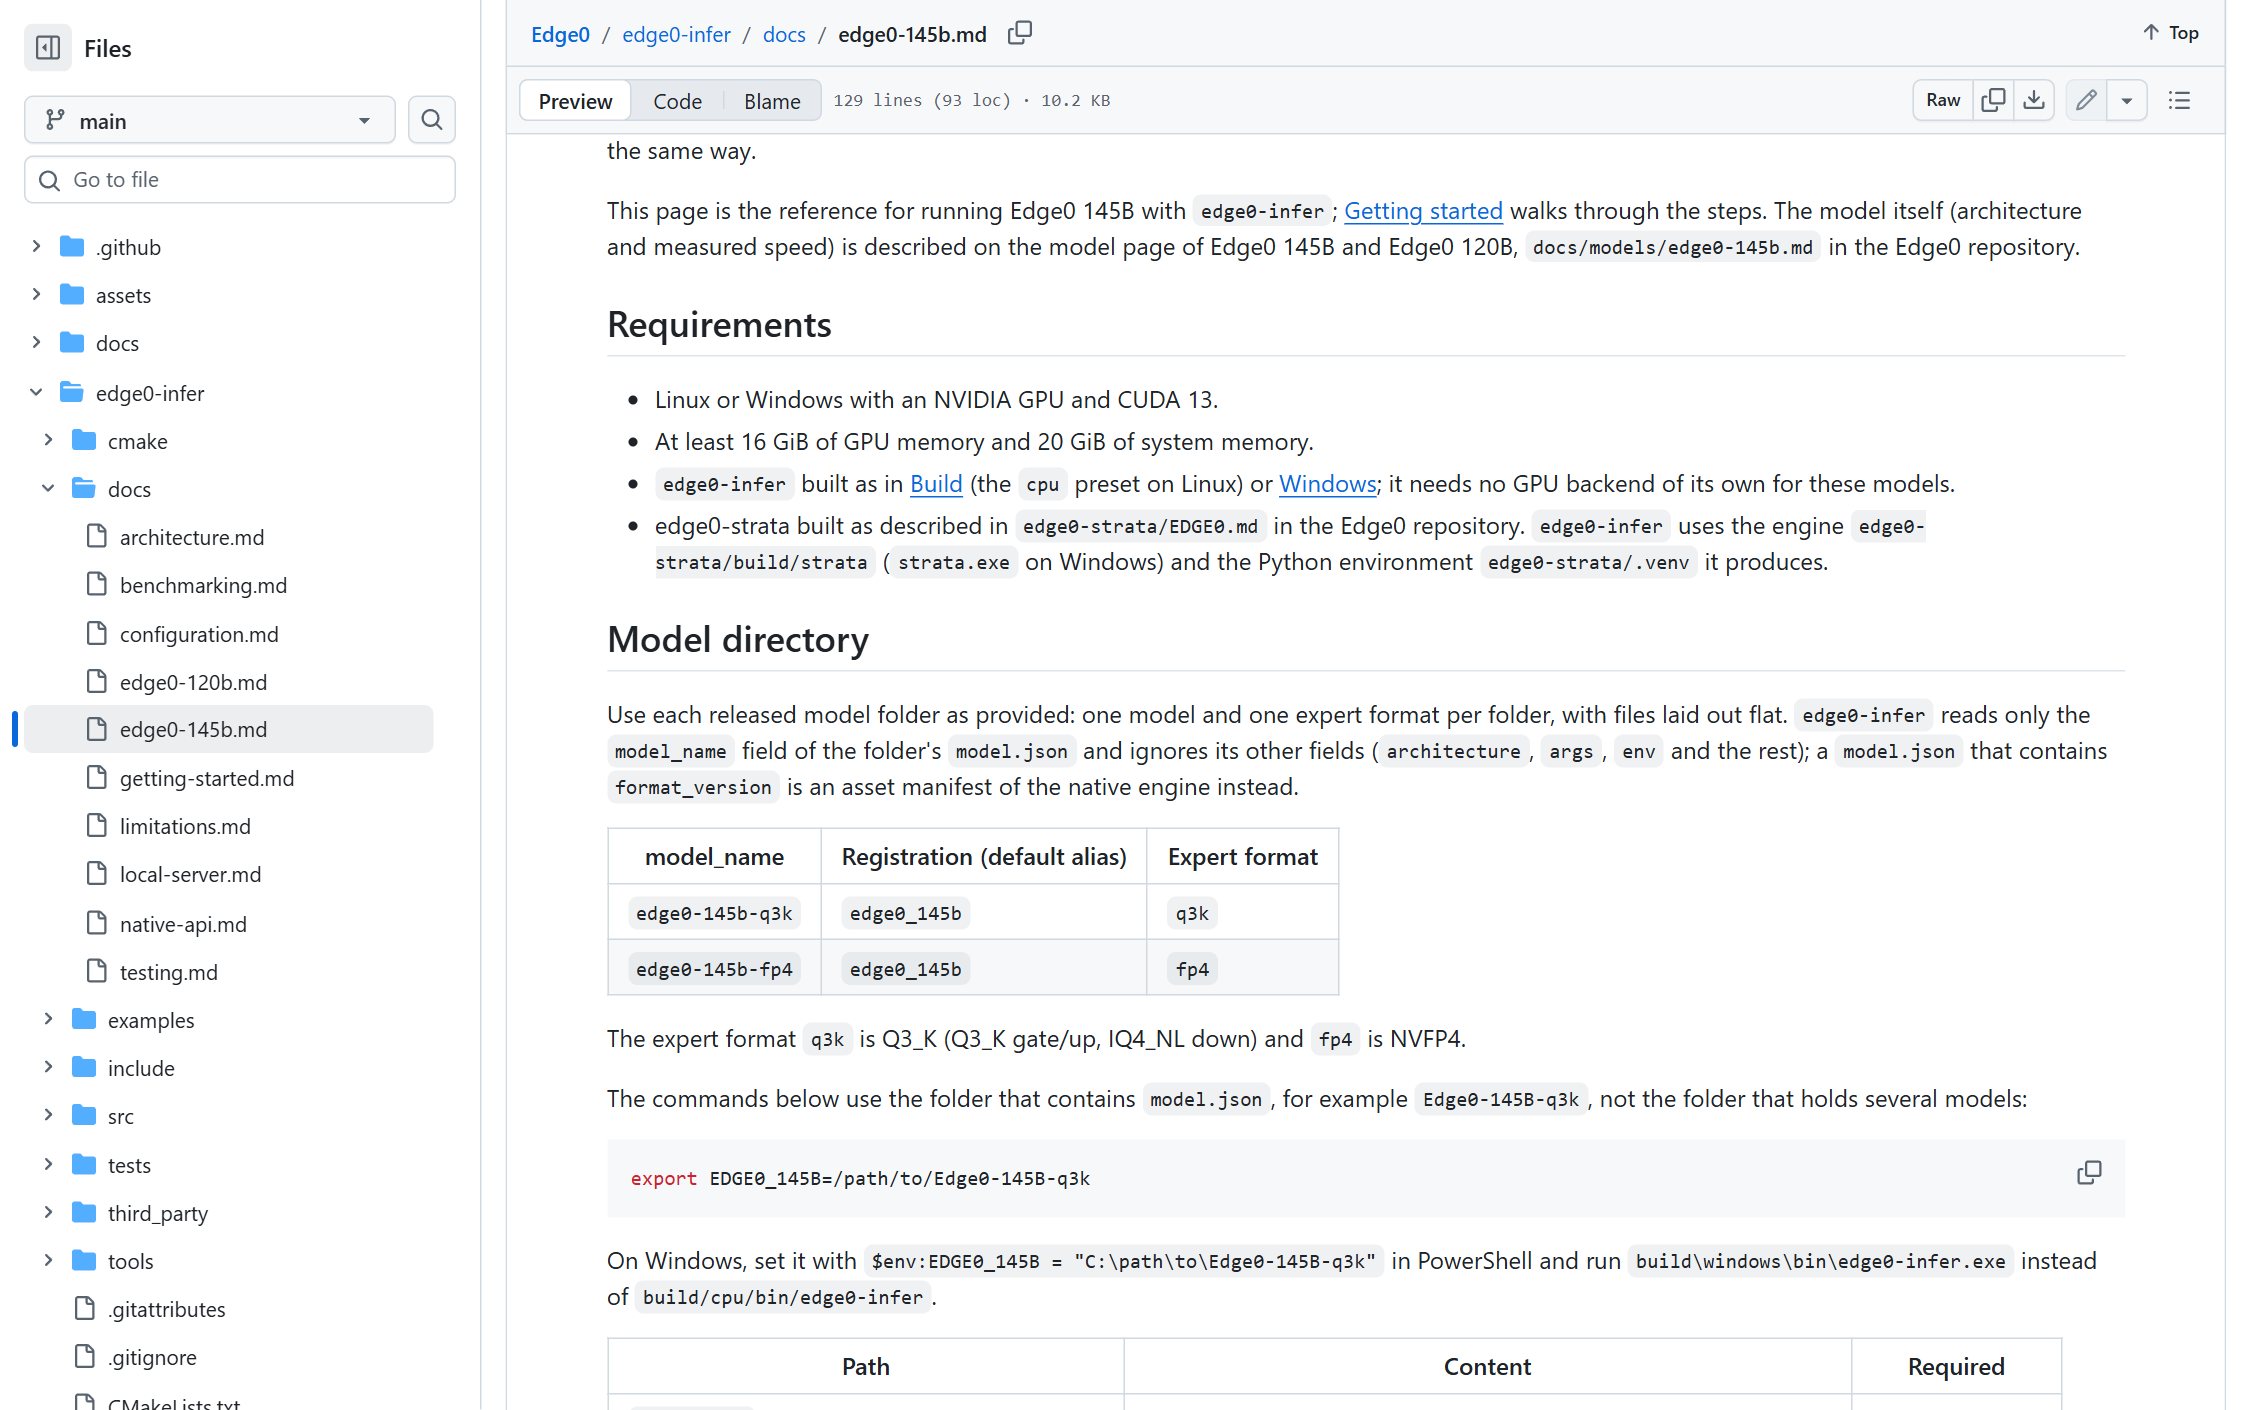
图:Edge0 官方文档对 Edge0-145B 的运行要求。图片来源:github.com/Edge0-AI/Edge0
「开源权重」是准确的,「开源」要打个折扣:这不是 OSI 定义的开源许可证,而且它明确禁止了这款模型最想服务的场景——拿它做一个对外卖的编码助手。
80 tok/s 需要什么机器
官方公布的速度表(单位:token/s):
| 机器 | 量化 | 16K 提示 prefill | 聊天解码 | Agent 解码 |
|---|---|---|---|---|
| RTX 5090 D 24GB | Q3_K | 3554.9 | 99.7 | 121.2 |
| RTX 5090 D 24GB | NVFP4 | 3165.7 | 79.6 | 98.3 |
| RTX 4090 24GB | Q3_K | 3179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| RTX 5090 D 限到 16GiB 显存 + 20GiB 内存 | Q3_K | 335 | 36.8 | 44.9 |
| Apple M2 Ultra | Q3_K | 800.3 | 60.9 | 57.0 |
把表读一遍就清楚了:
- 80 tok/s 是 24GB 桌面卡的成绩,不是笔记本的;
- 一旦按官方「最低要求」限到 16GiB 显存 + 20GiB 内存,同一张卡只剩 36.8 tok/s;
- M2 Ultra 有数(60.9 tok/s),但文档同时说这不代表 macOS 已经能跑。
「1,100+ tok/s prefill」同理:这是 16K 提示下最贵的那一行,4K 提示时是 2,169.9,限流测试里掉到 335。
基准:赢两项,输三项,全部是自测
官方给的对照表(全部来自 Edge0 内部评测,技术报告尚未发布):
| 基准 | Edge0-145B | Qwen3.8-Flash-Next(它爹) | 结果 |
|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 赢 |
| Terminal-Bench 2.1 | 86.5 | 83.3 | 赢 |
| AA-LCR(长上下文) | 79.3 | 79.1 | 基本平 |
| IFBench(指令跟随) | 80.6 | 81.3 | 输 |
| GPQA-Diamond | 90.4 | 91.7 | 输 |
| HLE | 35.4 | 35.9 | 输 |
另外表里那个「Claude Opus 4.6」是 Anthropic 的上一代(当前旗舰是 Opus 5.5)。换句话说,所谓「比肩前沿云模型」,落在可核的六项上是:编码类赢、知识推理类略输,而且赢的对象是自己那个 125B 基座的 4bit 部署版。
截至 11 月 14 日,Artificial Analysis 上没有 Edge0-145B 的页面(访问返回 404),也没有第三方复测。这不是造假,只是所有数字目前只有一方的口径。
工程上真正值得读的三件事
抛开宣传,这个模型有三处是真的巧:
- 专家共享大矩阵。每 64 个专家共享两个大矩阵,每个专家只保留一小撮私有参数来区分自己。专家数量不变、需要存储和搬运的权重却大幅减少。这也是为什么它能在 4bit 上下做到 145B。
- 从训练起步就是端侧架构。它不是先训一个云端大模型再压缩剪枝,而是把部署约束写进了设计——这件事在「压缩把能力压没了」的老路上是真正的分歧点。
- 三级存储流水。显存、内存、SSD 三层重叠读写,热专家留在显存,词表按需从 SSD 读,避免串行等待。代价是首字延迟依赖磁盘,收益是「显存不够也能跑」。
图:Edge0-AI/Edge0 仓库首页与发行版。图片来源:github.com/Edge0-AI/Edge0
现在能拿它干什么(以及不能干什么)
能:
- 有一张 24GB 的 NVIDIA 卡(4090/5090 一类)、装了 CUDA 13,就能按官方流程跑起来,聊天解码大约 70–100 tok/s;
- 它自带一个本地服务,在 8000 端口提供 OpenAI 和 Anthropic 兼容接口,所以可以接进支持自定义 provider 的编码客户端;
- 数据全程不出本机,没有 token 账单。
暂时不能:
- 在 Mac 上跑 145B。目前能跑 Mac 的是那个 35B 小模型;
- 用 Ollama / LM Studio 一条命令加载。它的文件结构是自家的,只能走 edge0-infer;
- 拿它做对外卖的编码助手。许可把「独立的商用编码或办公助手」单列为需要额外授权;
- 把它当成「笔记本 29GB」来规划硬件。要下载 105GB、要留 40GB 左右的专家库内存、词汇表还要占 SSD。
三个要留个心眼的点
- 「能跑」不等于「跑得好」。按官方最低要求(16GiB 显存)跑出来是 36.8 tok/s,且首字延迟被 SSD 拖;体验分水岭在 24GB 卡。
- 所有性能与基准都是厂商自测。厂方自己写了「Edge0、Qwen、DeepSeek、Claude 的结果均来自 Edge0 内部评测」,等第三方复测再决定要不要迁移工作流。
- 宣传页与仓库文档不一致时,信文档。macOS 支持、29GB 内存、机型,这三件事在发布文里是一句话,在文档里是另一句话;文档那句是工程师写的。
数据来源
- Edge0 官方发布文:Introducing Edge0-145B: Frontier AI Capabilities on Your Own Computer(edge0.ai,2026-11-12)
- 模型与文档:github.com/Edge0-AI/Edge0(
docs/models/edge0-145b.md、edge0-infer/docs/edge0-145b.md) - 权重体积:huggingface.co/Edge0 四个仓库的文件树(2026-11-14 统计)
- Qwen 基座参数:huggingface.co/Qwen/Qwen3.8-Flash-Next 模型卡
- 独立核对:Enjoy(enjoy.dev,2026-11-13)、Traictory(2026-11-14)两篇对文件体积、许可与测速表的交叉核对