一句话
做分类、做路由、做「从这几个里挑一个」,本来就不需要模型写文章。 Google 把这个动作单独做成了一个接口:不生成、只打分,输出 token 一分钱不收,延迟压到百毫秒级。
图:Gemini Decisions API 官方主视觉。图片来源:blog.google
它做的事:把「生成」换成「打分」
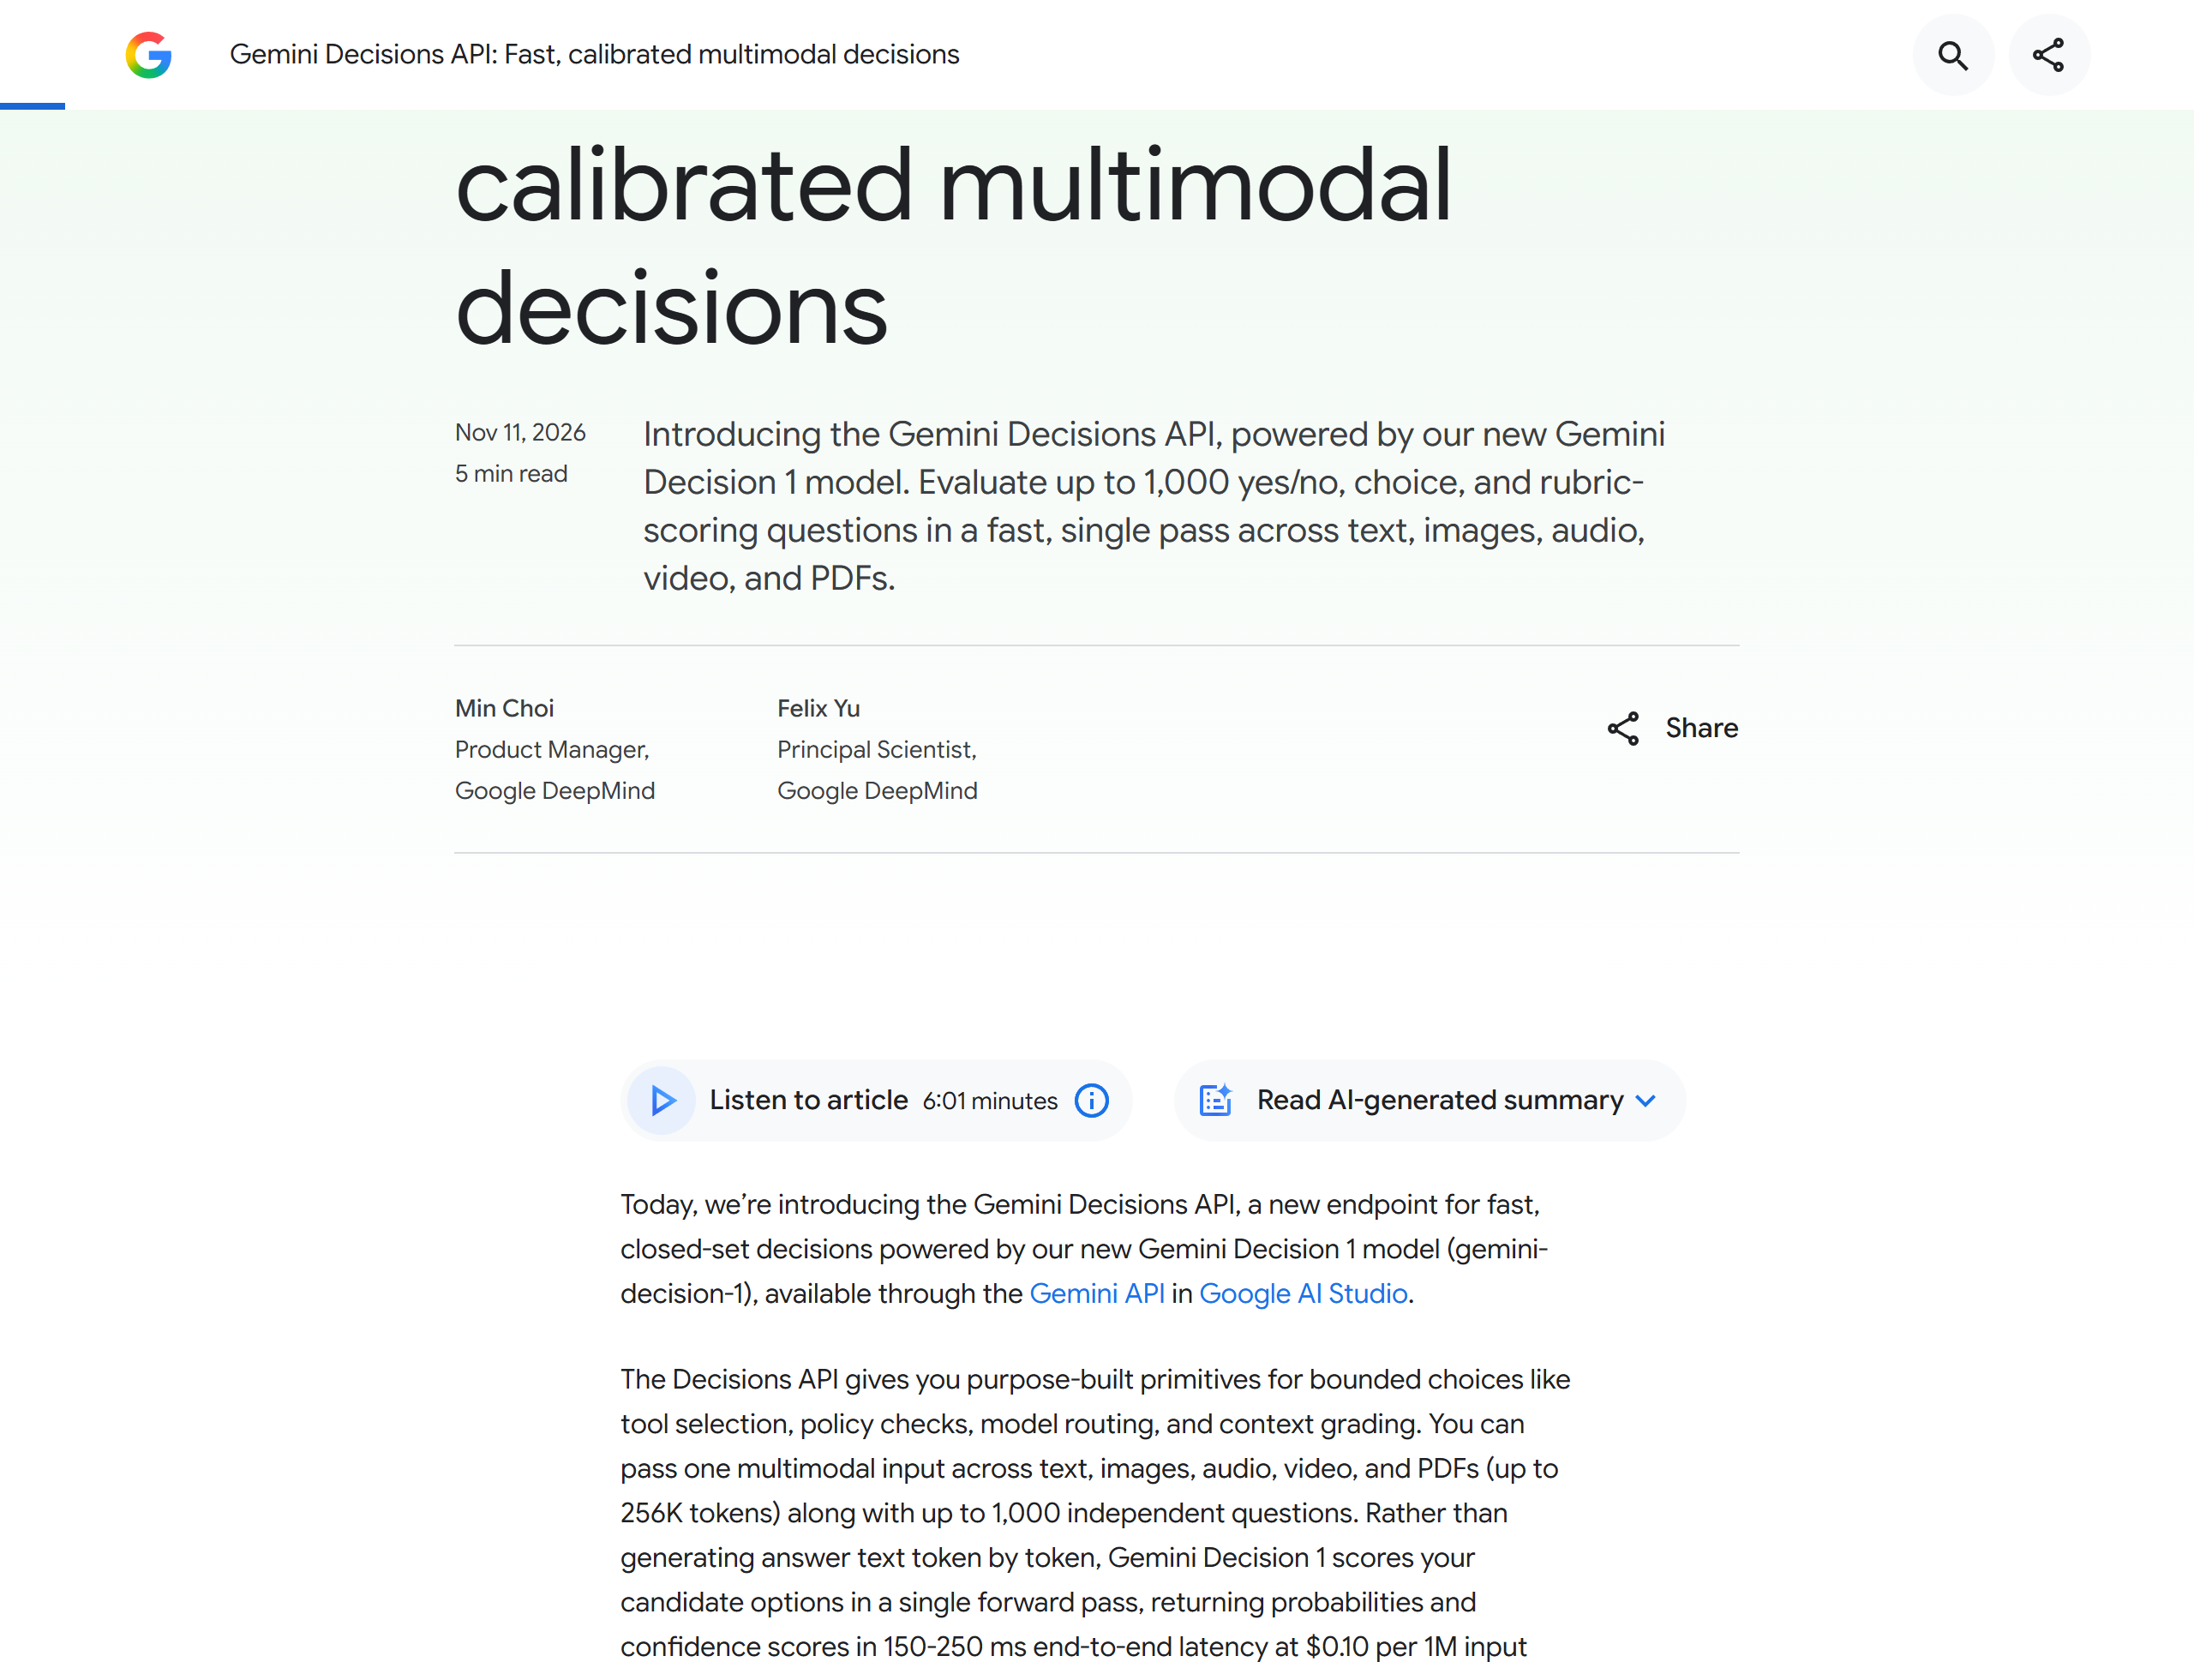
图:Google 官方发布文《Gemini Decisions API: Fast, calibrated multimodal decisions》,作者为 DeepMind 产品经理 Min Choi 与首席科学家 Felix Yu。图片来源:blog.google
传统用法是这样的:你把「从 A/B/C 里选一个」塞给聊天模型,它洋洋洒洒写一段理由,你在代码里正则抠出那个字母,抠不到就重试。Gemini Decision 1 换了个思路——直接把候选答案当成分数算出来:
- 不逐 token 解码,而是**一次前向传播(single forward pass)**给所有候选打分;
- 返回概率 + 置信度(0–1),你的代码可以按置信度决定「够不够格自动放行」;
- 置信度低的自动落到兜底逻辑或人工复核。
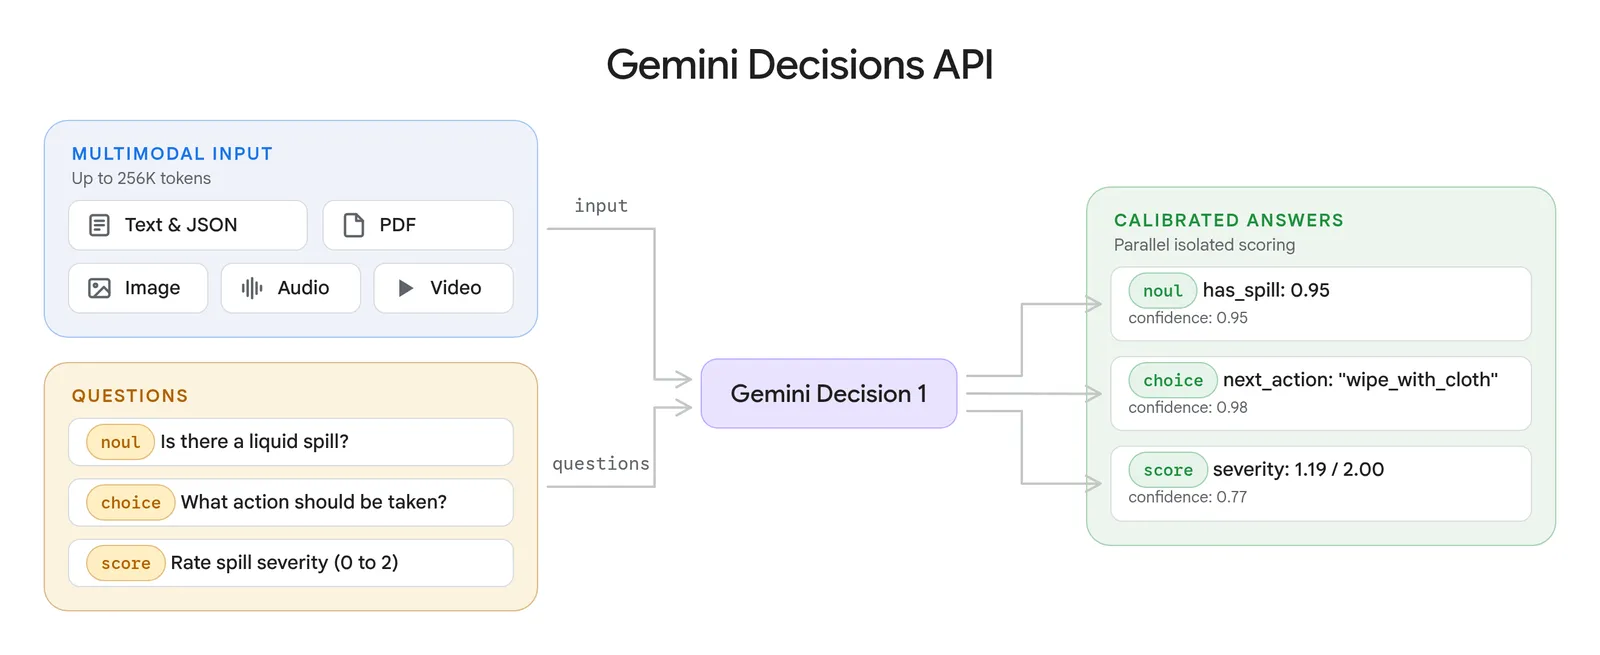
图:Gemini Decisions API 官方架构图,左侧是共享的多模态输入与问题列表,右侧三类判定各自返回数值与置信度(示例中 has_spill 0.95、next_action 0.98、severity 1.19/2.00)。图片来源:blog.google
官方参数一览
| 项目 | 数值 |
|---|---|
| 模型 | Gemini Decision 1(gemini-decision-1),Gemini API / Google AI Studio |
| 单次输入 | 一段共享的多模态输入,最多 256K token |
| 模态 | 文本 / JSON / 图片 / 音频 / 视频 / PDF,可组合 |
| 单次问题数 | 最多 1000 个独立问题(可混合三种类型) |
| 端到端延迟 | 150–250 毫秒(模型计算中位数 50–100 毫秒) |
| 单价 | $0.10 / 百万输入 token,输出 token 不计费 |
| 校准 | 每个答案都带 0–1 置信度 |
| 图像/视频 | 可调分辨率,用来控制视觉细节精度与 token 成本 |
延迟的另一个细节值得记:在 16K 以内上下文、多模态输入下,从 1 个问题加到 100 个问题,耗时几乎不变。因为它是一次前向同时打分,不是循环调用 100 次。这一点直接决定了能不能把它放进在线链路——「每多问一个问题就多一次请求」的老办法,延迟会线性堆起来。
三种判定类型(官方示例就读得懂)
| 类型 | 干什么 | 返回什么 |
|---|---|---|
noul(是/否) | 判断某个条件是否成立,可给「成立/不成立」的文字说明作为判据 | 成立的概率 + 置信度(示例:has_spill: 0.95) |
choice(多选) | 从 2 到 255 个候选里挑一个 | 赢家 + 每个候选的归一化概率(示例:next_action: "wipe_with_cloth",置信度 0.98) |
score(有序评分) | 按 0 起步的有序 rubric 打分 | 连续加权分 + 各档位概率(示例:severity: 1.19 / 2.00,置信度 0.77) |
这三类基本覆盖了「闭集决策」的全部形态:是不是、选哪个、打几分。
成本实算:一天百万次判断要多少钱
先按官方口径记一条:在共享基准套件上,Decisions API 比「Gemini 3.5 Flash-Lite + 生成式接口」便宜近 5 倍(这是 Google 的说法,因为它把输出 token 全免了)。
下面这个账是自己算的量级估算,假设写在表下:
| 方案 | 每天 100 万次判定,每次 2K 输入 token | 月成本 |
|---|---|---|
| Decisions API($0.10/M 输入,输出免费) | 20 亿 token/天 → $200/天 | 约 $6,000 |
| 生成式(假设 $0.30/M 输入 + $2.50/M 输出,每次输出 40 token JSON) | $600 + $100 = $700/天 | 约 $21,000 |
假设:每次判定的输入是「一段文本 + 一张截图」,合计约 2,000 token;生成式方案每次要吐 40 token 的 JSON(含一个理由字段)。你自己的缓存命中、重试、图片分辨率都会改变结果——但结构不会变:当输出只是「一个标签」时,为它按 token 付费是最亏的一种计费方式。
四个典型用法
官方点名的四类 bounded choice,恰好是国内团队最常手写的那几种:
- 工具选择:Agent 有 30 个工具,先判定该调哪个——
choice从 30 个里挑,返回每个的概率,低置信度就走「反问用户」分支。 - 策略检查:请求是否命中风控/合规规则——多个
noul并行问,一次拿回全部是/否。 - 模型路由:这条请求该给便宜模型还是旗舰模型——
choice在两三个模型档位间选,跟你网关里的价格表配合,能省下的钱是模型差价本身。 - 上下文打分(context grading):检索回来的 20 段材料哪几段真相关——
score或noul批一次,替代「再调一次大模型让它排序」。
这四种活原本都在花旗舰模型的钱,而它们要的从来不是文采。
什么时候不该用它
- 要开放式答案:写文案、写代码、解释原因——它只会在你给的候选里选,闭集之外无解。
- 需要多轮工具调用:它是「一次判定」,不是 Agent 循环;复杂的多步任务还是得靠执行型模型(比如同一天发布的 Gemini 4 Hydrogen 那种)。
- 输入超 256K:整本手册塞不进,先切块再判。
- 依赖长链推理:把「要不要重试」这类需要连续推断的判断硬塞进闭集,准确率会掉;它擅长的是划定选项后的快速裁决。
现在能怎么试
模型 id 为 gemini-decision-1,入口在 Gemini API 与 Google AI Studio。做法上最小的验证路径是:先把你线上那个「让它输出 JSON 标签」的调用抓出来,改成候选打分,对比三件事——准确率、P95 延迟、当月账单。前两项持平就是赚,因为第三项里输出 token 已经归零。
数据来源
- Google 官方发布文:Gemini Decisions API: Fast, calibrated multimodal decisions(blog.google,2026-11-11,作者 Min Choi / Felix Yu)
- 参数(256K 输入、1,000 问题、150–250 毫秒、$0.10/百万输入、输出不计费、2–255 个候选)均取自该发布文原文
- 官方架构图与示意数值取自同篇发布文的配图
- 成本表为本文按上述单价自行推算的量级估算,非官方口径;「便宜近 5 倍」为 Google 官方对比口径