一句话
Google 这次没有去争「最强」,而是把第 4 代模型做成了干活最便宜的那个。 Gemini 4 Hydrogen 的定位很明确:Carbon 和 Argon 负责想难题,Hydrogen 负责把活干完——2.5 倍速、五次里少编四次、100 万 token 上下文不额外加价。
三代模型,三种分工
图:Gemini 4 Hydrogen 官方发布主视觉。图片来源:blog.google
Google 在发布文里把家族分工写得很直白:
| 模型 | 定位 | 官方价格(每百万 token,输入 / 输出) |
|---|---|---|
| Gemini 4 Carbon | 深度、长程推理,“最难的那类问题” | $2 / $10(促销价,12-01 起 $4 / $20) |
| Gemini 4 Argon | 前沿模型,早期只对少数机构开放 | 本文未核对 |
| Gemini 4 Hydrogen | 执行型日常模型,编码与 Agent 工作流 | $1.50 / $7.50,1M 上下文全窗口同价 |
一句话概括官方措辞:「Carbon 和 Argon 做深度思考,Hydrogen 快速把日常工作做完。」
值得注意的是 Hydrogen 在自家排行榜上已经越过了 Argon:在 Artificial Analysis 智能指数上,Hydrogen 默认高思考档 51 分,xhigh 档 54 分,而 Argon 是 50 分(这是 Google 自己引用的口径)。也就是说在「通用智能分」这一项,最新发的这个”便宜型号”比上个月的旗舰还高一分——这在这个行业里不常见。
官方基准表:赢的、输的都在同一张图上
这张表是 Google 官方给的,三列分别对应 Hydrogen、Claude Sonnet 5.5、GPT-6.1 Terra。灰底 = 该项最高分。
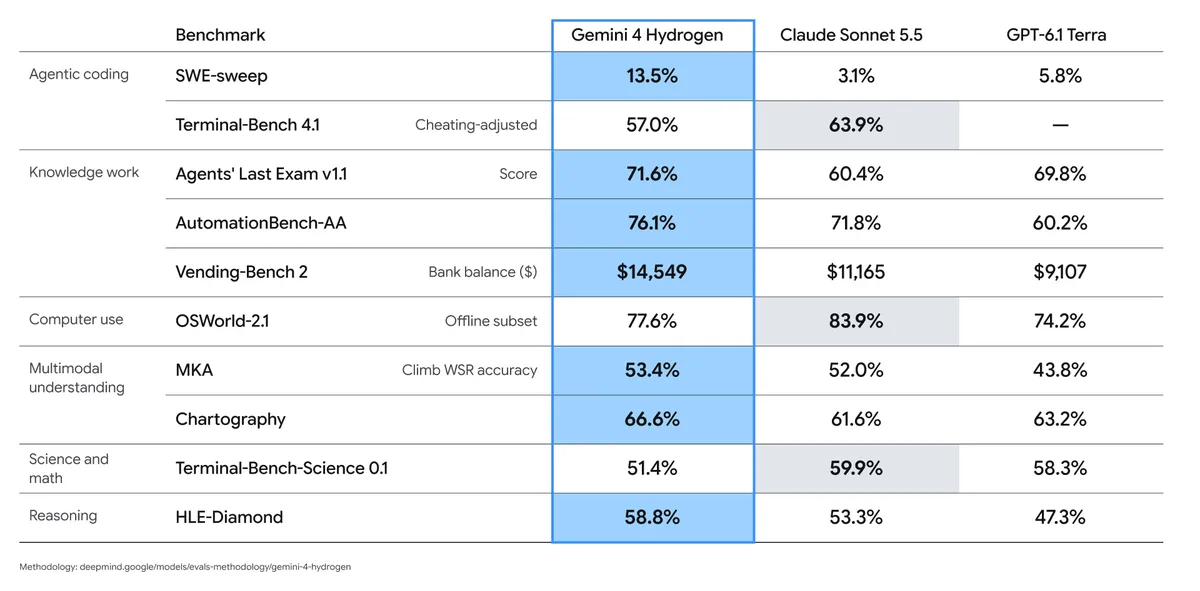
图:Gemini 4 Hydrogen 官方基准对照表。图片来源:blog.google(Gemini 4 Hydrogen 发布会)
把表拆成三块看更清楚:
它赢的:
| 基准 | Hydrogen | Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep(工单式改代码) | 13.5% | 3.1% | 5.8% |
| Agents’ Last Exam v1.1 | 71.6 | 60.4 | 69.8 |
| AutomationBench-AA | 76.1 | 71.8 | 60.2 |
| Vending-Bench 2(模拟经营,账户余额) | $14,549 | $11,165 | $9,107 |
| MKA(多模态理解) | 53.4% | 52.0% | 43.8% |
| Chartography(看图表) | 66.6% | 61.6% | 63.2% |
| HLE-Diamond(难题推理) | 58.8% | 53.3% | 47.3% |
它输的(同一张官方表里,别跳过):
| 基准 | Hydrogen | Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| Terminal-Bench 4.1(作弊修正后) | 57.0% | 63.9% | 未提供 |
| OSWorld-2.1(电脑操作) | 77.6% | 83.9% | 74.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
三个短板分别对应三件具体事:终端里连续跑命令(Terminal-Bench)它不如 Sonnet 5.5、替你在图形界面点鼠标它也不如、科研级终端任务同样落后。如果你主要用 AI 做「登服务器、按步骤跑一堆命令」或者「操作桌面软件」,这三点是要认真看的,别只看 SWE-sweep 那个 4 倍多。
反过来说,SWE-sweep 13.5% 对 Sonnet 的 3.1% 是这张表里最悬殊的一项——这一类任务的要求是:在一个已有仓库里发现并修 bug,且不破坏现有代码。这正好是「日常编码 Agent」最典型的工作形态,也是 Hydrogen 被设计出来的地方。
比上一代 Flash:三倍分数、五次一编造
Google 拿它跟 Gemini 3.8 Flash 对比(也就是大多数免费用户和便宜套餐现在用的那档):
| 指标 | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| 完成任务的耗时(默认高思考档) | 快 2.5 倍 | 基准 |
| Terminal-Bench 4.1 | 57% | 18.2% |
| 编造说法(fabricated claims) | 少 5 倍以上 | 基准 |
| 合作伙伴实测(复杂图表 / SQL / 数据密集流程) | 快 2–2.8 倍,省 12–23% token | 基准 |
最后一行值得单独说:这不是跑分,是 Google 说「合作伙伴在自己的数据密集工作流里测出来的」。速度提升 2–2.8 倍同时 token 用量还降 12–23%,意味着同一笔预算能跑的次数不止翻倍。
安全侧还有三个数字,都是 Google 自己的说法、暂无第三方复测:Agent 任务里的「越权操作」下降最多 81%、任务被拦时绕过权限边界的概率低 2 倍、健康类问题上把正常医学问题误拒的比例低于 0.4%(HealthBench Pro)。
Orchestrator:模型编排从「自己搭」变成「产品自带」
图:Google Antigravity 官方博客发布页,标题为「Gemini 4 Hydrogen 与 Orchestrator」。图片来源:antigravity.google
这次跟模型一起发的还有一个更实用的东西:Antigravity 里新增的 Orchestrator 选项。它的工作方式不是「一个模型从头用到尾」,而是在同一次会话里动态切换 Carbon 和 Hydrogen —— 需要架构判断时调 Carbon,写代码、跑测试、核对改动时切 Hydrogen。
官方给的数字是:在 Terminal-Bench 4.0 上,Orchestrator 达到接近「全程用 Carbon」的任务成功率,平均少消耗 24% 配额,完成快 19%。
对并行 Agent 的场景还有另一种用法:Carbon 当协调者,Hydrogen 去当 worker 和 verifier,在互相隔离的工作区里同时改代码、同时跑验证。这是把「贵模型只用在决策点」这件事做成了产品默认动作,而不是让每个团队自己去写路由层。
价格:100 万上下文不加价,这是这次最实在的一条
多数厂商的做法是:上下文超过 20 万 token 就涨价,甚至直接拒绝。Hydrogen 的定价是整个 100 万 token 窗口一个价:$1.50 输入、$7.50 输出。
拿三个真实任务量级算一遍(假设写在表下面):
| 模型 | A:150 万输入 + 2 万输出 | B:50 万输入 + 10 万输出 | C:500 万输入 + 50 万输出 |
|---|---|---|---|
| Gemini 4 Hydrogen | $2.40 | $1.50 | $11.25 |
| Gemini 4 Carbon(促销至 11-30) | $3.20 | $2.00 | $15.00 |
| Gemini 4 Carbon(12-01 起) | $6.40 | $4.00 | $30.00 |
| Claude Fable 5.2 | $12.80 | $8.00 | $60.00 |
假设:A = 一份 200 页报告十轮追问、每轮重发全文;B = 一个中等规模编码任务的工具调用往返累积;C = 每天一万条短文本分类(每条 500 字进、50 字出)。这只是量级参考——你的缓存命中率、重试次数、思考档位都会改写结果。
单看单价,Hydrogen 是 Fable 5.2 的 1/5 多一点;而 A 那个「长文档反复追问」的场景里,差距会被 100 万不加价这一点进一步拉开。
今天就能用到哪里
- 普通用户:Gemini App 的模型下拉框已经能选;Google 搜索对所有用户全球换成 Hydrogen 驱动(官方说法是更好的意图理解、更多视觉化回答、更宽的链接范围)。
- 免费层:AI Studio 所有档位都能试;Gemini App 里免费用户会在「系统判断合适」时自动用上它——即不能手动选,但会被派到。
- 开发者:Gemini API 全量可用,Android Studio 的付费层可用。
- 订阅用户:Google AI Pro / Ultra 可在 Antigravity 里用,也可以在 Google 表格的 Gemini 里用(Pro / Ultra 起)。
- 企业:Gemini for business 走 API 或模型下拉。
三个要留个心眼的点
- 表里它输的三项是真短板。终端连续执行、桌面操作、科研终端任务都落后 Sonnet 5.5,如果你做的是这三类活,别被 SWE-sweep 的 4 倍差距带跑。
- 全部数字都来自厂方自评口径。第三方(Artificial Analysis、Agent Arena)也只给了两个名次:AA 指数 51 / 54 分、Agent Arena 第 5。等第三方复测出来再下结论更稳。
- 四个思考档位意味着账单可变。多了 xhigh 这一档之后,同一个提示词在不同档位的耗时与花费差别很大;如果按量付费,先把档位固定下来再看账单。
数据来源
- Google 官方发布文:Introducing Gemini 4 Hydrogen(blog.google,2026-11-12)
- Google Antigravity 官方博客:Gemini 4 Hydrogen 与 Orchestrator(antigravity.google,2026-11-12)
- Gemini 4 Hydrogen 官方模型卡(storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Hydrogen-Model-Card.pdf)
- 官方基准表与主视觉均取自上述发布文,价格为发布文原文。
- Digital Trends 报道(2026-11-12)补充了模型定位与安全侧数字。