一句话
Google 把「前沿智能」压到了 $3/$15、还给了 100 万上下文全窗口平价;但对真正会拿它干活的团队来说,比分数更值得注意的是:它把「想多深」变成了一个可以直接调价格的四档旋钮,而四档之间的成本差是 7 倍。
 图源:blog.google
三兄弟的排位被官方自己画清楚了
Gemini 4 现在是三条产品线,官方在同一张图里给了分工和价目:
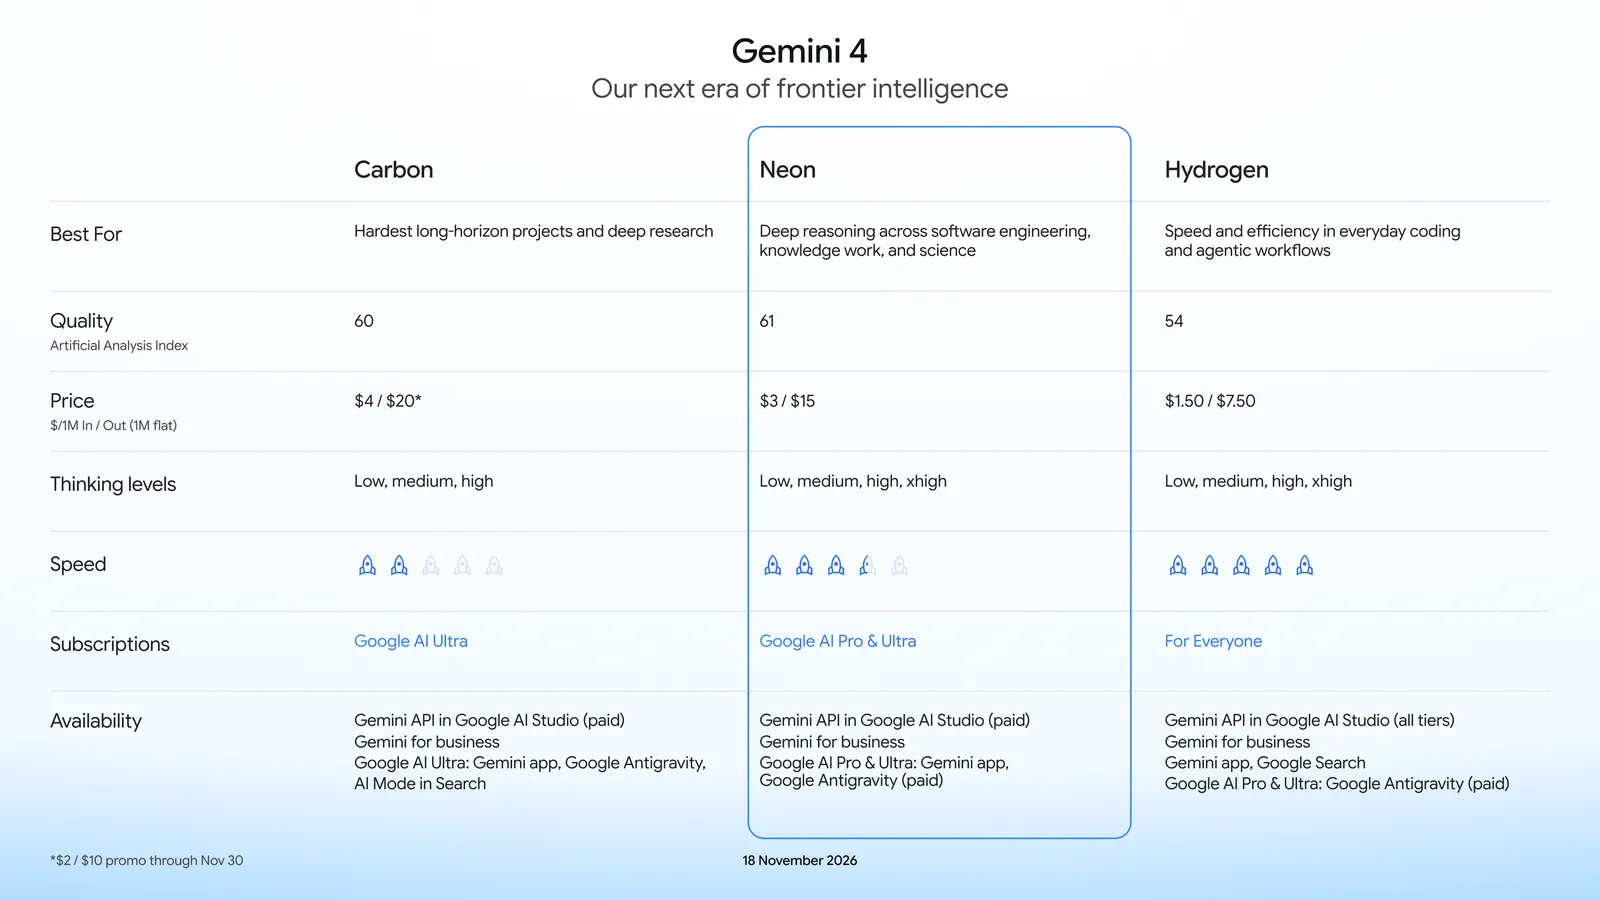 图源:blog.google(Gemini 4 系列对比,2026-11-18)
| Carbon | Neon | Hydrogen | |
|---|---|---|---|
| 定位 | 最难的长周期项目与深度研究 | 跨软件工程、知识工作、科学的深度推理 | 日常编码与 agent 流程的速度 |
| AA 智能指数 | 60 | 61 | 54 |
| 价格(输入/输出,每百万 token) | $4 / $20(11 月 30 日前促销 $2 / $10) | $3 / $15 | $1.50 / $7.50 |
| 思考档位 | low / medium / high | low / medium / high(默认) / xhigh | low / medium / high / xhigh |
| 上下文 | 100 万 | 100 万 | 100 万 |
三行字里最关键的其实是价格表的最后一行小字:Carbon 的 $2/$10 是促销价,12 月 1 日起回到 $4/$20、缓存输入从 $0.10 回到 $0.20。也就是说,一周后 Neon 会变成「比自家旗舰便宜 25% 且分数更高」的那一档,Carbon 的性价比位置会被自己人挤掉。
Neon 的缓存价是 $0.15/百万(标准输入价的 5%,官方称省 95%),Batch 与 Flex 档 $1.50/$7.50,Priority 档 $5.40/$27。100 万上下文是全窗口同价,不像有些模型超长上下文要加价。
可用渠道:Google AI Studio 的 Gemini API(付费)、Gemini for business、Antigravity 里的付费 AI Pro/Ultra 订阅者、Gemini App 的 Pro/Ultra 订阅者。免费档没有 Neon。
四档思考 = 一个 7 倍的成本旋钮
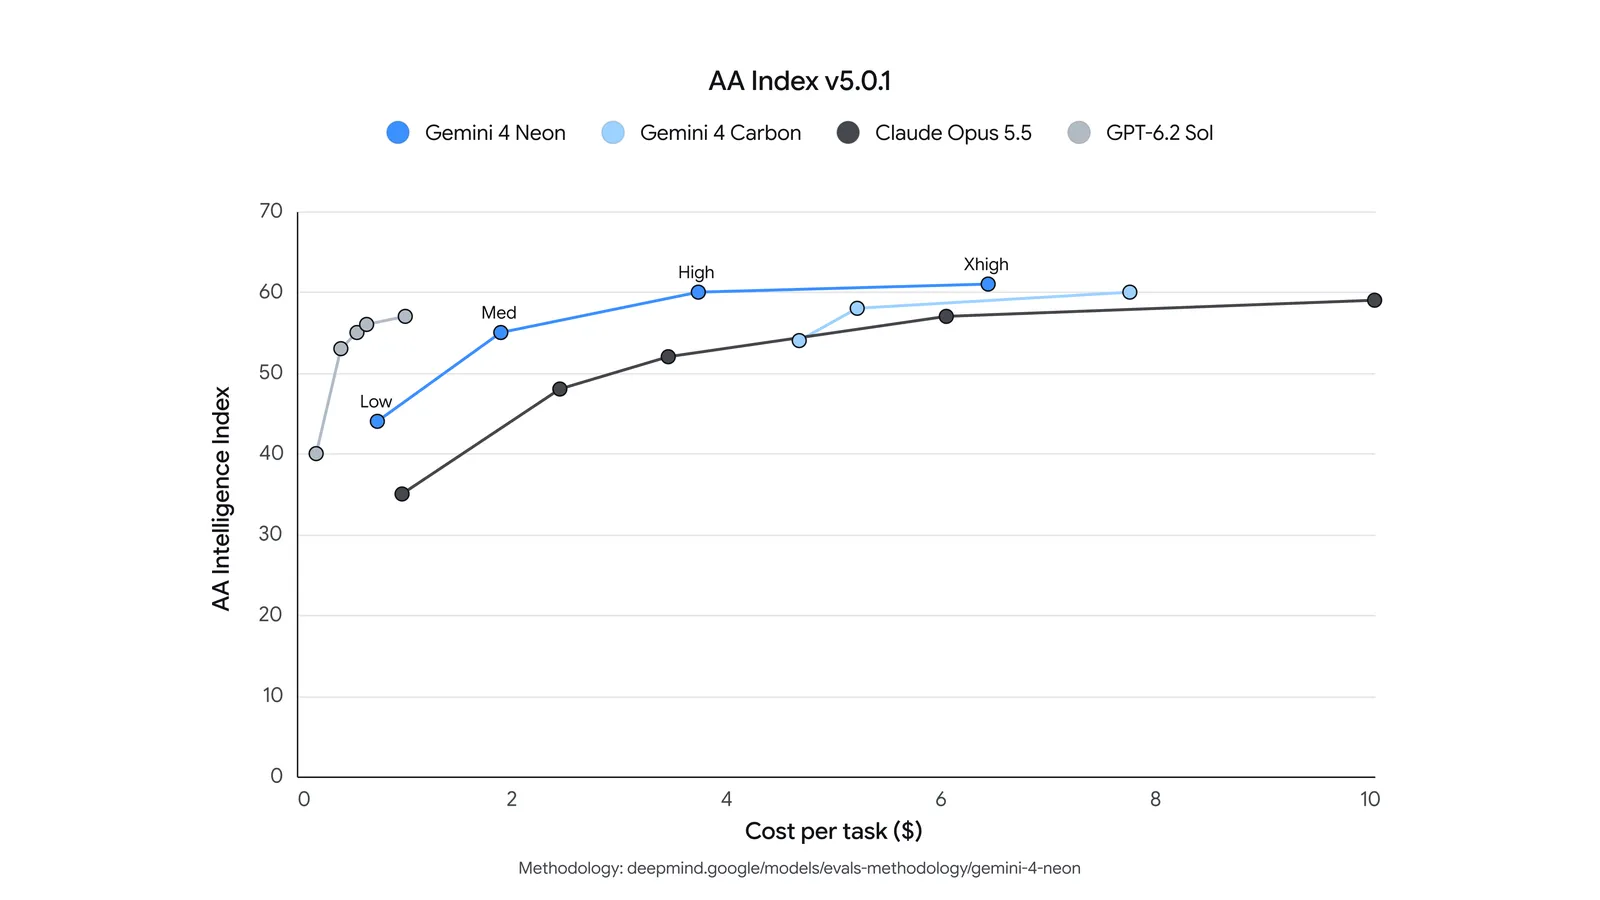
官方最实在的一段话是:「Neon 的四档平稳递增,让团队按每个工作负载去调智能与 token 花销。」第三方把它量化了:
| 思考档位 | AA 智能指数 | 每任务耗时 |
|---|---|---|
| low | 44 | 3.7 分钟 |
| medium | 55 | 8.3 分钟 |
| high(默认) | 60 | 14.8 分钟 |
| xhigh | 61 | 21.5 分钟 |
这张表读出来的结论很不客气:从 high 到 xhigh,分数只多 1 分,时间多 45%,成本从每任务 $3.74 涨到 $6.30 左右。用得上 xhigh 的场景应该极少——官方自己也写了它只针对「high 不够用的高难多步工程/分析/科学问题」。
反过来,medium 是个被低估的档:55 分、8.3 分钟、成本大约是 high 的六成。对大多数对话式与中等编码任务,medium 才是正确默认值,而不是官方给的 high。
 图源:blog.google(方法论 deepmind.google/models/evals-methodology/gemini-4-neon)
这张图还有一个容易看漏的信息:Claude Opus 5.5(深色)的成本爬到 $10/任务时才到 59 分,而 Neon 在 high 档 $3.74 就已经 60 分。 Google 官方那句「默认 high 档比 Carbon 每任务便宜 32%」在图上是对的,但第三方口径更狠:同档位下 Neon $3.74 / Carbon $7.76,差 52%。
硬碰硬:官方表里它输了三项
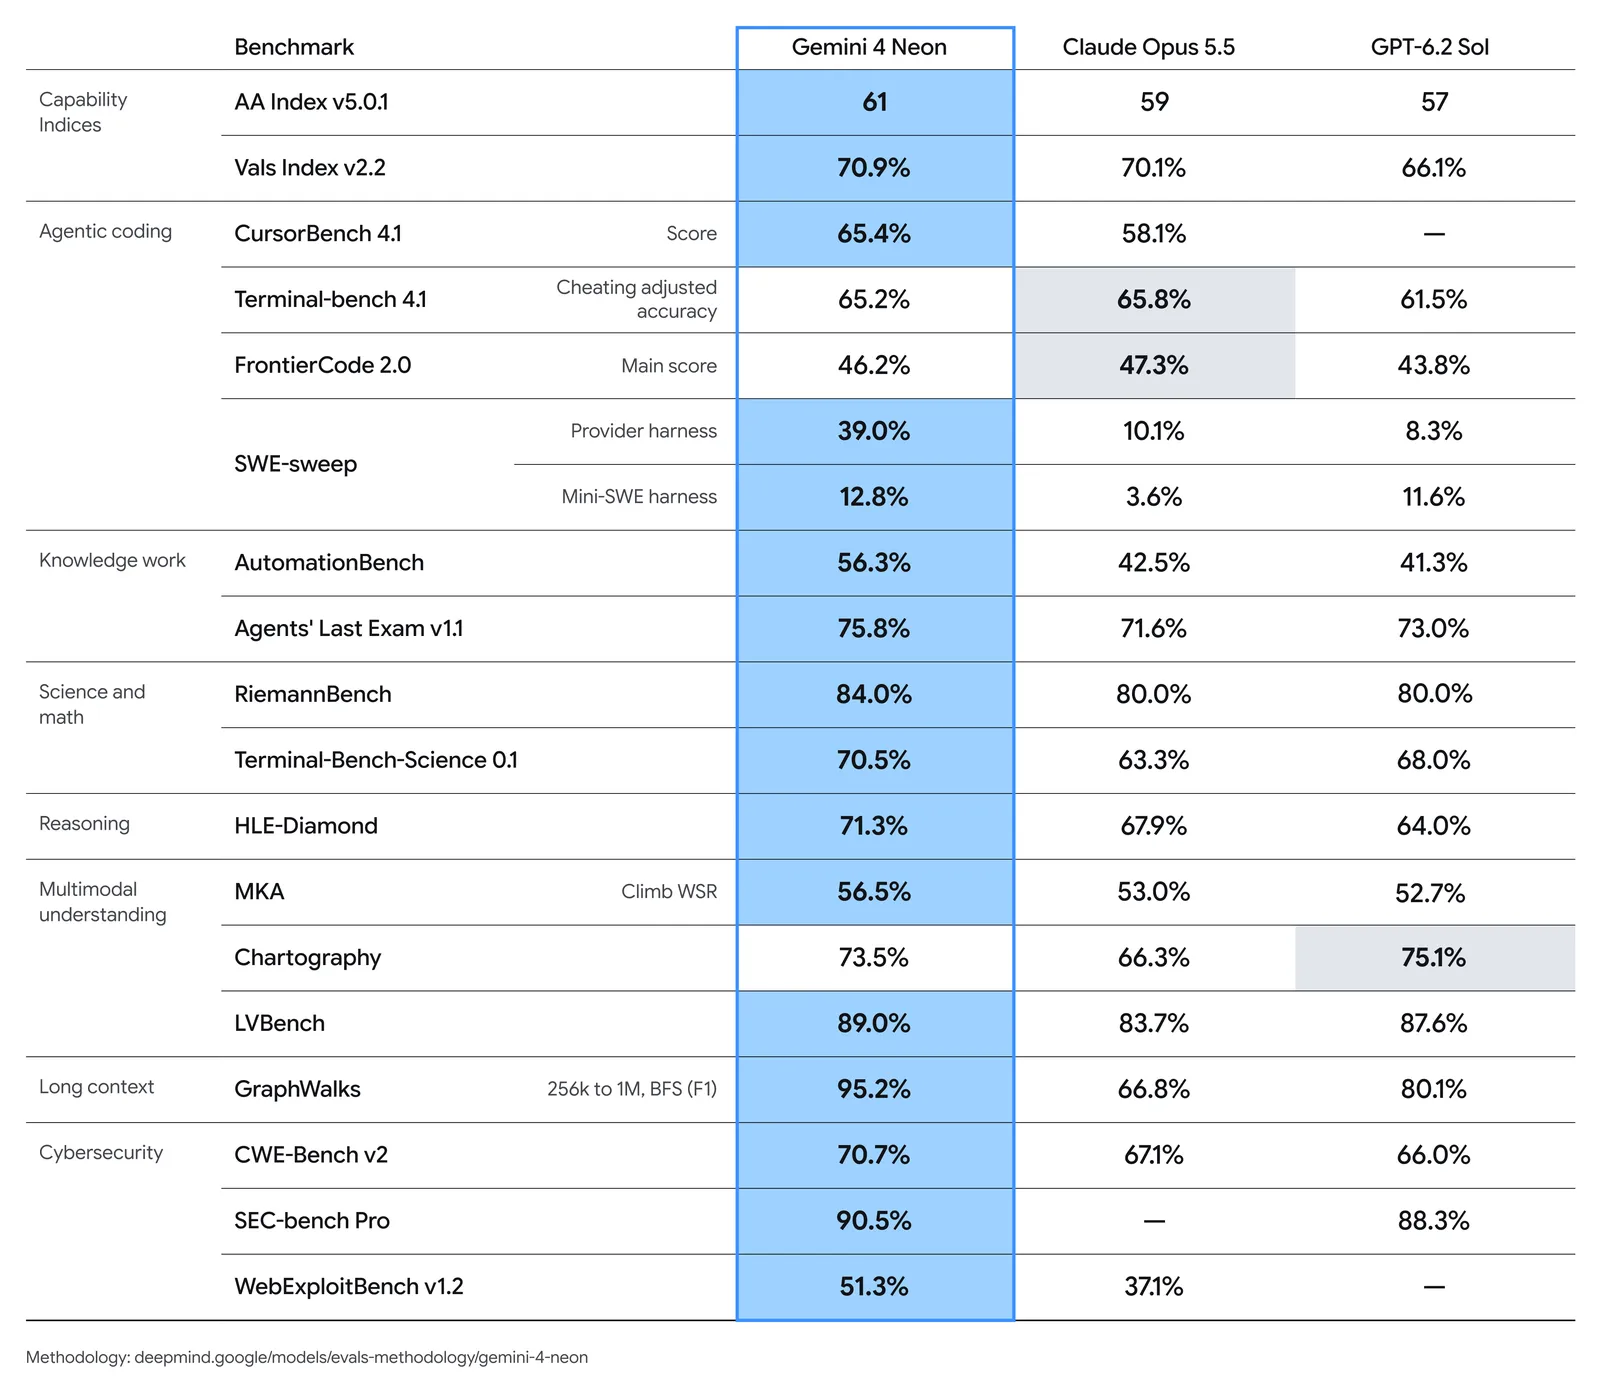
这是这篇最该看的一张表——Google 自己放的对照,行是基准,列是 Neon / Claude Opus 5.5 / GPT-6.2 Sol:
 图源:blog.google
把领先和落后分开放,画面会更清楚:
赢的地方(差距都不小)
| 基准 | Neon | Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AA 智能指数 v5.0.1 | 61 | 59 | 57 |
| Vals 指数 v2.2 | 70.9% | 70.1% | 66.1% |
| CursorBench 4.1 | 65.4% | 58.1% | — |
| SWE-sweep(provider harness) | 39.0% | 10.1% | 8.3% |
| AutomationBench | 56.3% | 42.5% | 41.3% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science | 70.5% | 63.3% | 68.0% |
| GraphWalks(256K→1M,BFS F1) | 95.2% | 66.8% | 80.1% |
| CWE-Bench v2 | 70.7% | 67.1% | 66.0% |
输的地方(都是编程/图表类)
| 基准 | Neon | 对手 | 说明 |
|---|---|---|---|
| Terminal-Bench 4.1 | 65.2% | Opus 5.5 65.8% | 差 0.6 个点,官方口径是「作弊修正后准确率」 |
| FrontierCode 2.0 | 46.2% | Opus 5.5 47.3% | Neon 取默认 high 档;xhigh 未列 |
| Chartography | 73.5% | GPT-6.2 Sol 75.1% | 读密集专业图表 |
这三项恰好落在「真拿它写代码」的人最在意的地方。 结论不是「Neon 编程不行」——SWE-sweep 上它把两家甩开 30 个点、CursorBench 领先 7 个点——而是它的优势在跨工具的长流程与检索能力,而单点最难的代码修改上,Opus 5.5 仍然略稳一点。
一个值得记的口径:官方在 Coding Agent Index 上报的是 58.6 排名第一,TNW 引用 Artificial Analysis 的同一榜单却写作 59 分、每任务 $6.86,而 Opus 5.5 与 Fable 5.2 同为 58 分、每任务分别 $12.61 / $15.47。同一个榜,分数被四舍五入成两个版本,成本差却是实打实的 2–2.3 倍。
长上下文:这次是硬指标
GraphWalks 从 25.6 万到 100 万 token 的 BFS 任务,Neon 95.2%、GPT-6.2 Sol 80.1%、Opus 5.5 66.8%。这是「真把整本手册塞进去做检索」的场景,不是摘要。
对国内用户最现实的一条:100 万上下文全窗口同价,意味着往上下文里多塞 80 万 token 不多收钱。要处理财报附注、国标条款、几万行的老代码库,这档定价比分数更有意义。
官方的安全自述:拒答率、作弊率与「少做」
Google 在发布文里罕见地给了一串行为指标(均为内部评测,非第三方):
- 拒答率:Terminal-Bench 4.0 上只拒 1.98%,Terminal-Bench-Science 上 0%;官方强调这是「比 Carbon 拒绝更少合法工作」的前提下做到与 Carbon 同级的滥用防护。
- 作弊:Terminal-Bench 4.0 上 0.0%(与 Carbon 持平);自家编码作弊评测里只有 2.45% 走捷径,是 Gemini 4 系列最低。
- 越界:agentic 安全套件里不当行为率 0.09%,agent 诚实性评测通过率 99.2%。
- 欠服务与过度越权:相比 Carbon,低服务减少 43%–56%,越权减少 15%–35%。
- 官方称在 Antigravity 内部测试里录到「迄今最低的编造率」。
这些数字全是自己报的,交叉验证不了,但「拒答 1.98%」这类指标值得盯——它直接决定每天有多少次请求被白拦。
网络安全那条线:只给受信任防御者
Neon 单独做了个 cyber 变体:
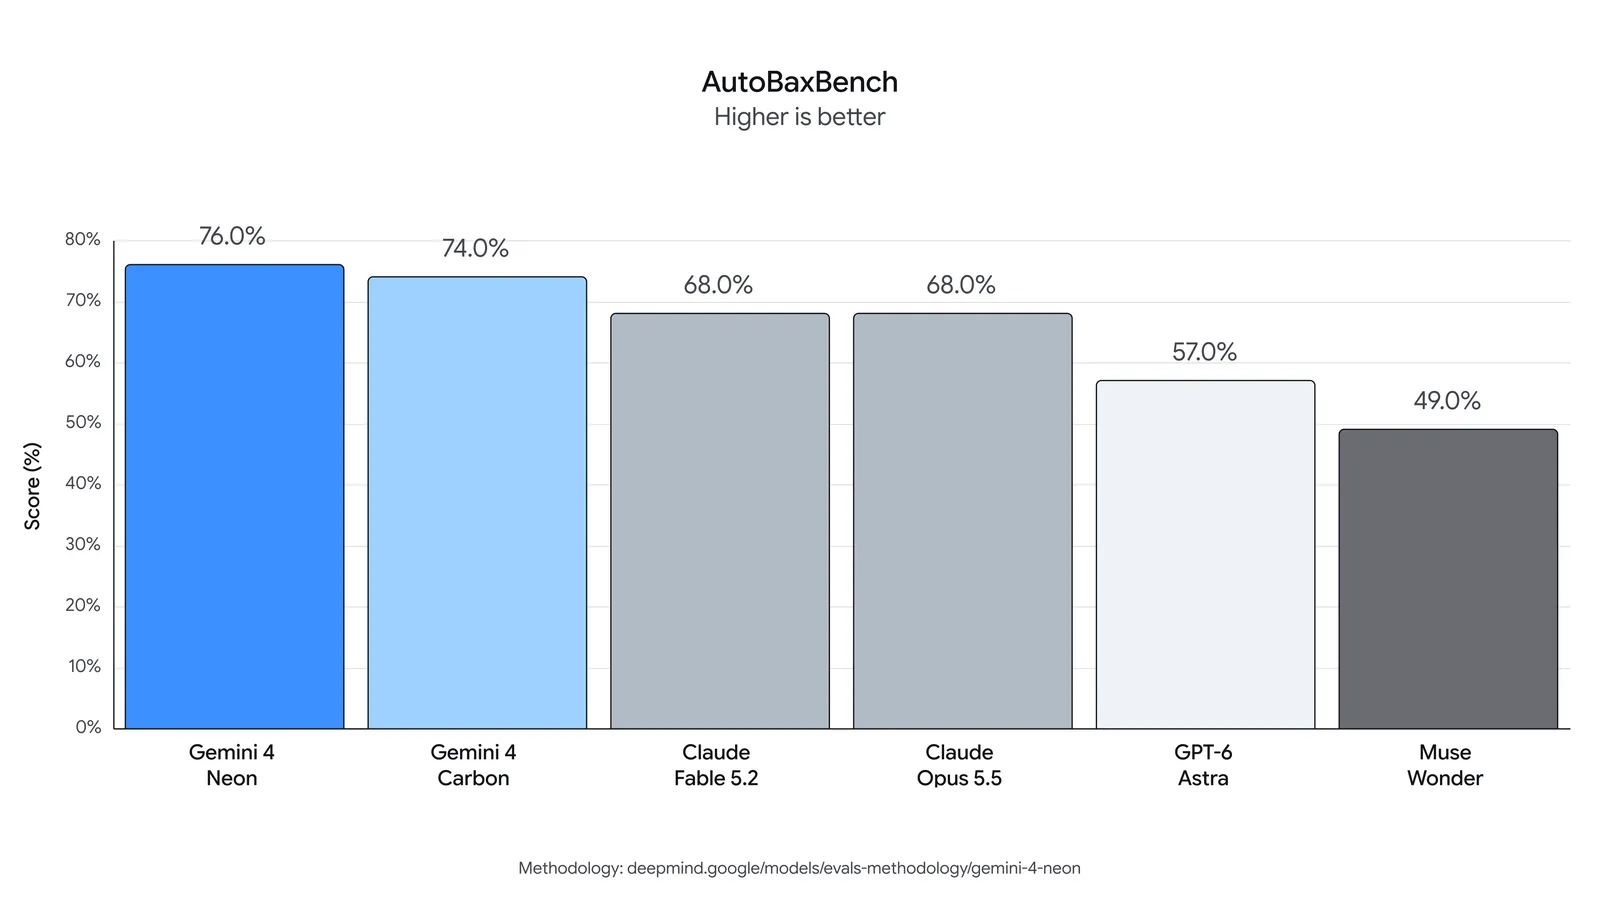
- AutoBaxBench(生成安全代码):easy/medium/hard 三档全部优于 Carbon,hard 档 76% 为 SOTA。
- WebExploitBench v1.2(渗透测试):51.26% SOTA,官方称成本是同级大模型的一半。
- 覆盖漏洞发现、验证、修补的完整流程。
可用性上有一条硬边界:Gemini 4 Neon for cyber 未来几天只通过 Fairwind Program 开放给「受信任的防御方」,不是公开 API。对照今年 11 月 GAO 那份隐蔽测试报告(四个消费级模型 12 小时内给出可用袭击方案),Google 这条分级路线是被监管压力推出来的标准姿势。
 图源:blog.google
谁该换,谁别换
该换的
- 每天跑长流程 agent(几十次工具调用、跨文件改代码、读大量文档)的团队:Neon 的 high 档是当前性价比最好的默认,$3.74/任务比 Carbon 便宜一半以上。
- 需要一次性吃下 50 万字级材料的分析/合规/法务场景:100 万上下文同价,GraphWalks 95.2%。
- 已经在 Antigravity 里用 Carbon 的人:把 Orchestrator 换成 Neon 主控 + Hydrogen 子 agent,官方明说这是设计用法。
别急着换的
- 只做高难单点代码修改的:Terminal-Bench 4.1 与 FrontierCode 2.0 上 Opus 5.5 仍领先,且 Claude 生态的改动验证链路更成熟。
- 预算极紧的批处理:Hydrogen $1.50/$7.50 或 3.5 Flash-Lite $0.30/$2.50 更合适,Neon 不是这个价位的东西。
- 需要免费额度的个人开发者:Neon 没有免费档。
一个时间点:Carbon 的 $2/$10 促销 11 月 30 日结束。如果手里有跑 Carbon 的稳定工作流,这一周要么趁促销把批量任务跑完,要么趁现在把评测在自己数据上重做一遍,决定 12 月 1 日之后是留 Carbon 还是转 Neon——涨价后的 Carbon($4/$20)在自家价格表里已经是「更贵、分数还低 1 分」的那一档。
数据来源
- Google 官方发布文(2026-11-18,Koray Kavukcuoglu):价格、思考档位、基准数字、安全自述、cyber 与 Fairwind 计划
- Artificial Analysis Intelligence Index v5.0.1 / Coding Agent Index:四档分数、每任务耗时与成本
- Vals Index v2.2、Zapier AutomationBench、Andon Labs Vending-Bench 2、Arena Agent Arena Index:官方引用的第三方排名
- DataCamp、Requesty、Lindy、TNW 的对照整理:Batch/Flex/Priority 定价、上下文与输出上限、Carbon 促销到期时间