一句话总结
Anthropic 近日公开了 Claude 输出内容中「隐形文本水印」的工作原理——它使用的是 Google 开源的 SynthID-Text 系统的一个版本。这意味着,继图像、音频之后,文本溯源也开始从「可选功能」走向头部 AI 实验室的「默认标配」。
发生了什么:Claude 开始给文字「盖章」了
据 The Verge 报道,Anthropic 正式解释了 Claude 隐形文本水印的运作方式:它使用的是 Google 开源的 SynthID-Text 系统的「一个版本」。
所谓「隐形水印」,指的是在 AI 生成文本时,通过极微小的、人眼无法察觉的方式修改文字生成过程,从而在输出中留下一个可验证的「签名」。普通读者读不出任何差别,但持有「检测密钥」的一方,却能在统计层面判断这段文字是否由特定模型生成。
这一动作之所以值得关注,是因为它把「AI 文本溯源」从学术讨论和监管要求,推进到了产品级落地——而且是 Claude 这样的头部大模型。
SynthID-Text 是怎么工作的?
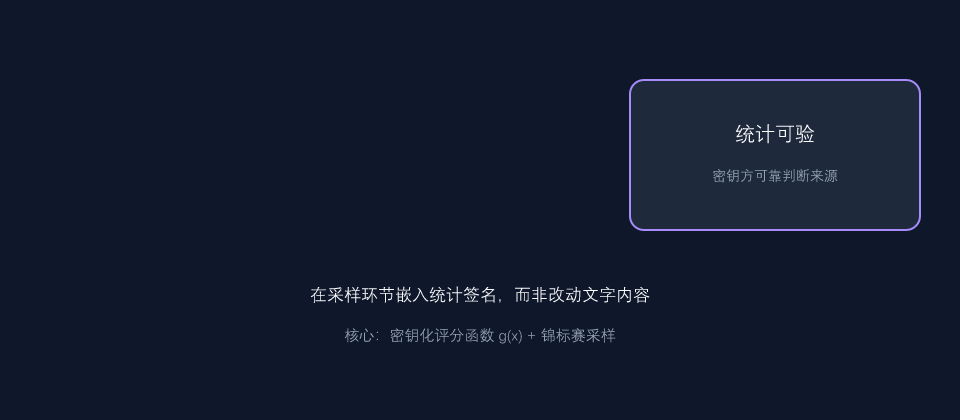
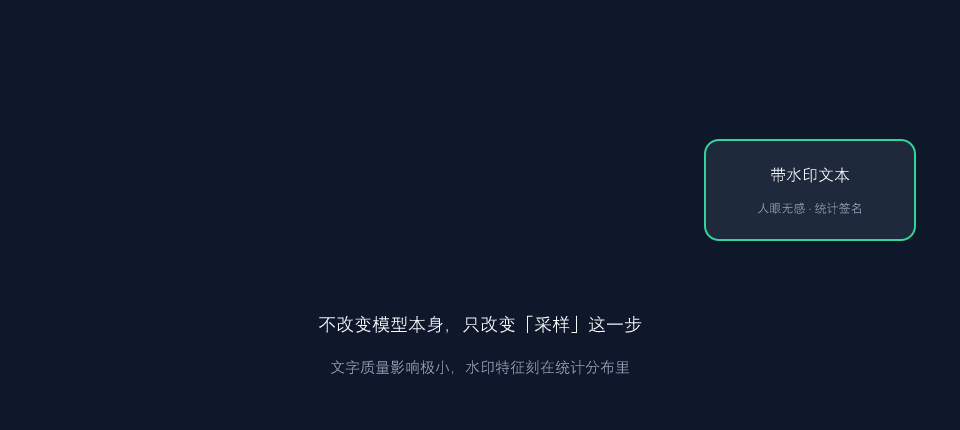
SynthID-Text 是 Google DeepMind 于 2024 年开源的一套文本水印方案(相关成果发表于《自然》期刊)。它的核心思想很巧妙:不改变模型本身,只改变「采样」这一步。
大模型生成文字时,并不会一次性「拍板」下一个词,而是为每个候选 token 计算一个概率分布,然后从中采样。SynthID-Text 的做法是:
- 引入一个密钥化的评分函数(g-function):用一个只有「水印方」持有的密钥,结合当前上下文,为每个候选 token 打一个伪随机的「隐藏分数」。
- 倾向采样高分的 token:模型在采样时,会稍微偏向那些「隐藏分数更高」的 token(即所谓的「锦标赛采样」,tournament sampling)。
- 水印因此嵌入:因为评分函数由密钥决定,最终生成文本中「高分 token」的占比会显著高于正常水平——这就是隐形水印的载体。
关键点在于:这个过程对文字质量的影响极小,读者完全无感,但统计特征却牢牢刻在了文本里。
如何检测:统计检验的巧妙之处
既然水印「隐形」,那怎么判断一段文字是不是 Claude 写的?答案是统计检验。
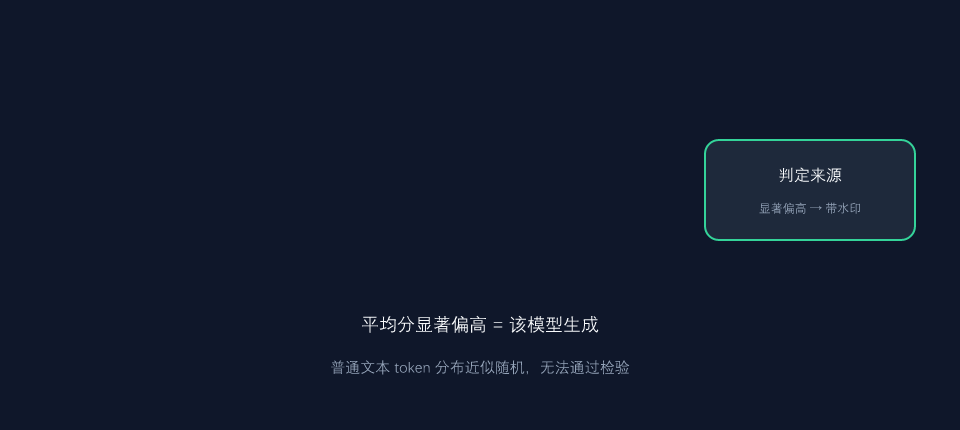
检测方拿到同样的密钥,对目标文本的每个 token 重新计算那个「隐藏分数」,然后看平均分是否显著偏高:
- 如果是带水印的文本:因为生成时偏向选高分 token,平均分会被明显「抬高」。
- 如果是普通文本(人写的,或其他无此水印的模型生成):token 分布接近随机,平均分接近理论均值,无法通过检验。
这套机制有几个漂亮的特性:
- 无需联网、无需存库:检测只靠密钥和文本本身,不需要保存海量「生成记录」。
- 对改写有一定鲁棒性:轻度改写、少量删改通常不会破坏统计特征。
- 无法被「肉眼识破」:因为没有明显的格式或标记变化。
三条技术路线:水印、元数据、显式标识
「AI 内容溯源」其实不止水印一种做法。当前主流的路线大致有三条,各有优劣:
| 路线 | 代表 | 原理 | 优点 | 局限 |
|---|---|---|---|---|
| 隐形水印 | SynthID-Text(Claude) | 修改采样过程,嵌入统计特征 | 肉眼无感、无需存库 | 重度改写可能失效 |
| 元数据签名 | C2PA / Content Credentials | 在文件里嵌入可验证的溯源信息 | 信息丰富、可验签 | 截图/复制粘贴易丢失 |
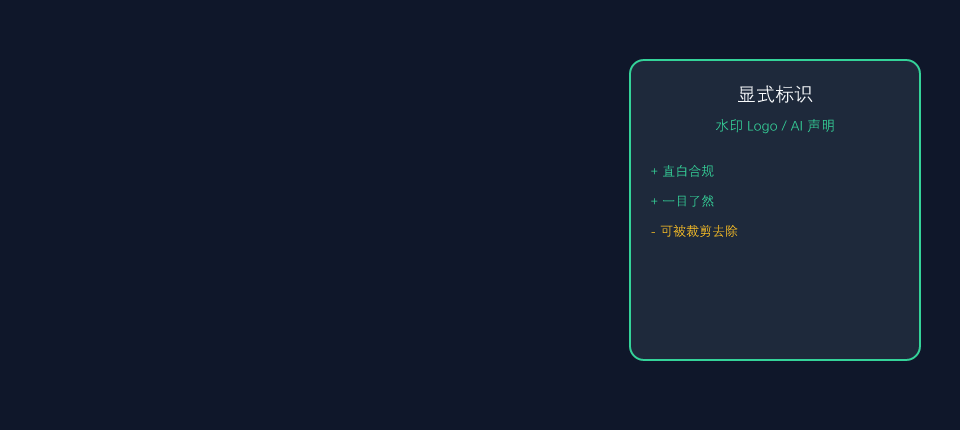
| 显式标识 | 水印 Logo、AI 声明 | 明文标注「AI 生成」 | 直白、符合监管 | 可被裁剪/去除 |
监管层是推动这一切的重要力量:欧盟《AI 法案》、中国《人工智能生成合成内容标识办法》都要求 AI 生成内容可识别、可溯源。技术方案因此从「可选项」变成了「合规项」。
为什么重要:溯源从「可选」走向「标配」
Anthropic 采用 SynthID-Text 的版本,释放了一个清晰信号:头部 AI 实验室正在主动拥抱文本溯源。
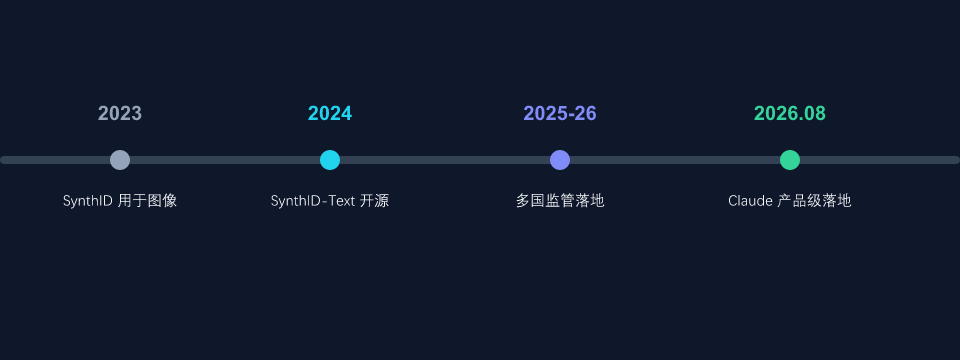
回顾这条演进路线,节奏非常快:
- 2023 年:Google DeepMind 推出 SynthID,率先用于 Imagen 生成图像的水印。
- 2024 年:SynthID-Text 开源,文本水印方案成熟并发表于《自然》。
- 2025–2026 年:多国监管落地,AI 生成内容标识成为合规要求。
- 2026 年 8 月:Anthropic 公开 Claude 文本水印方案,头部大模型产品级落地。
争议与局限
尽管意义重大,文本水印并非万能,也存在一些现实争议:
- 对抗性改写:用另一款模型「重写」一遍,可能稀释或抹除水印特征。
- 误报风险:统计检验存在假阳性概率,可能把纯人类文本误判为 AI 生成。
- 开源模型的复制:SynthID-Text 是开源的,任何人都能「逆向」其评分逻辑,削弱检测有效性。
- 隐私担忧:密钥与检测能力的集中,可能被滥用为「内容审查」工具。
也正因如此,此前我们曾报道过的 watermarks-remover 这类「抹除水印」工具才会在开源社区迅速走红——这场「标记 vs 抹除」的攻防战,才刚刚开始。
总结
- Anthropic 公开了 Claude 隐形文本水印方案,采用 Google 开源 SynthID-Text 的版本,标志文本溯源进入产品级落地。
- 技术原理是「采样端嵌入 + 统计端检测」:用密钥化评分函数影响 token 采样,再通过统计检验判断来源。
- 水印与 C2PA 元数据、显式标识共同构成 AI 溯源的技术三角,监管是最大推手。
- 但水印仍面临对抗改写、误报、逆向破解等挑战,「标记 vs 抹除」的攻防仍将持续。
数据来源:The Verge(2026-08-17 报道)及 Google DeepMind SynthID-Text 公开资料。本文为技术解读,部分机制描述基于公开研究整理。