一句话总结
2026 年 9 月 20 日,阿里通义千问开源 Qwen-Image 2.1。它把文生图和图像编辑合成了同一个模型,视觉生成部分只有 7B 参数(32 层单流 DiT);更关键的是它的 VAE 本身就是一个 64 通道 RGBA 自编码器——模型能直接吐出带 alpha 通道的透明贴图,不用再跑一遍抠图。同时支持最多 10 张参考图、圈选/涂抹/掩码指定局部编辑、原生 2K 分辨率,且 Diffusers、ComfyUI、vLLM-Omni、SGLang、LightX2V 全部 Day-0 支持。国内用户可以直接在 wuli.art 上免费试。
数据来源
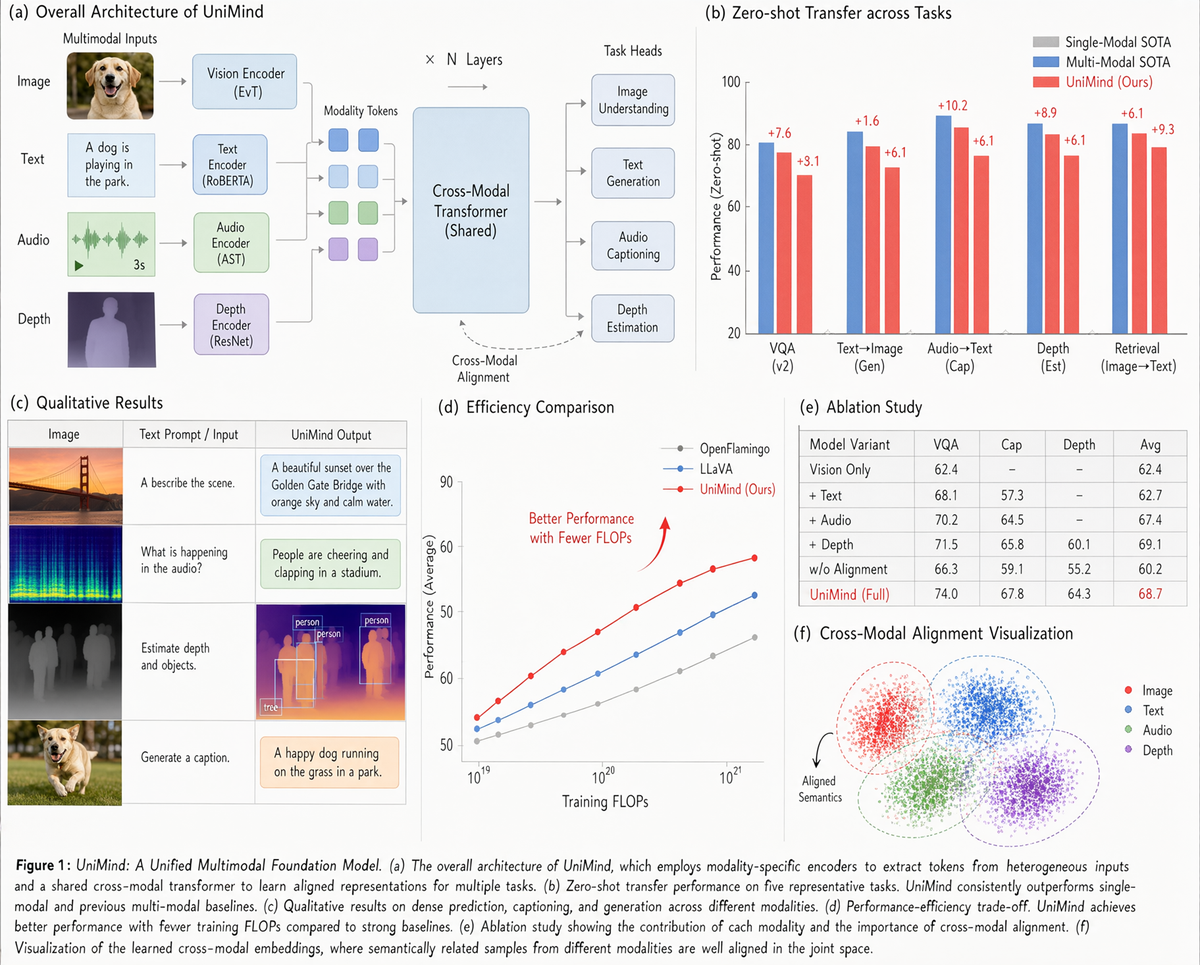
本文事实依据来自:Qwen-Image 2.1 官方 GitHub 仓库 README(QwenLM/Qwen-Image-2.1)、Hugging Face / ModelScope 模型页信息、以及仓库中列出的 Day-0 生态 PR(Diffusers #14804、SGLang #39983)。文中示例图片全部下载自官方仓库 README 引用的官方图床(qianwen-res.oss-cn-beijing.aliyuncs.com、img.alicdn.com、raw.githubusercontent.com),已下载到本地并注明出处,未使用外链热链。架构示意图由 uuaihub 依据官方 README 文字说明自行绘制,非官方原图。
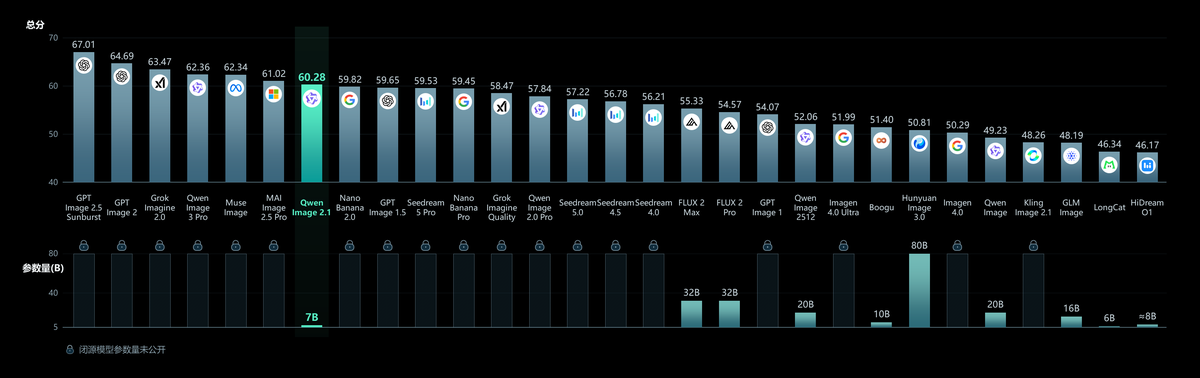
上图来自 Qwen-Image 2.1 官方仓库 README,版权归阿里通义千问团队所有。
为什么这次发布值得单独写一篇
过去一年,开源图像模型基本沿着两条线各自演进:做文生图的(把提示词变成图,画质越来越卷)和做图像编辑的(听话地改局部,一致性越来越强)。用户拿到的实际是两套权重、两条推理管线、两份显存预算。
Qwen-Image 2.1 的第一个卖点就是把这两条线并到同一个模型里——同一个权重既做文生图,也做图像编辑。而在图像编辑这件事上,“能不能改”早已不是门槛,“改完还认得出是谁、是不是同一个东西”才是。这一版把它拆成了三个具体能力:最多 10 张参考图、引导式局部编辑(圈选 / 涂抹 / 独立掩码)、人物与商品的同一性保持。
第二个卖点更少见,也是本文最想讲的一点:原生透明。
这次更新了什么:官方口径的四条
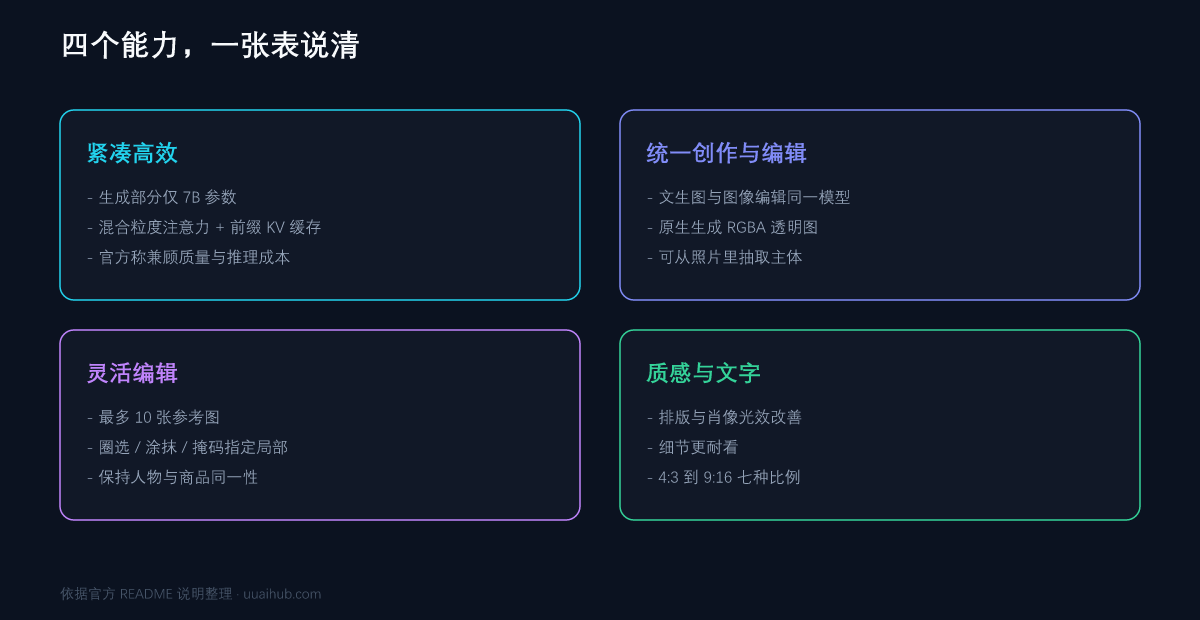
① 紧凑高效。 视觉生成组件(32 层单流 DiT)7B 参数,采用混合粒度注意力(mixed-granularity attention)并支持前缀 KV 缓存复用,官方称能在较低算力成本下拿到不错的画质。对本地跑图的人来说,这句话的实际含义是:显存门槛降低了。
② 原生透明,创作与编辑统一。 可以从文本生成普通图或透明图(RGBA),可以编辑透明图层,也可以从真实照片里抽取主体——全都在一个模型里完成。
③ 编辑更灵活。 支持最多 10 张参考图;可通过圈选(circles)、涂抹标注(painted annotations)或独立掩码指定局部修改;并保持人物与商品的同一性。
④ 质感与审美。 官方称改进了排版(typography)、肖像光效与细节表现。文字渲染一直是图像模型的传统弱项,这一条如果成立,对做海报、做封面的人是直接增益。
架构拆解:为什么它能”零成本”出透明图
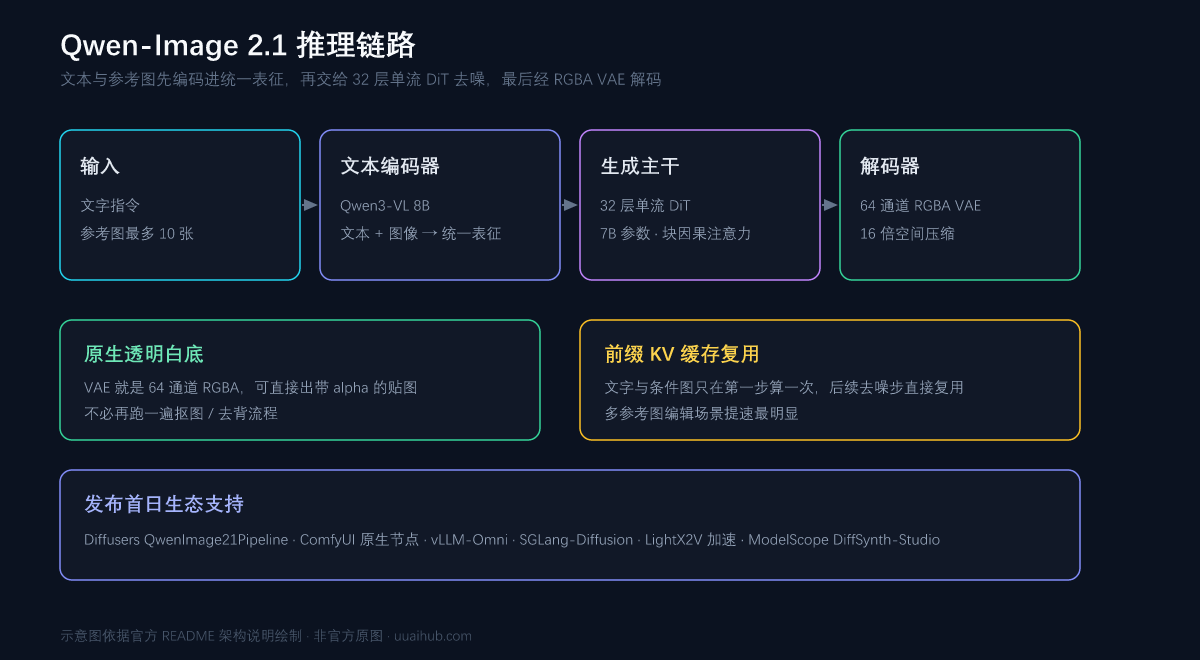
官方在 README 里把架构写得很清楚,四块拼起来看:
| 组件 | 官方规格 |
|---|---|
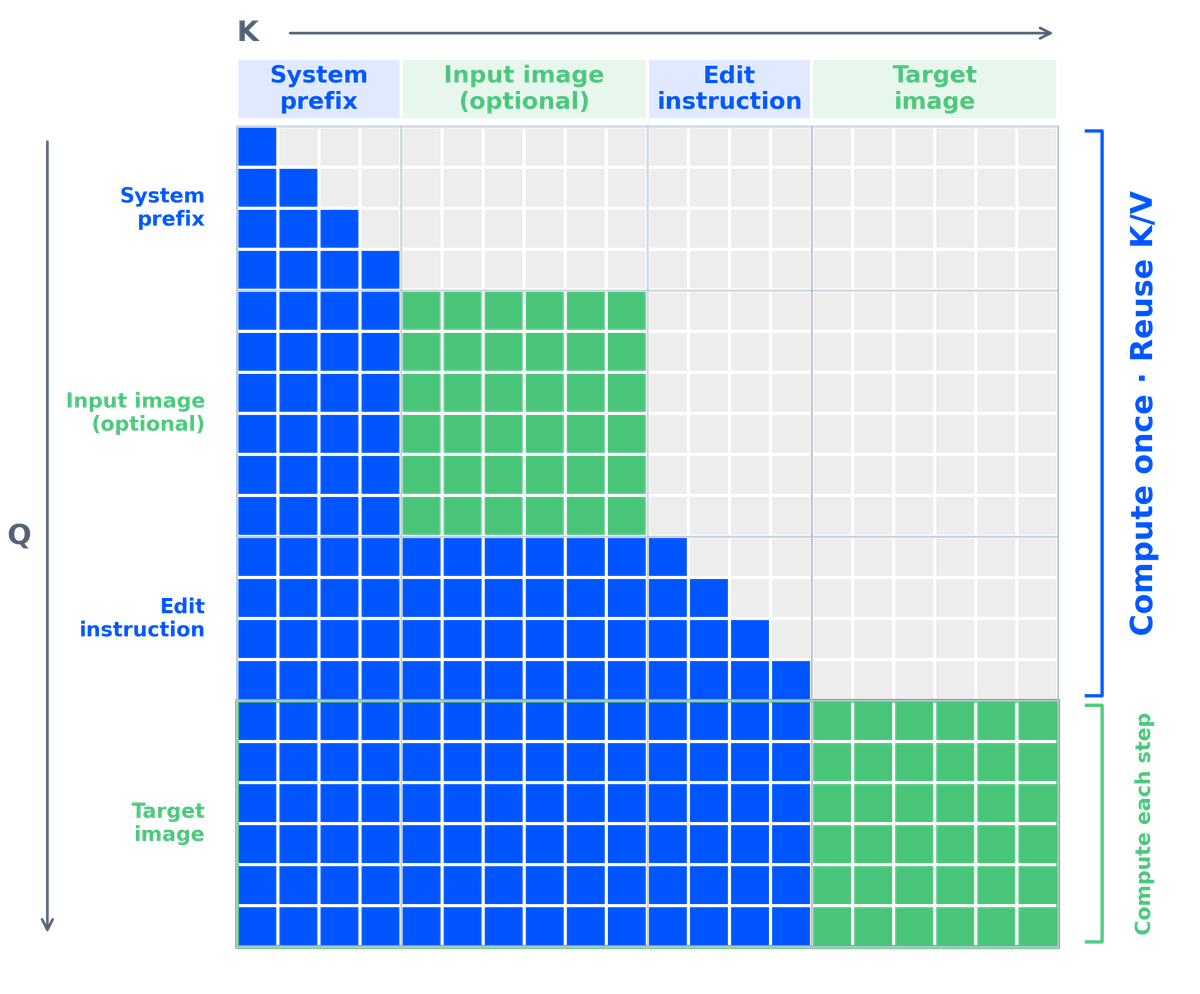
| 生成主干 | 单流 DiT,32 层、7B 参数,块因果注意力((q_idx >= kv_idx) or same_image_block);文本走 token 级因果掩码,图像走 chunk 级双向掩码 |
| 文本编码器 | Qwen3-VL 8B(视觉语言模型)——把文字指令和条件图编码成统一表征 |
| VAE | 64 通道 RGBA 自编码器,16 倍空间压缩,原生支持透明 |
| 调度器 | Flow Matching + Euler 离散调度 + 动态偏移 |
关键在 VAE 那一行。 大多数图像模型解出来的是三通道 RGB,你要透明底,就得再上一个抠图/去背模型,或者在推理后面接一个 alpha 预测头。而 Qwen-Image 2.1 的解码器本身就是 64 通道 RGBA——所以”透明”不是后处理,而是模型的第一类输出。
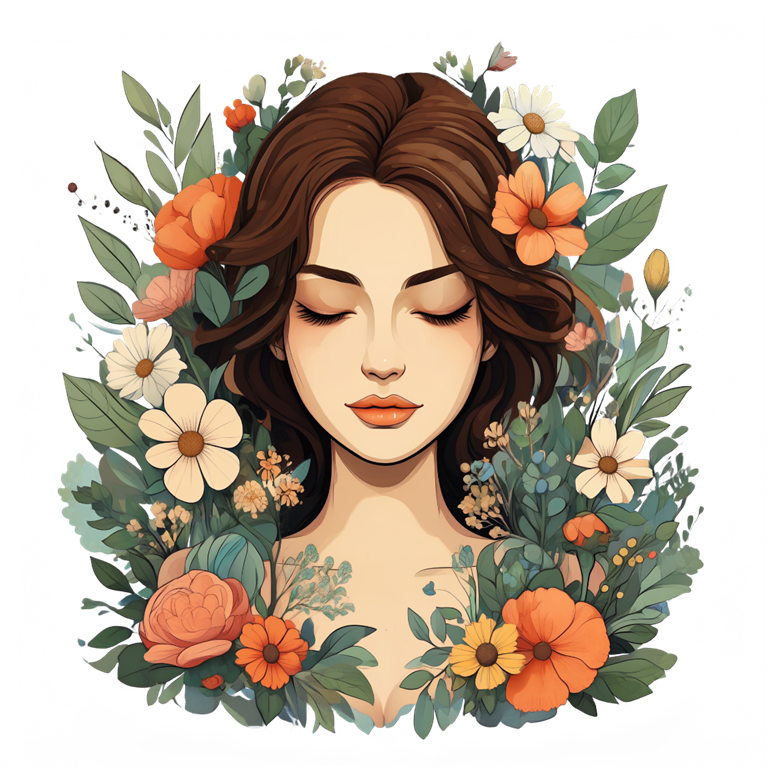
官方推荐在提示词里显式写清楚,例如:“This is an RGBA image with transparency. <你的描述>. The image has alpha channel and the background is transparent.” 只有显式声明时才会输出 alpha 通道。
另一块值得记的是前缀 KV 缓存复用:当检查点带 causal_condition: true(默认开启)时,文字指令和条件图只需在第一步去噪时计算一次,后续所有去噪步直接复用。官方明确说这对多条件图(多参考图)的编辑任务提速最明显——因为条件越多,重复计算的浪费就越大。
编辑能力实测观感:官方放出来的三组例子
多参考图 → 组合成一张。 官方给的两个例子很能说明设计意图:从六张单人人像参考图生成一张合影;以及从**五张参考图(模特、衣服、鞋、包、帽子)**拼出一套完整穿搭。这正是电商和广告场景里最耗人力的活。
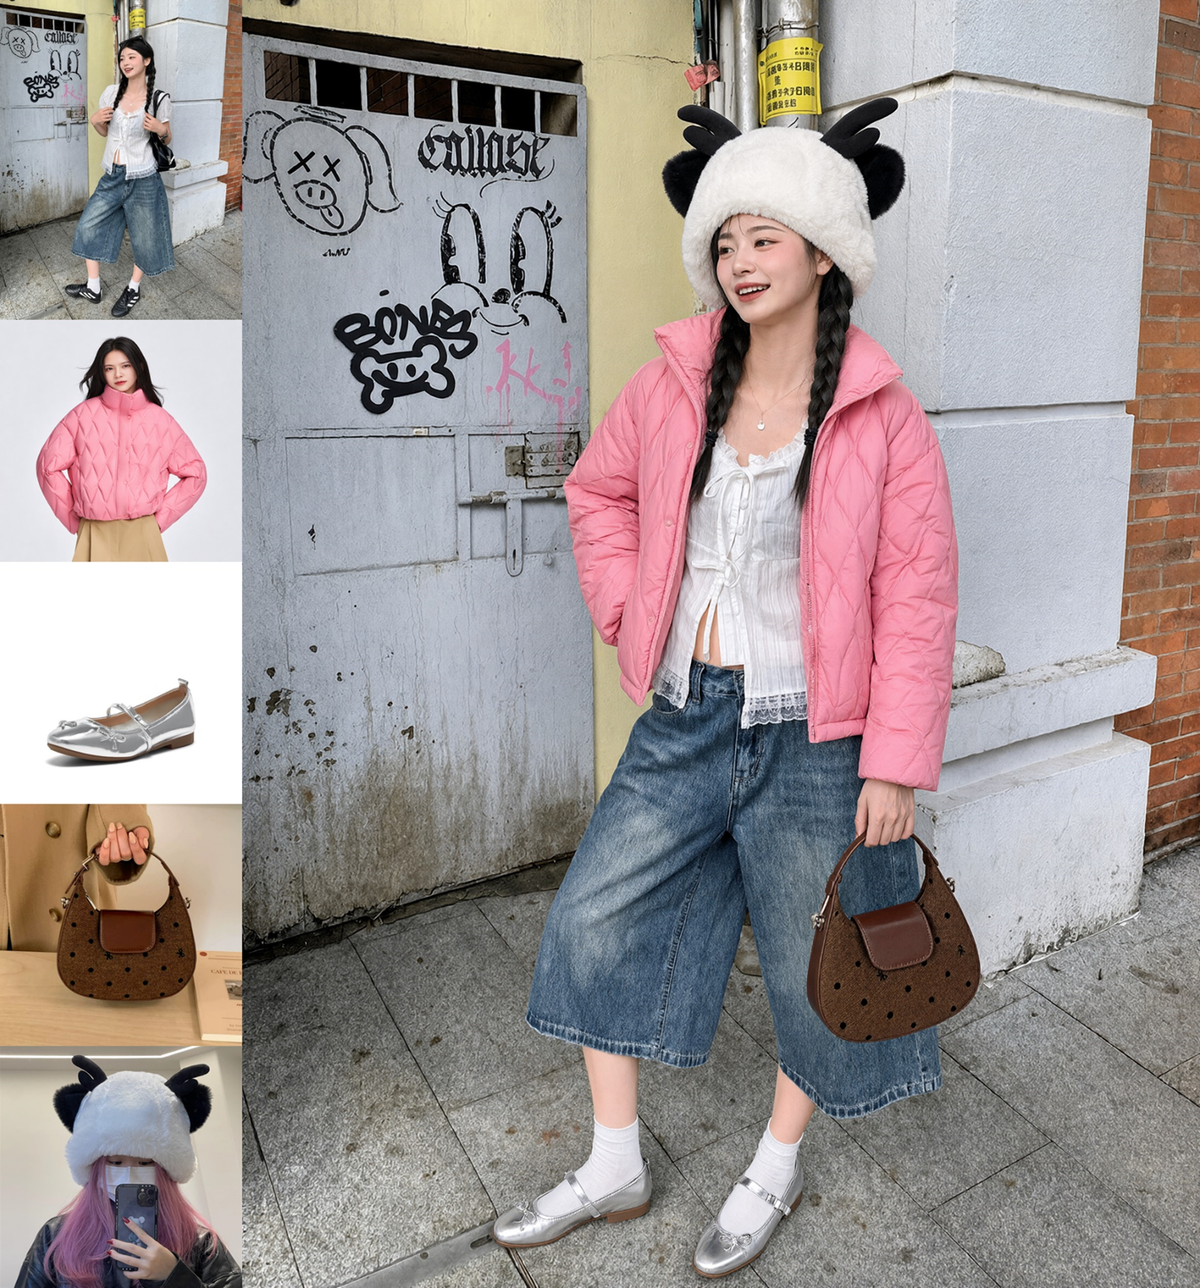
上图与下方人物/排版示例均来自 Qwen-Image 2.1 官方仓库 README,版权归阿里通义千问团队所有。
圈选引导的多区域编辑。 官方示例是同一张人像上做三件事:去掉手表、改发色、换衣服——用画圈的方式逐块指定,而不需要额外标注工具。
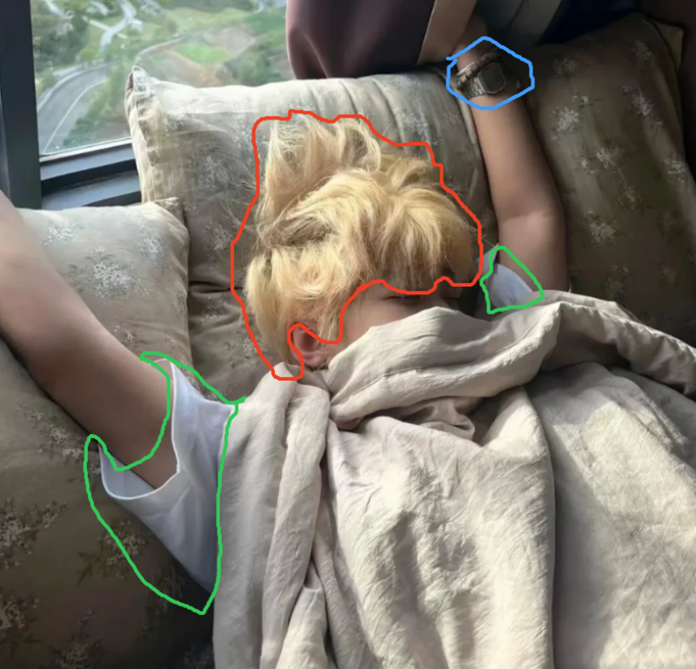
人物与商品同一性。 改完之后”还是那个人/那件商品”,是这类编辑模型真正的及格线:
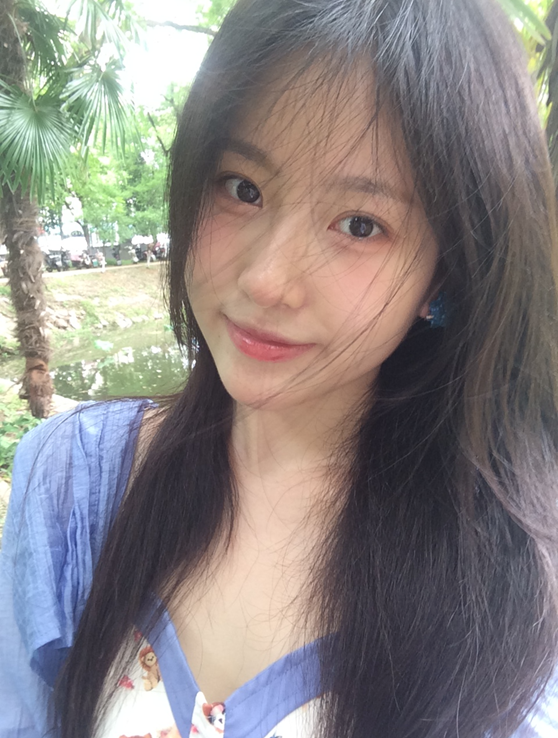
文字渲染。 排版能力直接决定了它能不能用于做海报、封面、贴图这类带字的设计物:
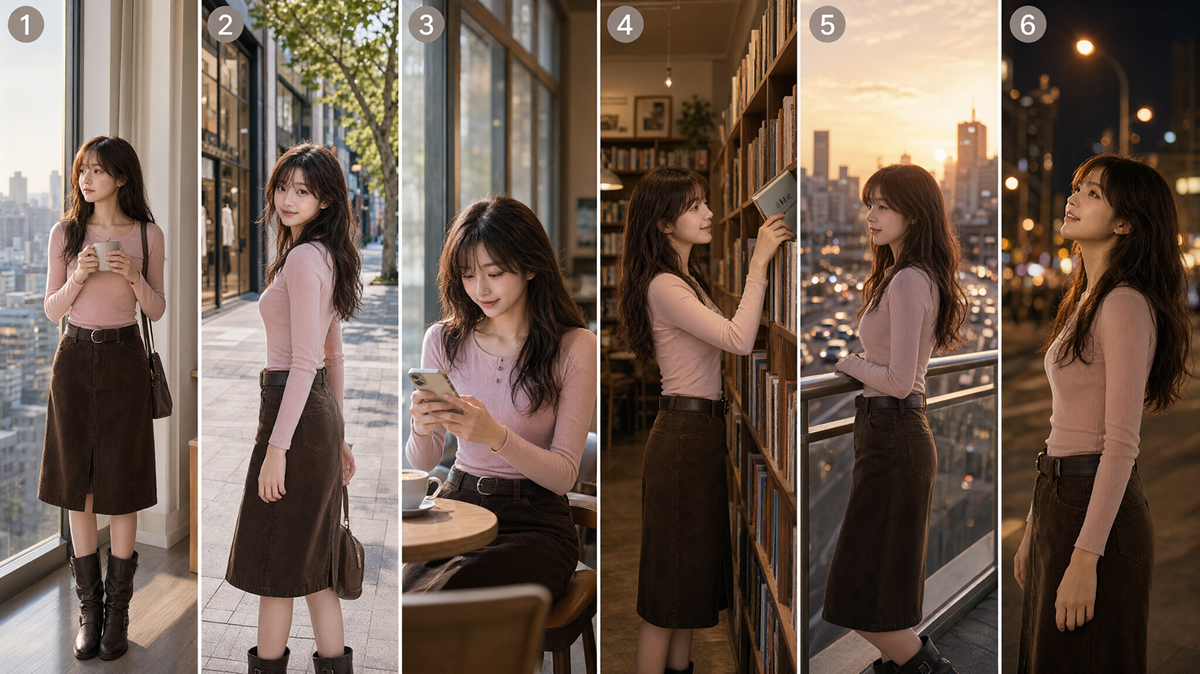
分镜与全景。 官方还演示了两件事:从一张自拍生成全景图,以及从三视图角色设定生成分镜——后者对做漫画、短剧、游戏美术的人是明显的效率工具。
怎么跑起来:四条路,按难度排序
路线一:Diffusers(最推荐,官方首选)
pip install torch>=2.4.0
pip install transformers>=5.17
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt='A neon shop sign that reads "QWEN IMAGE 2.1", rainy night, reflections on wet pavement',
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("t2i_example.png")
编辑模式只是多传一个 image=;多参考图就直接传一个图片列表:
images = [Image.open(f"ref_{i}.png") for i in range(3)]

result = pipe(
    prompt="These three characters are sitting around a campfire in a forest",
    image=images,                 # 最多 10 张
    num_inference_steps=40,
)
result.save("multi_ref_example.png")
显存不够加一行 pipe.enable_model_cpu_offload();默认是 40 步、2048×2048;原生支持七种比例:1:1(2048×2048)、4:3(2400×1792)、3:4、3:2(2528×1696)、2:3、16:9(2752×1536)、9:16(1536×2752)。
路线二:ComfyUI(如果你本来就在用)
仓库 README 明确写了 ComfyUI Day-0 原生支持,并为它单独发布了权重仓库 Comfy-Org/Qwen-Image-2.1,同时给了两个可直接导入的官方工作流:文生图(image_qwen_image_2_1_t2i.json)和图像编辑(image_qwen_image_2_1_image_edit.json)。对不写代码的人来说这是最省事的一条路。
路线三:vLLM-Omni / SGLang(要吞吐、要多卡)
- vLLM-Omni:支持跨步前缀 KV 缓存复用、CUDA Graph 解码、FP8 量化、TP/Ulysses 并行、分布式 VAE 解码(带自适应 OOM 恢复)、CPU offload,
vllm serve Qwen/Qwen-Image-2.1 --omni --port 8091即可起服务,还提供--step-execution的批级调度。 - SGLang-Diffusion:原生支持文生图、多图编辑与透明 RGBA 输出,
sglang generate --model-path Qwen/Qwen-Image-2.1 ...一行起,官方有 cookbook。 - LightX2V:面向消费级显卡的加速方案,官方给了 Qwen-Image-2.1 专用脚本目录。
路线四:直接提示词重写,先解决”短提示词出图难看”
官方额外放出了两个基于 Qwen3.5-VL 9B 微调的提示词重写模型(文生图用 Qwen-Image-2.1-PE-T2I、编辑用 Qwen-Image-2.1-PE-I2I),把一个短提示词扩写成详细描述,并顺带返回建议的宽高比:
python run_vllm.py --task t2i \
    --ckpt Qwen/Qwen-Image-2.1-PE-T2I \
    --input data/t2i_example.jsonl --output out.jsonl
# 输出: {"rewritten_prompt": "<长而详细的英文提示词>", "wh_ratio": "16:9"}
这一步在实际生产里往往比换模型更提升成片率——普通用户写不好长提示词,是出图质量方差的最大来源。
国内用户怎么用:优先走这两条
① wuli.art——官方在 README 里点名了它:面向中国大陆用户免费开放 Qwen Image 2.1 的全部能力(Chatbox 与 Canvas 两种形态,包括透明背景生成)。
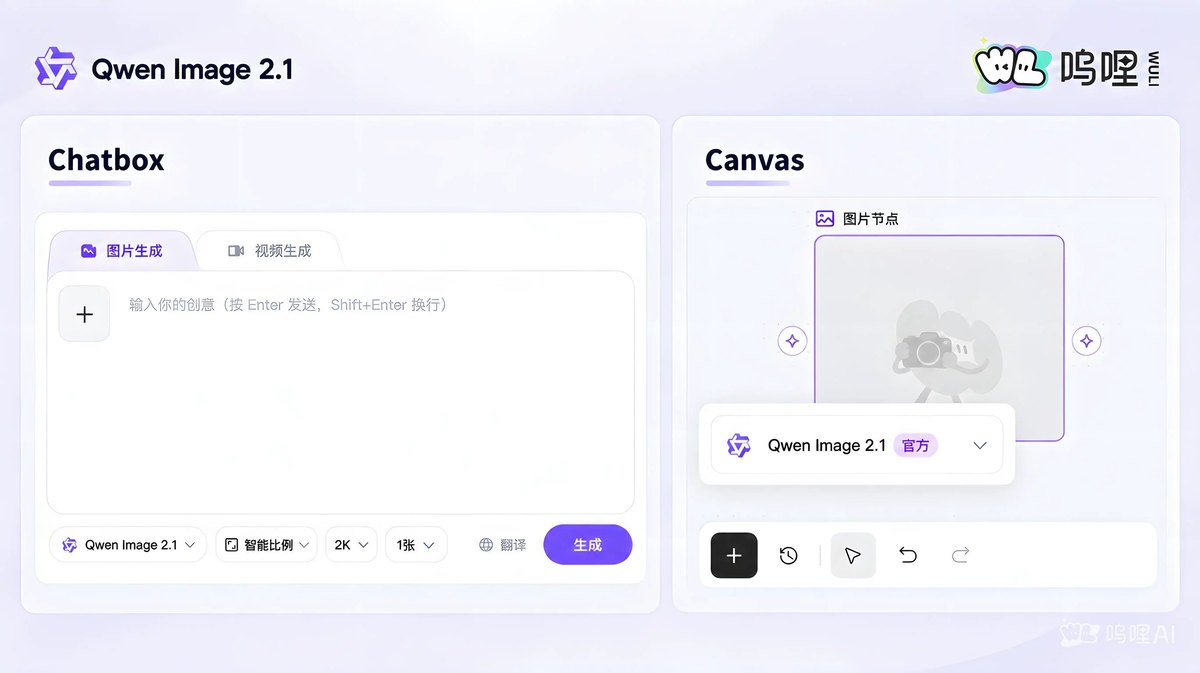
上图来自 Qwen-Image 2.1 官方仓库 README(引自阿里图床),版权归原作者所有。
② ModelScope(魔搭)——官方称魔搭完整支持 Qwen-Image-2.1:基于其开源的 DiffSynth-Studio 框架,支持模型下载、在线生成与 LoRA 训练。也就是说,想自己微调风格的人不必先去折腾本地环境。
③ 国产芯片——这条容易被忽略但很重要:本次发布通过 FlagOS(一套全开源异构芯片软件栈)提供了直接的多芯片支持,用 FlagGems 算子库 + Torch-FL 插件让 Diffusers 在非 NVIDIA 平台上”零代码改动”运行,官方声明各平台推理精度已与官方实现对齐,并在 FlagRelease 下发布了 8 个芯片平台的预构建镜像与权重(例如平头哥镇岳、Arm)。此外 AMD Radeon 走 ROCm 路线也已支持。
这次的差异点,和必须说清楚的一处限制
差异点(都是官方在 README 里明确写的):
| 维度 | Qwen-Image 2.1 的做法 |
|---|---|
| 透明输出 | VAE 即 64 通道 RGBA,透明是第一类输出,不需要后置抠图 |
| 文生图与编辑 | 同一个模型、同一份权重 |
| 参考图数量 | 最多 10 张 |
| 局部编辑指定方式 | 圈选 / 涂抹标注 / 独立掩码 三种 |
| 分辨率 | 原生 2K,七种预设比例 |
| 生态就位速度 | Diffusers / ComfyUI / vLLM-Omni / SGLang / LightX2V 全部 Day-0 |
必须说清楚的一处限制:许可证不是 Apache-2.0。 官方 README 的 License Agreement 一节指向的是 Qwen Research License Agreement,而不是社区最熟悉的 Apache 2.0。“开源可下载”和”可以随便商用”是两件事——如果你的业务场景敏感(例如对外提供生成服务、或用于商业产品内嵌),请务必先把这份协议读完再动手,不要默认它和 Apache-2.0 项目同等待遇。
适合谁
- 做电商 / 商品图的人:多参考图合成 + 同一性保持,是省人力的直接场景。
- 做贴图、封面、海报的人:原生透明出图意味着省掉一整条抠图流水线。
- ComfyUI 用户:Day-0 官方工作流,装了就能用,改动成本最低。
- 要私有化部署的团队:7B 生成组件 + CPU offload + vLLM-Omni 的 FP8 与并行方案,硬件选择面比闭源 API 宽得多。
- 在国产芯片上跑模型的人:FlagOS 的 8 平台预构建是目前少见的”开箱即用”承诺。
暂时别急着上的情况:需要商用授权的场景(先读许可证);需要极高稳定性排期的生产管线(刚发布一周,生态还在追);以及指望它替代专业修图软件的人——它现在解决的是”生成与局部编辑”,不是非破坏性的图层工作流。
总结
- 一句话:Qwen-Image 2.1 把”文生图 + 图像编辑 + 原生透明”装进了同一个 7B 生成组件里,并在发布当天就跟上了 Diffusers、ComfyUI、vLLM-Omni、SGLang、LightX2V 五条生态线。
- 最实用的一点:VAE 就是 RGBA——透明贴图是模型的直接输出,不是后处理。
- 最容易被忽略的一点:官方附带了两个 Qwen3.5-VL 9B 的提示词重写模型,实际用起来可能比换模型更提高成片率。
- 最该先做的一件事:如果你打算商用,先读 Qwen Research License Agreement。
- 想马上试:国内直接上 wuli.art(官方点名免费开放全部能力),或去魔搭用 DiffSynth-Studio 在线生成 / 训练 LoRA。
官方仓库:github.com/QwenLM/Qwen-Image-2.1 权重:HuggingFace · ModelScope 官方博客:qwen.ai/blog?id=qwen-image-2.1
本文示例图片均下载自 Qwen-Image 2.1 官方仓库 README 所引用的官方图床并已本地化,版权归阿里通义千问团队所有;架构示意图由 uuaihub 依据官方 README 文字说明自行绘制,非官方原图。技术规格以官方 README 表述为准。