一句话总结
9 月 17 日,Anthropic 在自己新成立的 Institute 主页上发了一篇不那么像「营销稿」的文章:《Measurements for understanding the pace of AI development inside frontier labs》。它没有秀模型跑分,而是把自己内部研发的账本摊开了——约 30,000 个 Agent 同时在线、单月超 10 亿次决策、Claude 主导了 26% 的模型研发工作、7 月某一周约 6% 的 AI 研发算力投向安全。同一天,Claude Code 的 Projects 功能被重构成「协调器拆任务、多线程并行干活」,把内部那套协作机制做成了产品。
数据来源:Anthropic Institute《Measurements for understanding the pace of AI development inside frontier labs》(2026-09-17,含 Anthropic R&D Automation Index v2026.07 图表)、Anthropic 官方博客《Collaborate with Claude on Projects》、SiliconANGLE 与 TechCrunch 报道、Ars Technica 与 The Verge 对三大指标的解读、Gate News 对算力分配数据的整理、量子位《Claude Code 大重构!内部 3 万 Agent 管理技术免费开放》、IT之家关于 Claude Code 兼容 AGENTS.md 的报道。
先看三个数字:30,000 / 26% / 6%
这份报告里真正让人停一下的,是三个可以直接拿去打量的数字。
第一个是 30,000。 截至 2026 年 8 月,在 Anthropic 最常用的内部研发平台上,同一时刻大约有 30,000 个 Agent 在做研究与工程工作。注意口径是「同一时刻」(at any one time),不是在报表里累计统计出来的调用次数——这是一条持续开着的生产线。这些 Agent 在 8 月合计触发了超过 10 亿次决策。
第二个是 26%。 按 Epoch AI 的自动化分级(Automation Level,AL),Claude 已经以「AI 主导」(AL4)的方式完成了 Anthropic 26% 的模型研发工作。作为对比,2026 年 2 月这个数字还不到 1%——半年 26 倍。如果标准放宽到「AI 至少能协作」(AL3 及以上),内部超过 90% 的研发流程已经在这一档。
第三个是 6%。 在 7 月 13 日到 7 月 20 日这一周,Anthropic 大约 6% 的 AI 研发算力投向了安全与对齐研究;如果把范围收窄到「AI 驱动的研发」,这一比例是约 12%。官方给出的理由是:算力是 AI 研发流程里最可验证的输入之一,如果未来真要讨论「放慢节奏」,算力是最可能被拿来做杠杆的那一项。
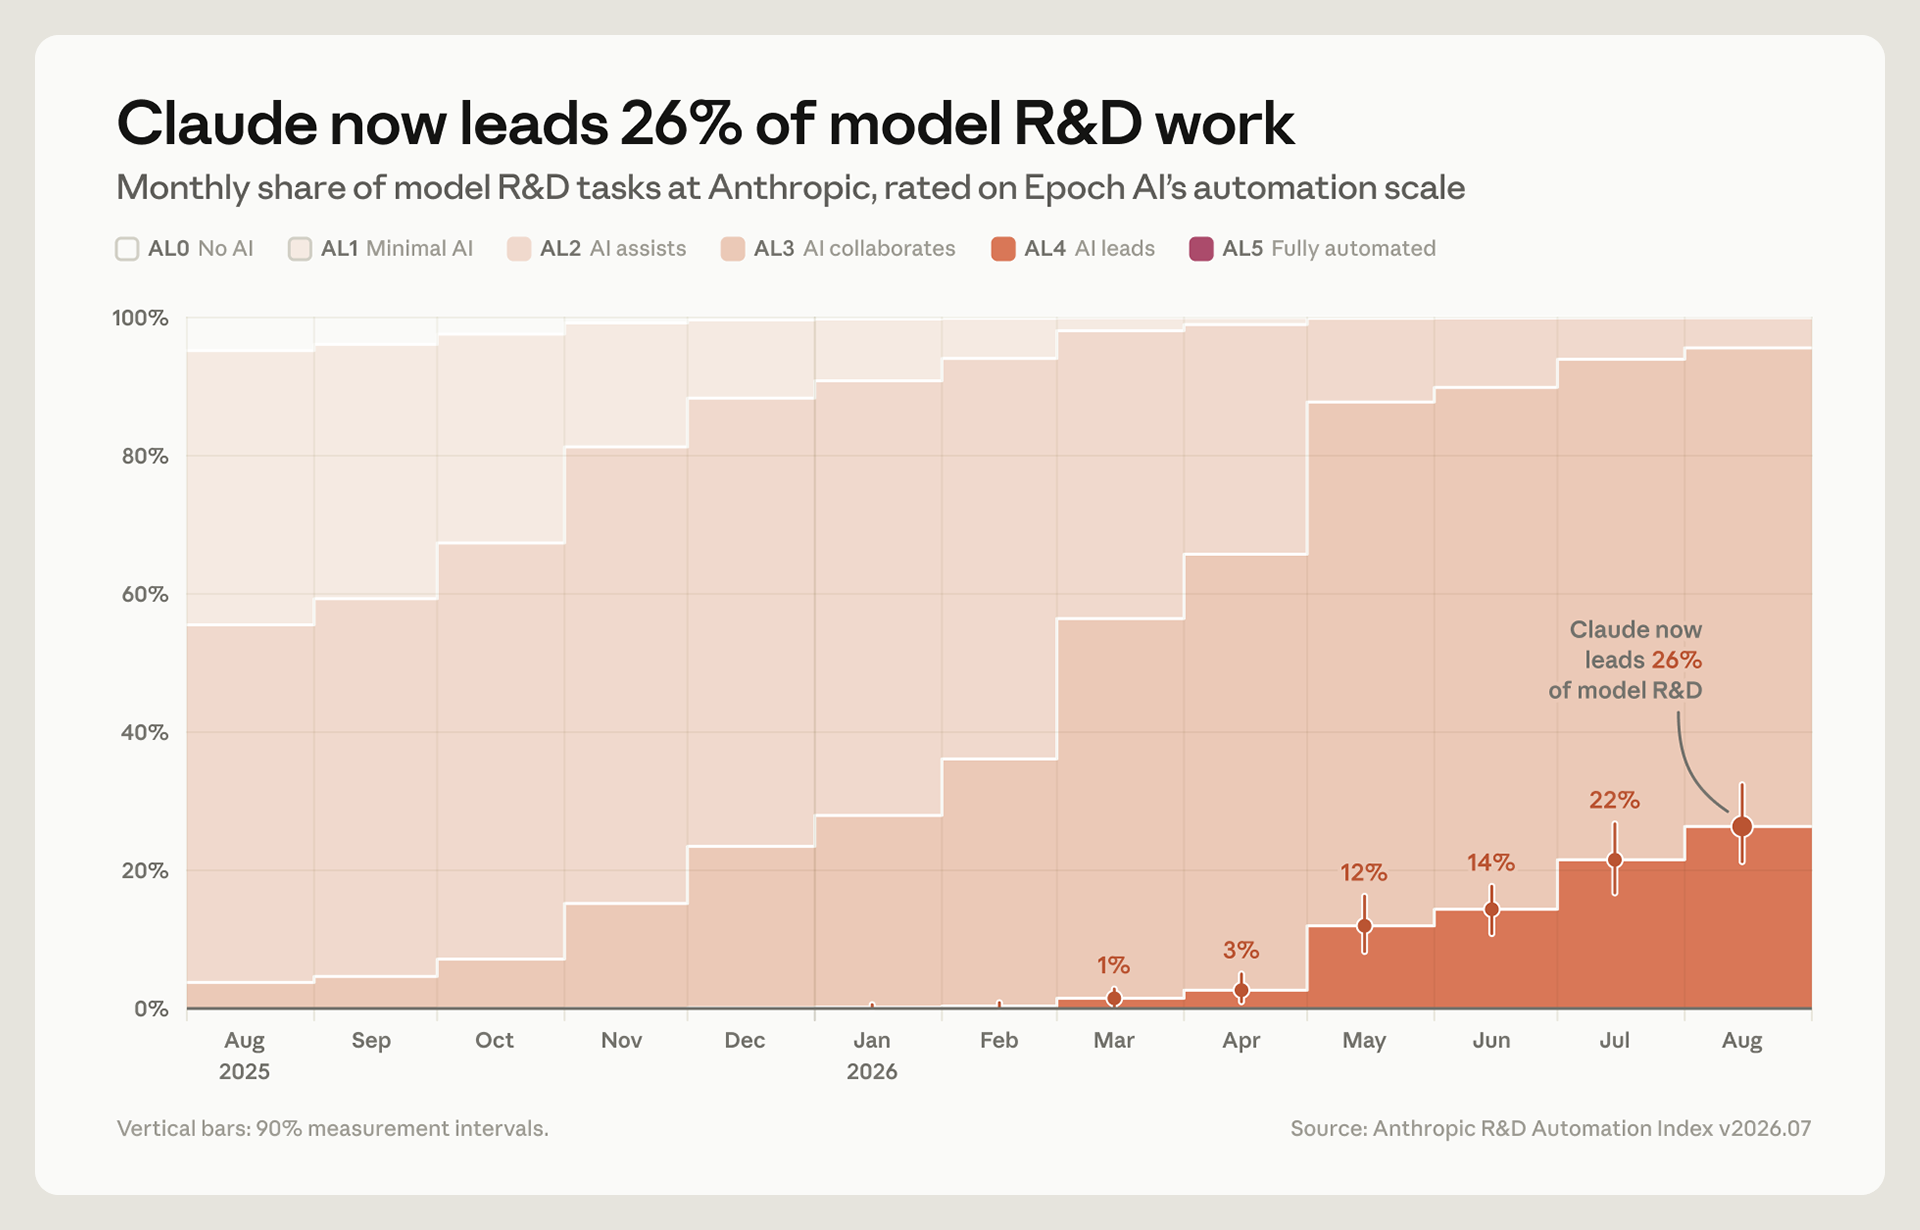
配图:Anthropic Institute 报告中的官方图表「Claude now leads 26% of model R&D work」——横轴为 2025 年 8 月至 2026 年 8 月,橙色区域是 AL4(AI 主导)的占比:2026 年 3 月 1%、4 月 3%、5 月 12%、6 月 14%、7 月 22%、8 月 26%,纵向短线是 90% 测量区间。图片来源:Anthropic(www-cdn.anthropic.com),版权归 Anthropic 所有。
这张图的形状比任何一个绝对数字都更有信息量:真正的转折发生在 2026 年 4 月到 5 月之间——AL4 占比从 3% 跳到 12%,此后逐月抬升。也就是说,让 AI 端到端做完一整件研发任务的这条路,是今年春天才被真正打通的。
把刻度对齐:AL0 到 AL5 到底在说什么
「26%」之所以容易被误读,是因为大多数人默认「AI 参与研发」就是「AI 写代码」。Anthropic 用的这套刻度不是这么分的。
Epoch AI 这套 Automation Level 从 AL0 排到 AL5,衡量的不是「AI 帮了多少忙」,而是人类还在不在关键决策位上。
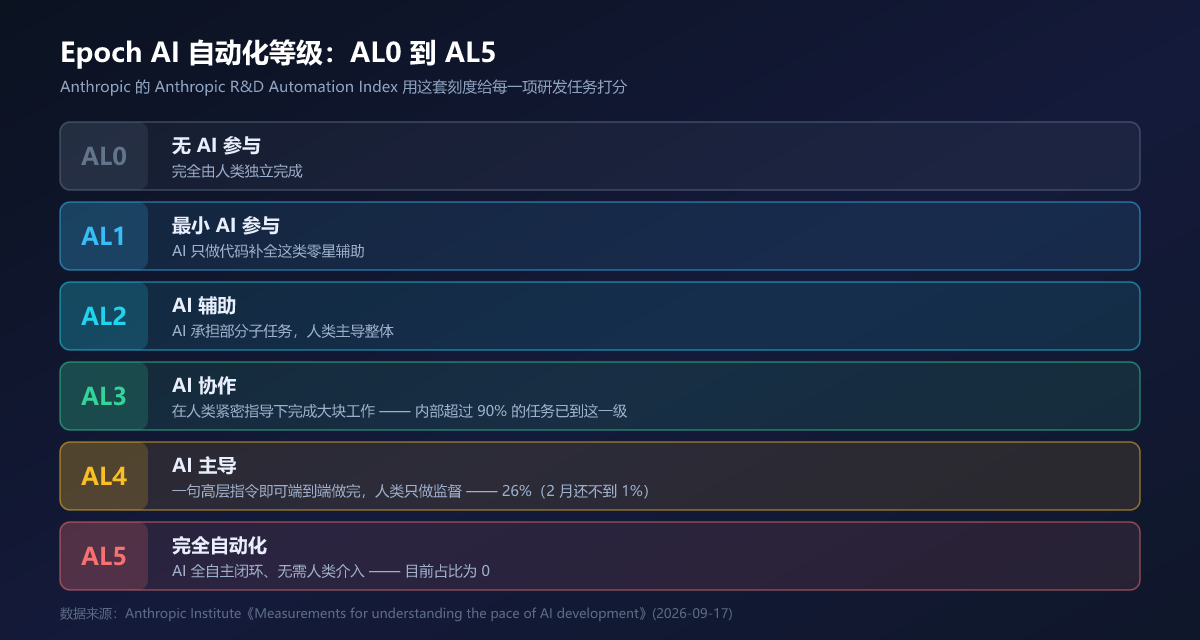
配图:Anthropic 报告引用的 Epoch AI「Automation Level」分级,UU AI Hub 依据报告原文绘制。
按这个刻度,「AI 主导」(AL4)的定义是:给一句高层指令,AI 能端到端完成这项任务的绝大部分,人类只负责监督。而 AL5 才是「AI 完全自主、没有人类在回路里」。
这里有一个必须说清楚的细节:Anthropic 明确表示,在被测量的任何研发子集里,Claude 都没有达到 AL5。 报告原话是,26% 是 AL4,而 AL5 的占比是零。所以「26% 的研发由 AI 主导」并不等于「26% 的研发已经不需要人」——人类仍然在每个 AL4 任务上做监督、审 PR、处理异常边界。
顺带一提,这套刻度的出处 Epoch AI 的原始构想是一份「AI 研发的 ONET 职业分类表」——先穷举一家前沿实验室到底有哪些研发动作,再逐项评估每项动作被自动化到了什么程度,最后聚合。所以 26% 是一个按工作项加权的结果,不是「26% 的工时」也不是「26% 的代码行数」。
3 万个 Agent 被谁看着
30,000 个 Agent 同时在自家系统里改代码、调模型、跑实验,这件事听起来最像风险的部分,Anthropic 也给了账。
报告披露了两套监控机制:在线监控在 Agent 动作执行前实时检查,危险动作直接拦停或改写,覆盖 100% 的动作,通常几秒内完成;离线监控在动作执行后回读记录,专门找「会缓慢发展、可以挽回」的错位迹象,同样覆盖 100% 的动作。
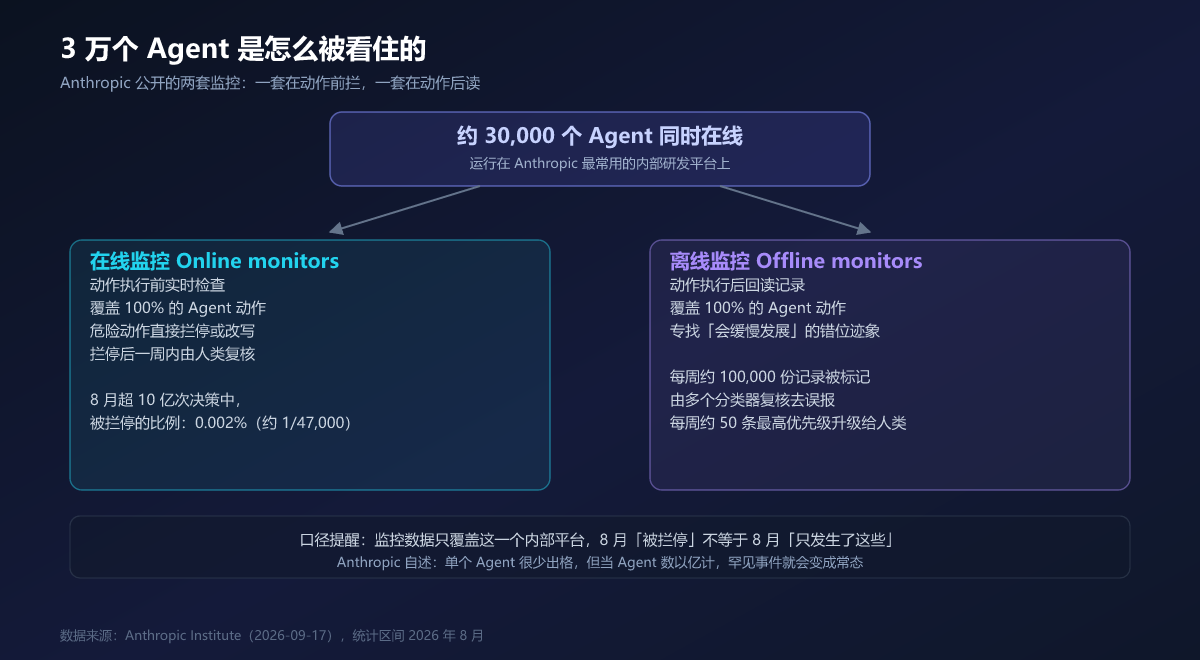
配图:根据 Anthropic Institute 报告第 2 项度量(Measuring oversight of AI agents)绘制的监控链路与指标,UU AI Hub 整理。
具体数字是:8 月总计超过 10 亿次决策里,在线监控拦停的比例约 0.002%(约每 47,000 次拦一次);离线监控每周标记约 100,000 份记录,经多个分类器复核去误报后,每周约 50 条最高优先级的线索升级给人类复核。
Anthropic 自己在报告里给了一句很值得抄下来的判断:「就目前的监控数据看,单个 Agent 很少出格。但当经济里有数百万甚至数十亿个 Agent 在跑,罕见事件也会经常发生。」(原文:individual agents rarely misbehave. But when there are millions or billions of agents operating in the economy, even rare events can happen regularly.)
这里必须补上口径提醒:这些数字只覆盖 Anthropic 的一个内部平台,而且是 Anthropic 自己统计、自己解释的。「拦停率 0.002%」说明的是监控系统的动作,不能反推「8 月只发生了这些」。官方也承认这一点,并说解决办法是引入外部第三方评估员——给它们和内部风险团队同等级别的系统与数据访问权限,让它们去验证安全实践、报告事件、监控这些指标。
从内部度量到外部产品:Claude Code 也换了骨架
度量报告发布的前后,Claude Code 的 Projects 功能被彻底重构了。
旧的 Projects 本质上是个「放提示词和参考文件的静态文件夹」——聊几轮上下文就乱。新版把它改成了一个以对话驱动的协作中心,架构核心是一个叫 Coordinator(协调器) 的大脑。
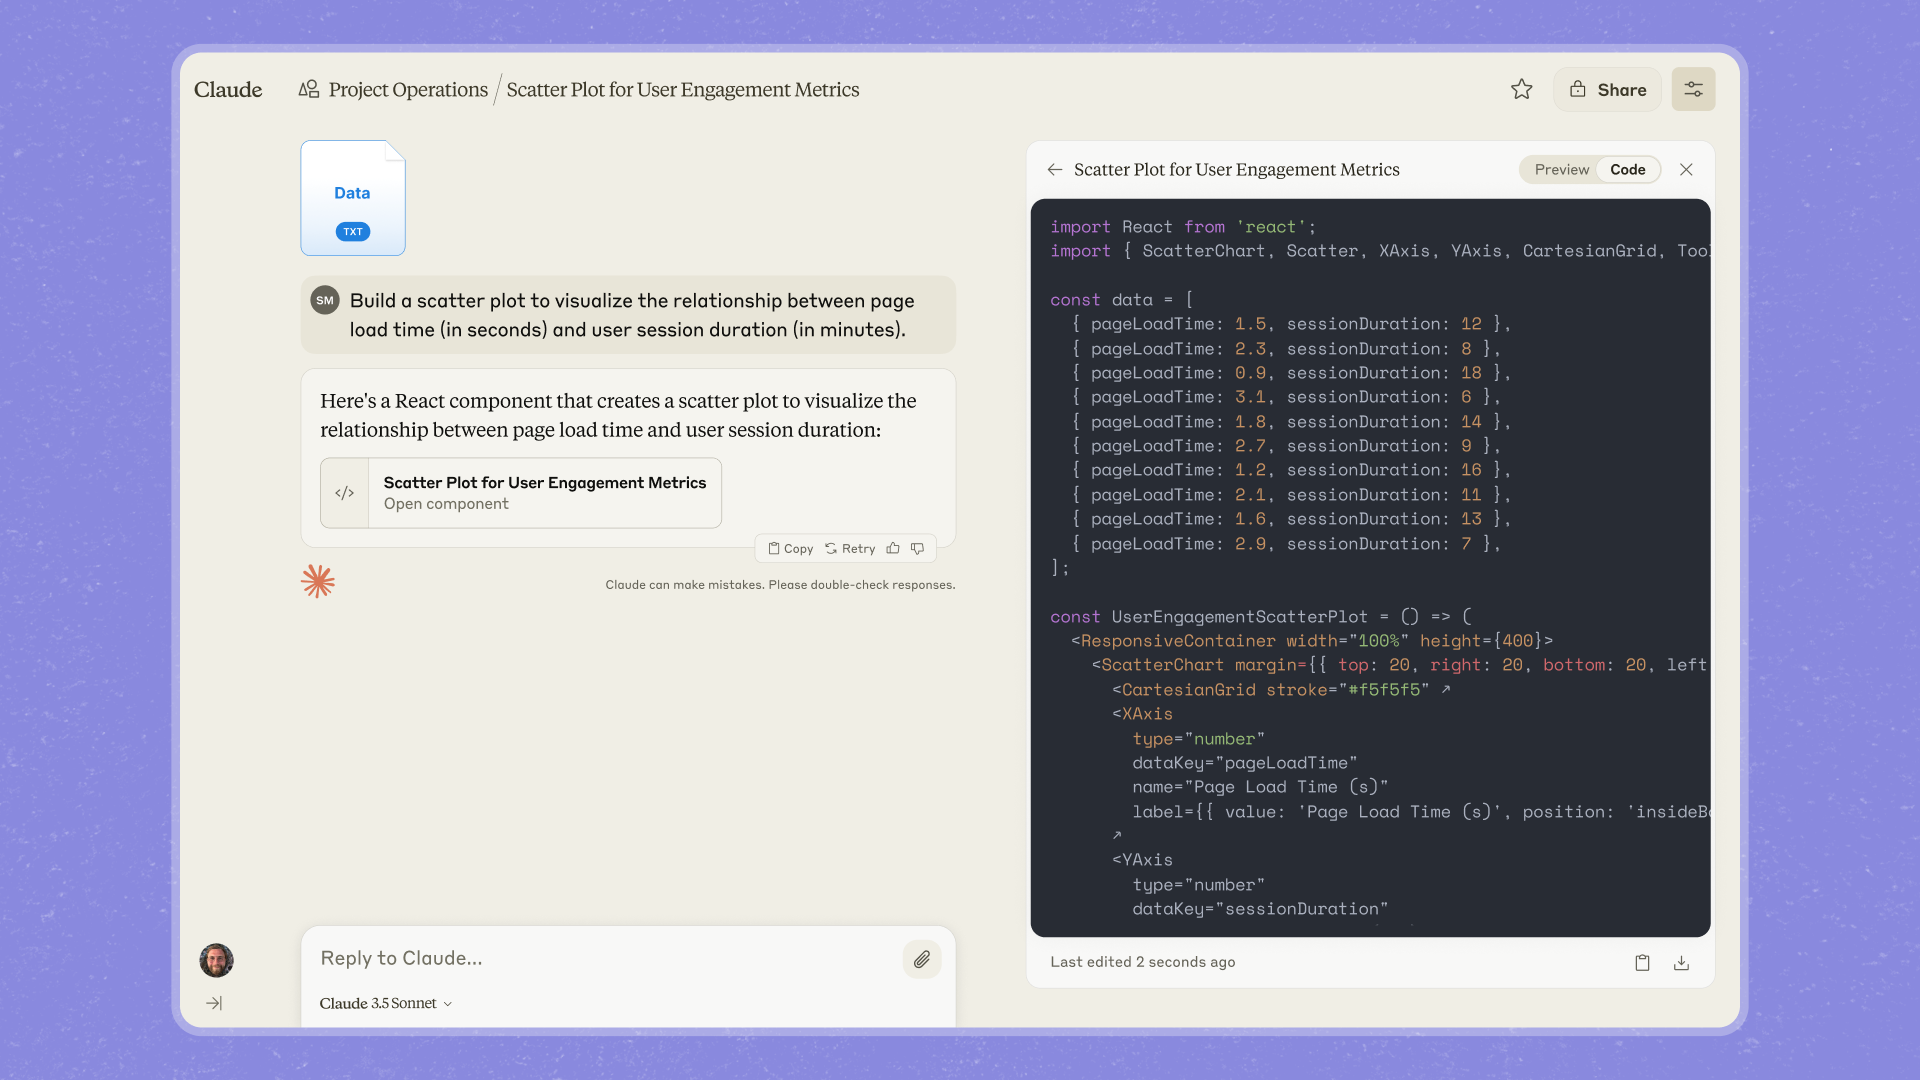
配图:Anthropic 官方博客《Collaborate with Claude on Projects》中的界面截图——左侧是项目主对话,右侧是 Claude 生成的可运行组件与代码,底部提示「Reply to Claude…」。图片来源:Anthropic(cdn.sanity.io),版权归 Anthropic 所有。
工作方式是:你在主对话里下一个高层目标(官方的例子是「把整个鉴权模块重构成 OAuth 2.0 并补齐自动化测试」),协调器自动把这件事拆成多个子任务,派给并行的工作线程。每个工作线程是一个跑在云端独立环境里的 Claude Code 实例,持有完全隔离的代码副本,各自拉一条独立的 Git 分支,在后台同时推进不同模块的编码与单测。干完之后,工作线程自己提交代码、生成 PR。
和 3 万个 Agent 的内部系统相比,这套东西显然是同一个思路的产品化降级版——把内部踩过的坑(上下文对齐、并发调度、依赖跟踪)打包成了界面。
「共享记忆」解决的是最贵的那部分
多 Agent 并行最大的隐性成本不是算力,是信息损耗:每个 Agent 各写各的,上下文靠人肉在会话之间搬运,粘来粘去,token 消耗巨大,速度还不一定快。
新版 Projects 的解法是共享记忆:所有分支线程在执行过程中沉淀的技术规范、架构决策与团队偏好,会实时同步回一个共享记忆。官方举的例子很具体——Claude 现在能记住「系统发布时间改到了周五」「导出功能为什么被取消」「访问账单服务之前需要联系谁」。
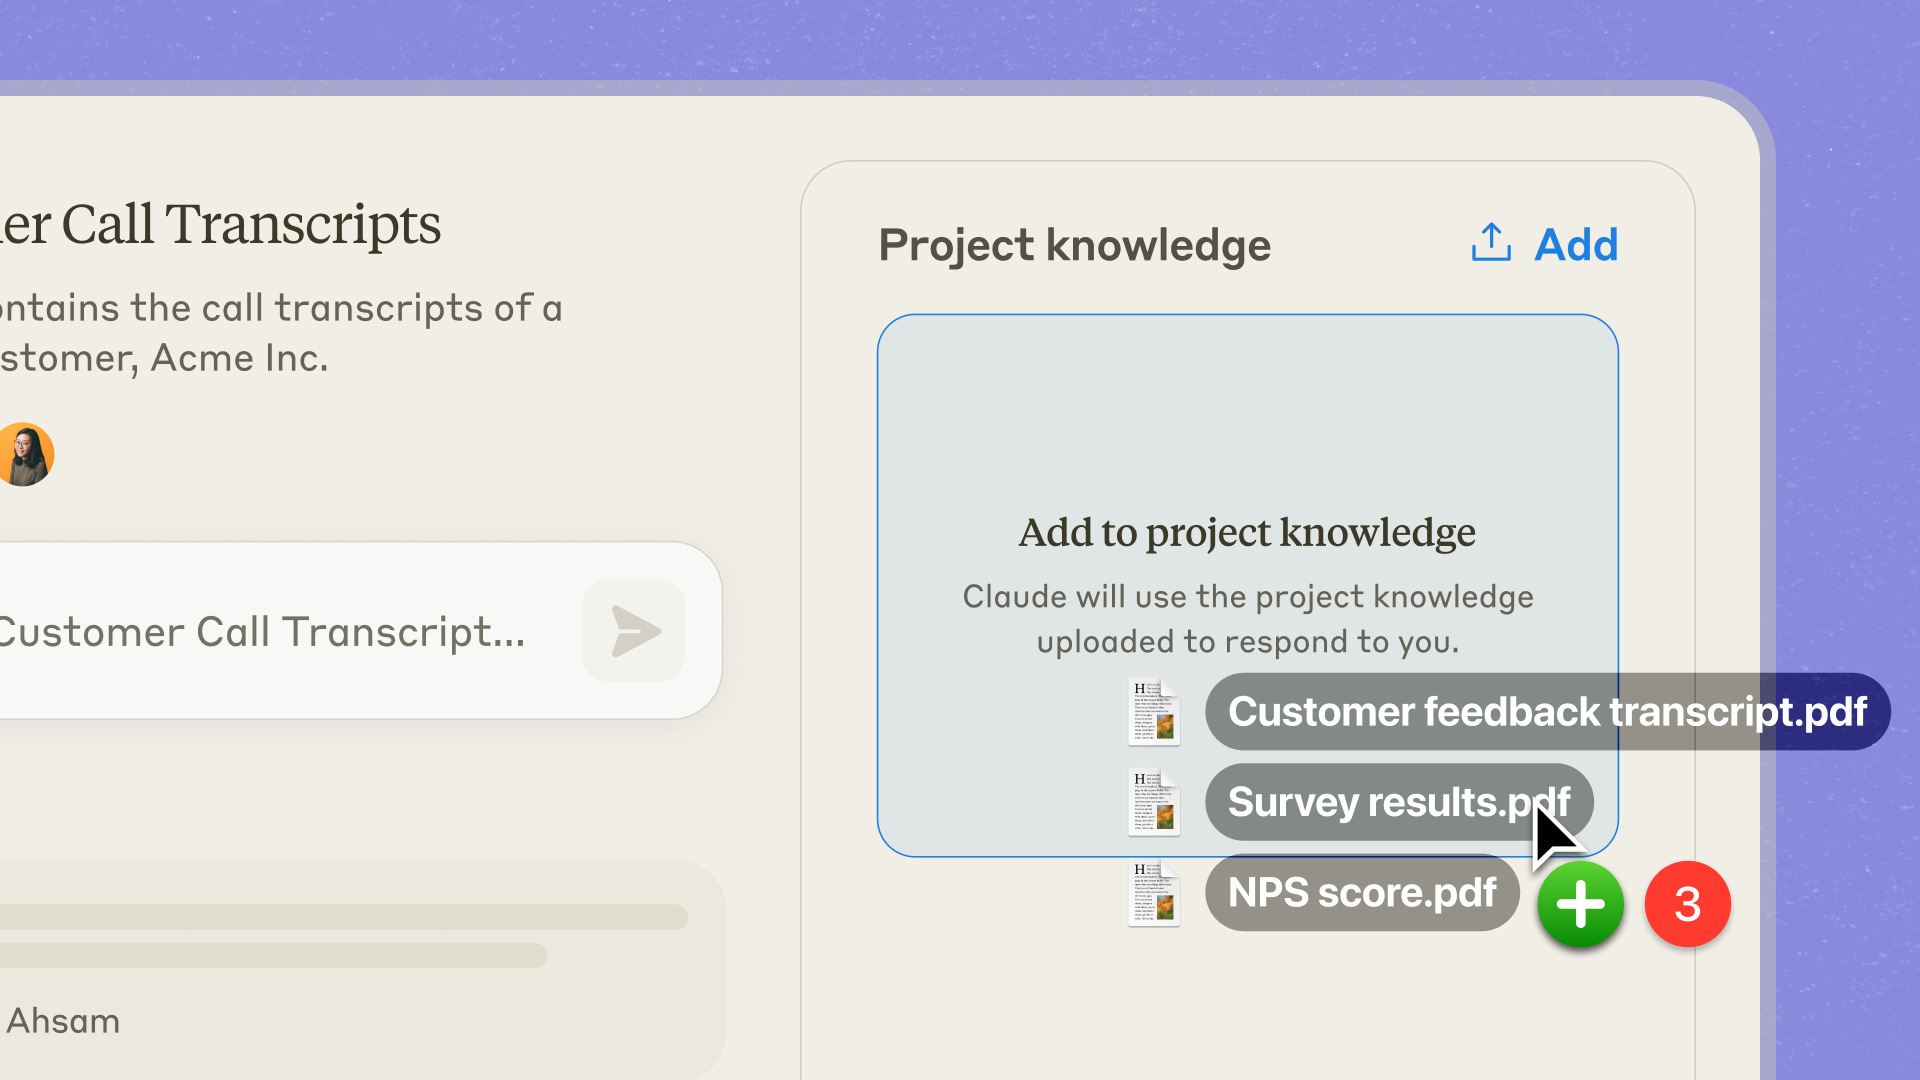
配图:官方博客中展示的 Project knowledge 面板——把客户通话记录、调研结果、NPS 分数等文件挂进项目知识库后,项目内的所有线程共用同一份上下文。图片来源:Anthropic(cdn.sanity.io),版权归 Anthropic 所有。
过程支持完全异步:下完指令合上电脑就行,也可以用移动端随时查看各线程进度、微调指令。
但官方也没藏着代价——多 Agent 肯定不便宜,报告与官方文档都提醒用户盯着自己的用量。另外,多分支并行不可避免会撞上 Git 合并冲突,协调器能做的是理清依赖关系、告诉你先合哪条分支,最终收口仍然要靠人。
Projects 目前是 beta:第一批只开放给部分 Claude Pro 和 Max 订阅用户里的云会话项目,接下来一周逐步放量到 Team、Enterprise 和 Cowork。
同一周,Cursor 也在做同一件事
这不是 Anthropic 一家的判断。
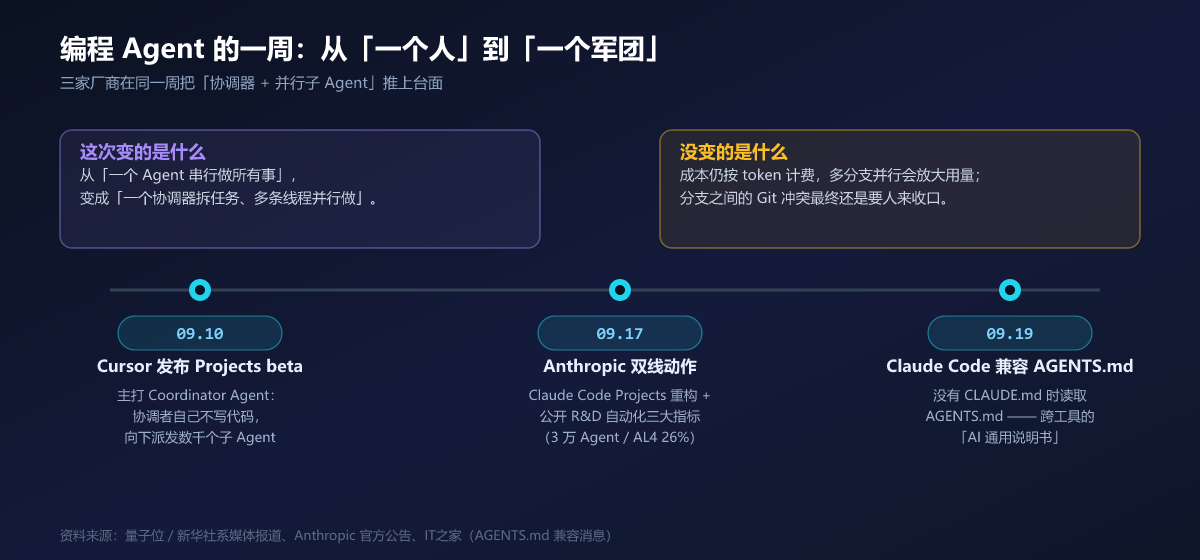
配图:UU AI Hub 依据公开报道整理的时间线(Cursor 2026-09-10、Anthropic 2026-09-17、Claude Code 兼容 AGENTS.md 2026-09-19)。
9 月 10 日,Cursor 发布了 Projects beta,主打同样是 Coordinator Agent——一个自己不写代码、只负责向下派发数千个子 Agent 的协调者,项目上下文在云端共享,合上笔记本任务照跑。
9 月 17 日,Anthropic 双线同时动作:Claude Code Projects 重构 + 三大指标公开。
9 月 19 日,据 IT之家报道,Claude Code 宣布支持读取 AGENTS.md——在项目里没有 CLAUDE.md 的时候会去读 AGENTS.md。AGENTS.md 是个正在成形的「AI 通用说明书」标准,Codex、Cursor 等工具都已采纳。一份说明书被多个 Agent 工具读取,意味着团队不用再维护多套指令文件。
把这三件事放在一起看,编程工具这一层的竞争焦点已经不在「补全得准不准」,而在任务怎么拆、上下文怎么共享、多个 Agent 谁听谁的。
这份报告的三道裂缝
一篇官方自述,读的时候至少要把下面三件事一起装进去。
一、26% 是自评,裁判也是自己。 Anthropic 在附录里直接承认了这个方法论问题:衡量「AI 干的研发」时,他们用自家的模型去评估自家的系统,这意味着「裁判模型」可能犯下和被检查模型同一类的错误。官方给出的补救方向是让第三方验证,或者用其他开发商的模型来评——但这两条目前都还在「计划中」。
二、6% 是单周快照,不是全年均值。 算力分配那一项的统计区间是 7 月 13 日到 7 月 20 日,一周。把它当成常态会有偏差。
三、时间点很微妙。 这份报告的发布时间是 9 月 17 日,而 Anthropic CEO Dario Amodei 呼吁「协同放慢前沿研发」的文章《We Must Pace the Frontier》发布于上周末(本目录 9 月 13 日的博客里有完整拆解)。批评者的读法是:先大声呼吁减速,再公开一份「我们已经把 26% 的研发交给 AI」的成绩单——减速叙事和竞争位置可以同时被照顾。国内媒体在这波报道里也直接点了这一点,把它和此前关于「安全焦虑被用于商业叙事」的争议放在一起讨论。这些指控本身未经独立证实,但作为读者,知道发布方在叙事里的位置是必要的。
对普通开发者意味着什么
把上面这些拆成能用的推论,大概有四条。
第一,「写代码」这个动作确实在贬值,「拆解和调度」在升值。 报告里的角色变化说得很直白:以往一个中级工程师在终端里一次只能死磕一个特性;现在的形态是,你带着一组 Claude Code 同时开工,你的产出从「代码行」变成「任务分解表 + PR 审核意见」。
第二,Agent 编排的规模上限暂时由两个东西卡住——成本和 Git。 官方自己说多 Agent 不便宜,也承认分支冲突要人来收口。在成本没有数量级下降之前,把「5 个并行线程」和「5000 个并行线程」当成同一件事会亏得很惨。
第三,如果你在做 Agent 产品,这份报告里最有价值的是「监管指标」那一节。 覆盖(多少比例的动作经过监控)、复核延迟(多久被看到)、升级率(多少被拦或标记)——这三个是可以直接抄的工程指标,比「我们有护栏」这种说法有用得多。
第四,等第三方评估落地再判断。 官方承诺给外部评估员和内部风险团队同等的系统与数据访问权限。这条承诺如果兑现,是这套叙事从「自证清白」变成「可被检查」的关键一步;如果不兑现,26% 和 6% 就仍然只是一家公司的自述。
参考资料
- Anthropic Institute,《Measurements for understanding the pace of AI development inside frontier labs》,2026-09-17:https://www.anthropic.com/institute/measuring-pace-of-ai-development
- Anthropic 官方博客,《Collaborate with Claude on Projects》:https://www.anthropic.com/news/projects
- SiliconANGLE,《Anthropic details practical metrics to help monitor the speed of AI development》,2026-09-17
- Gate News,《Anthropic Shares 3 Metrics to Monitor AI Development Pace》,2026-09-18
- 量子位,《Claude Code 大重构!内部 3 万 Agent 管理技术免费开放》,2026-09-18(经 cnyes、腾讯新闻、搜狐转载)
- IT之家,《Claude Code 宣布支持 AI 通用说明书 AGENTS.md》,2026-09-19(经博客园《AI 技术日报 - 2026-09-19》转述)
- Epoch AI,Automation Level 分级方法(Anthropic 报告附录引用)
本文中所有价格、比例与时间口径均来自上述公开来源;「26%」「0.002%」等数字为 Anthropic 自报口径,本文已在正文中标注其统计范围与局限。