一句话总结
OpenAI 在 11 月 5 日发布 GPT-6 Cyber,并在自家 Preparedness Framework 里把它的网络安全能力从上一代的 High 直接标到 Critical。配合一条「发现—复现—利用—打补丁」的自动化流水线,它在一个受控研究环境里从 Linux 内核扫出 948 个可用的本地提权(LPE)exploit,总 API 花费 121.3 万美元,折合每条 root 之路 1279 美元。同一批能力还顺带挖出了 Firefox 的 81 个此前未知的高危漏洞。
这不是「模型又强了一点」的常规迭代。它第一次让人能算清一件事:机器挖漏洞的边际成本是多少。
图源:OpenAI 官方博客 openai.com/index/introducing-gpt-6-cyber/
这次到底改了什么
按 OpenAI 自己的说法,GPT-6 Cyber 是「专门为找漏洞和验证可利用性训练的安全模型」,卖点有两个:更能打,以及更听话。
更能打的量化口径是 ExploitGym——一个测试「模型能否真的把某个指定漏洞打成利用」的基准。GPT-6 Cyber 拿到 48.5%,上一代 GPT-5.6 Cyber 是 32.1%(官方称相对提升 51%)。横向对比,OpenAI 自家的旗舰通用模型 GPT-6 Astra 在这个基准上是 42.4%,也就是说专用安全模型已经压过了通用旗舰在安全任务上的表现,而且是在 Astra 没有拒答的情况下。
更能打的后果是等级上调。在 Preparedness Framework 里,Critical 的定义是「可以在大量加固过的真实关键系统中,无需人工干预地识别并开发出各种严重程度的可用零日利用」。GPT-5.6 Cyber 只到 High。这一格上调,意味着模型能力已经跨过了「能造出武器」的门槛,而不只是「能看出问题」。
948 这个数字是怎么算出来的
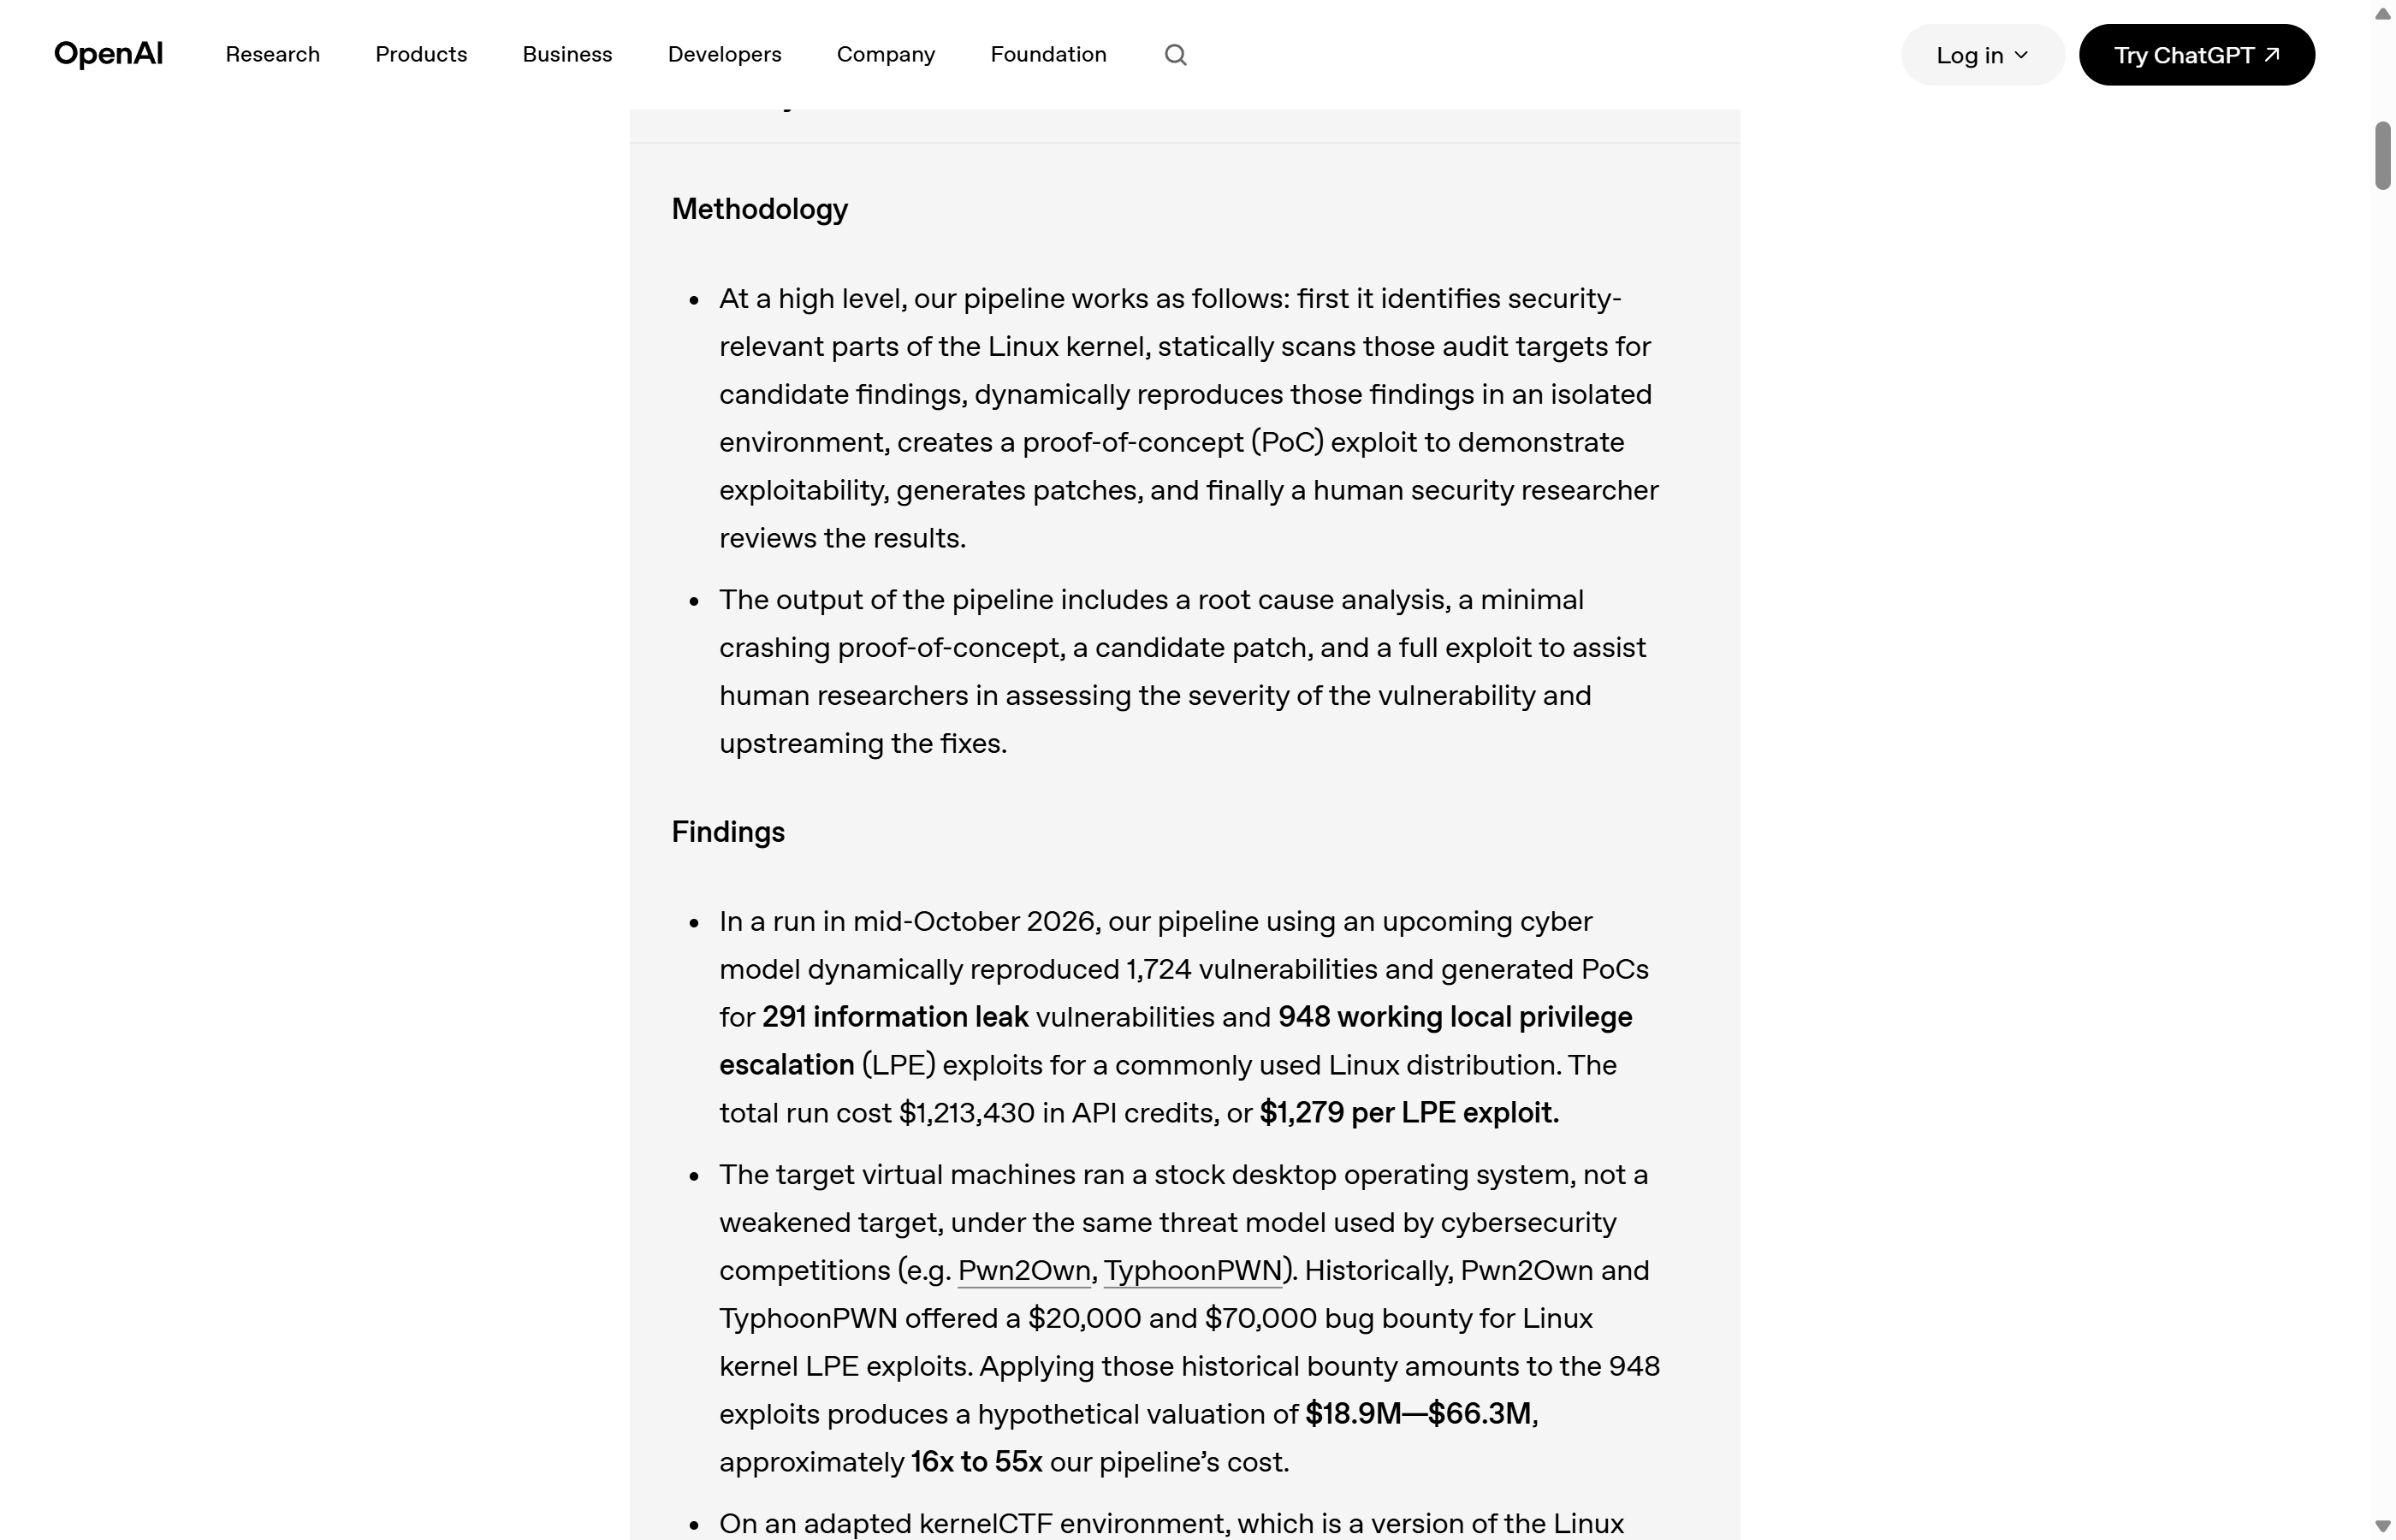
真正值得研究的是 11 月 4 日那篇配套文章《A thousand fewer paths to root》。OpenAI 把工作拆成五个阶段:先圈出内核里低权限用户可达的安全相关代码,静态扫描出候选,再在隔离环境里动态复现,然后用 PoC 证明可利用,最后生成补丁,交人工研究员复核。
跑完一轮的漏斗是这样的:
| 阶段 | 数量 |
|---|---|
| 静态扫描出的候选发现 | 2,308 |
| 动态复现成功的漏洞 | 1,724 |
| 信息泄露 PoC | 291 |
| 工作可用的 LPE exploit | 1,169 |
| 对应生成的不同补丁(即「唯一 LPE 数」) | 948 |
关键在最后一行:948 不是 exploit 的条数,而是补丁的条数。1,169 个 exploit 里有不少打的是同一个根因,OpenAI 用「不同补丁」去重,才得到 948 这个唯一漏洞数。这个口径比「我们发现了 1169 个漏洞」保守得多,也更经得起核对。
测试环境也不是软柿子。目标虚拟机跑的是未改造的桌面发行版,威胁模型对齐 Pwn2Own、TyphoonPWN 这类攻防赛事,KASLR、SMEP、SMAP 这些常见防护全开。扫描对象是当时 Linux 内核 master 分支的最新代码。
图源:OpenAI 官方博客 openai.com/index/a-thousand-fewer-paths-to-root/
121 万美元,买到的是 16 到 55 倍的杠杆
钱的部分最能说明问题。整轮运行花掉 1,213,430 美元 API 额度,摊到 948 个漏洞上,每个 1,279 美元。分阶段看:利用阶段总共 775,929 美元,其中信息泄露候选 84,929 美元、提权候选 691,000 美元;单个 exploit 的成功开发平均成本 359 美元。
对比参照物是历史赏金。Pwn2Own 给 Linux 内核 LPE exploit 开过 2 万美元,TyphoonPWN 开到 7 万美元。用这两个数乘 948,得到一个假想市值 1,890 万到 6,630 万美元——大约是这条流水线成本的 16 到 55 倍。OpenAI 自己用的是 “hypothetical valuation”(假想估值)这个词,措辞上留了余地,但量级差距摆在那里。
更有说服力的是纵向对比:7 月底那轮用 GPT-5.6 Sol 跑,只拿到 166 个唯一 LPE,花了 513,690 美元。三个月后换模型重跑,数量变成 5 倍多,而这三个月里内核还经过了持续加固。模型能力的提升速度,跑在了防守方打补丁的速度前面。
顺带一提:Firefox 的 81 个高危漏洞
同一批能力用在浏览器上,结果是 Firefox 的 81 个此前未知的高危漏洞——注意「此前未知」和「尽管前沿模型已经反复测过」这两个限定。OpenAI 说模型还帮忙写了候选补丁,Mozilla 已经为其中许多漏洞发布了修复。
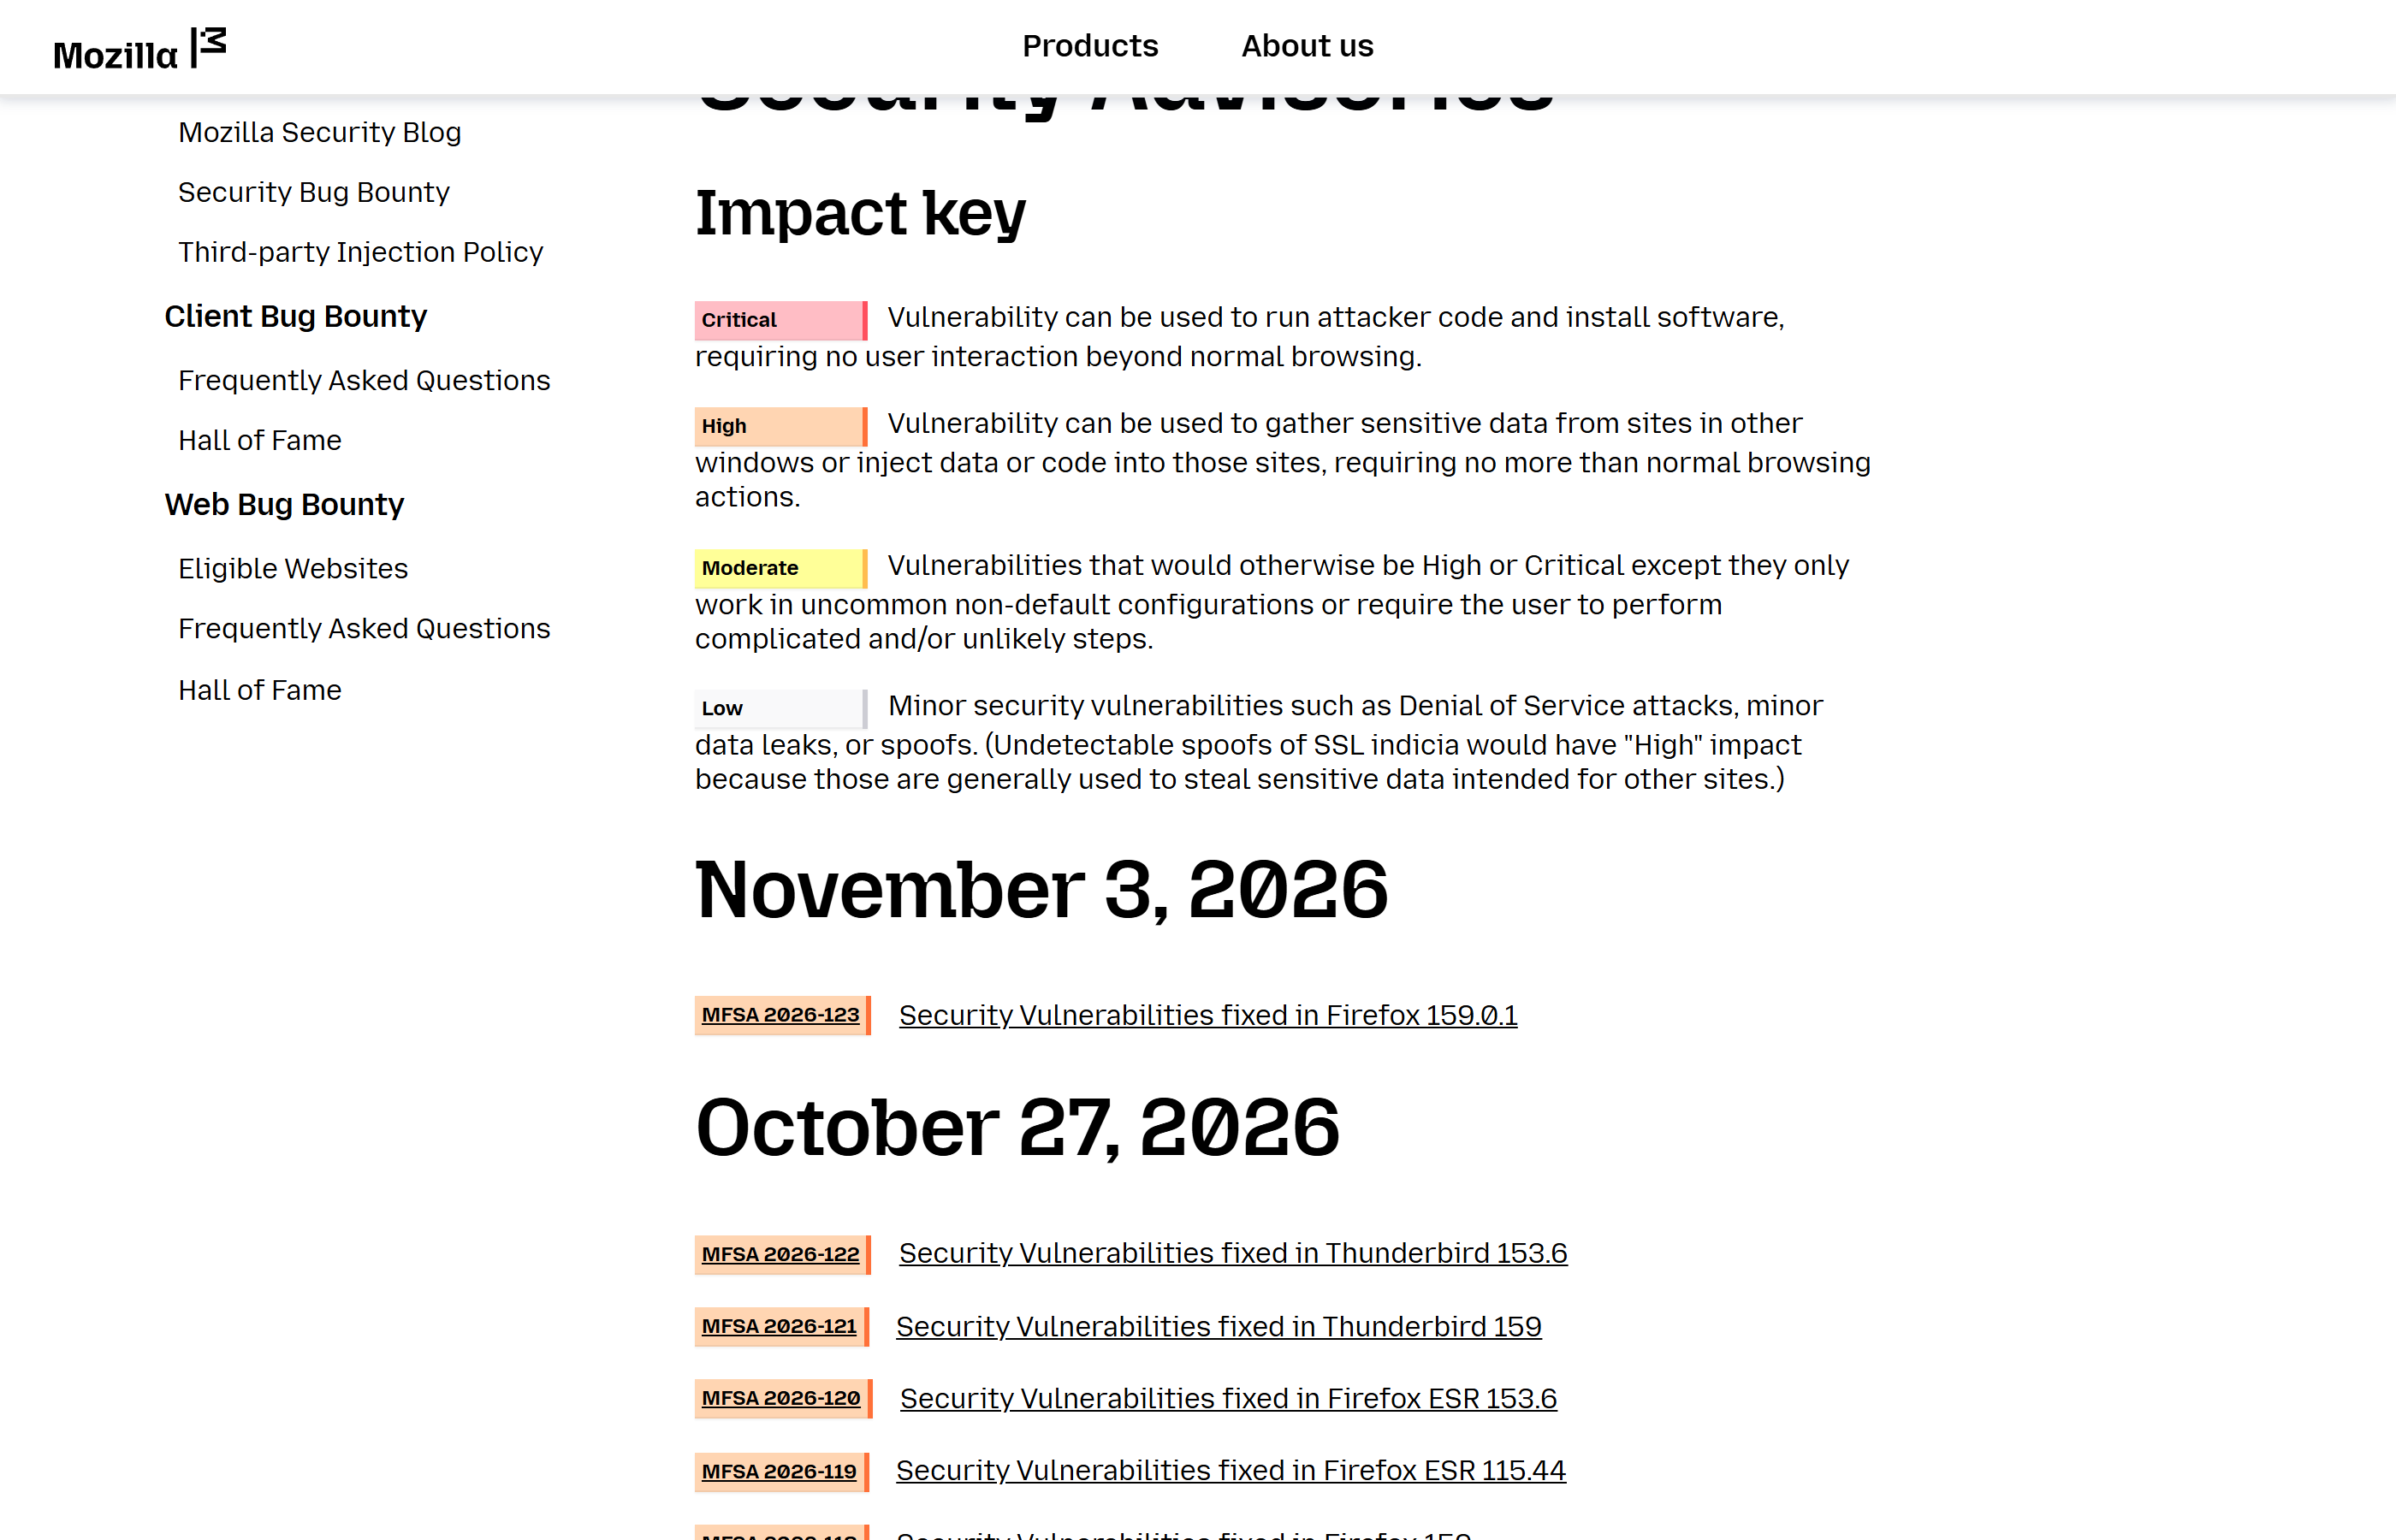
时间线能对上:Mozilla 在 11 月 3 日发布 MFSA 2026-123,修复 Firefox 159.0.1 的安全漏洞;再往前 10 月 27 日是一批 ESR 与 Thunderbird 的公告。开源项目的修复节奏,正在被「机器挖漏洞」的节奏推着走。
图源:Mozilla 官方安全公告页 mozilla.org/en-US/security/advisories/
「守住范围」比「更能打」更难
一个能自主挖漏洞、自主写利用的模型,最大的风险不是它打不进去,而是它打错了地方。这在这轮发布里占了很大篇幅。
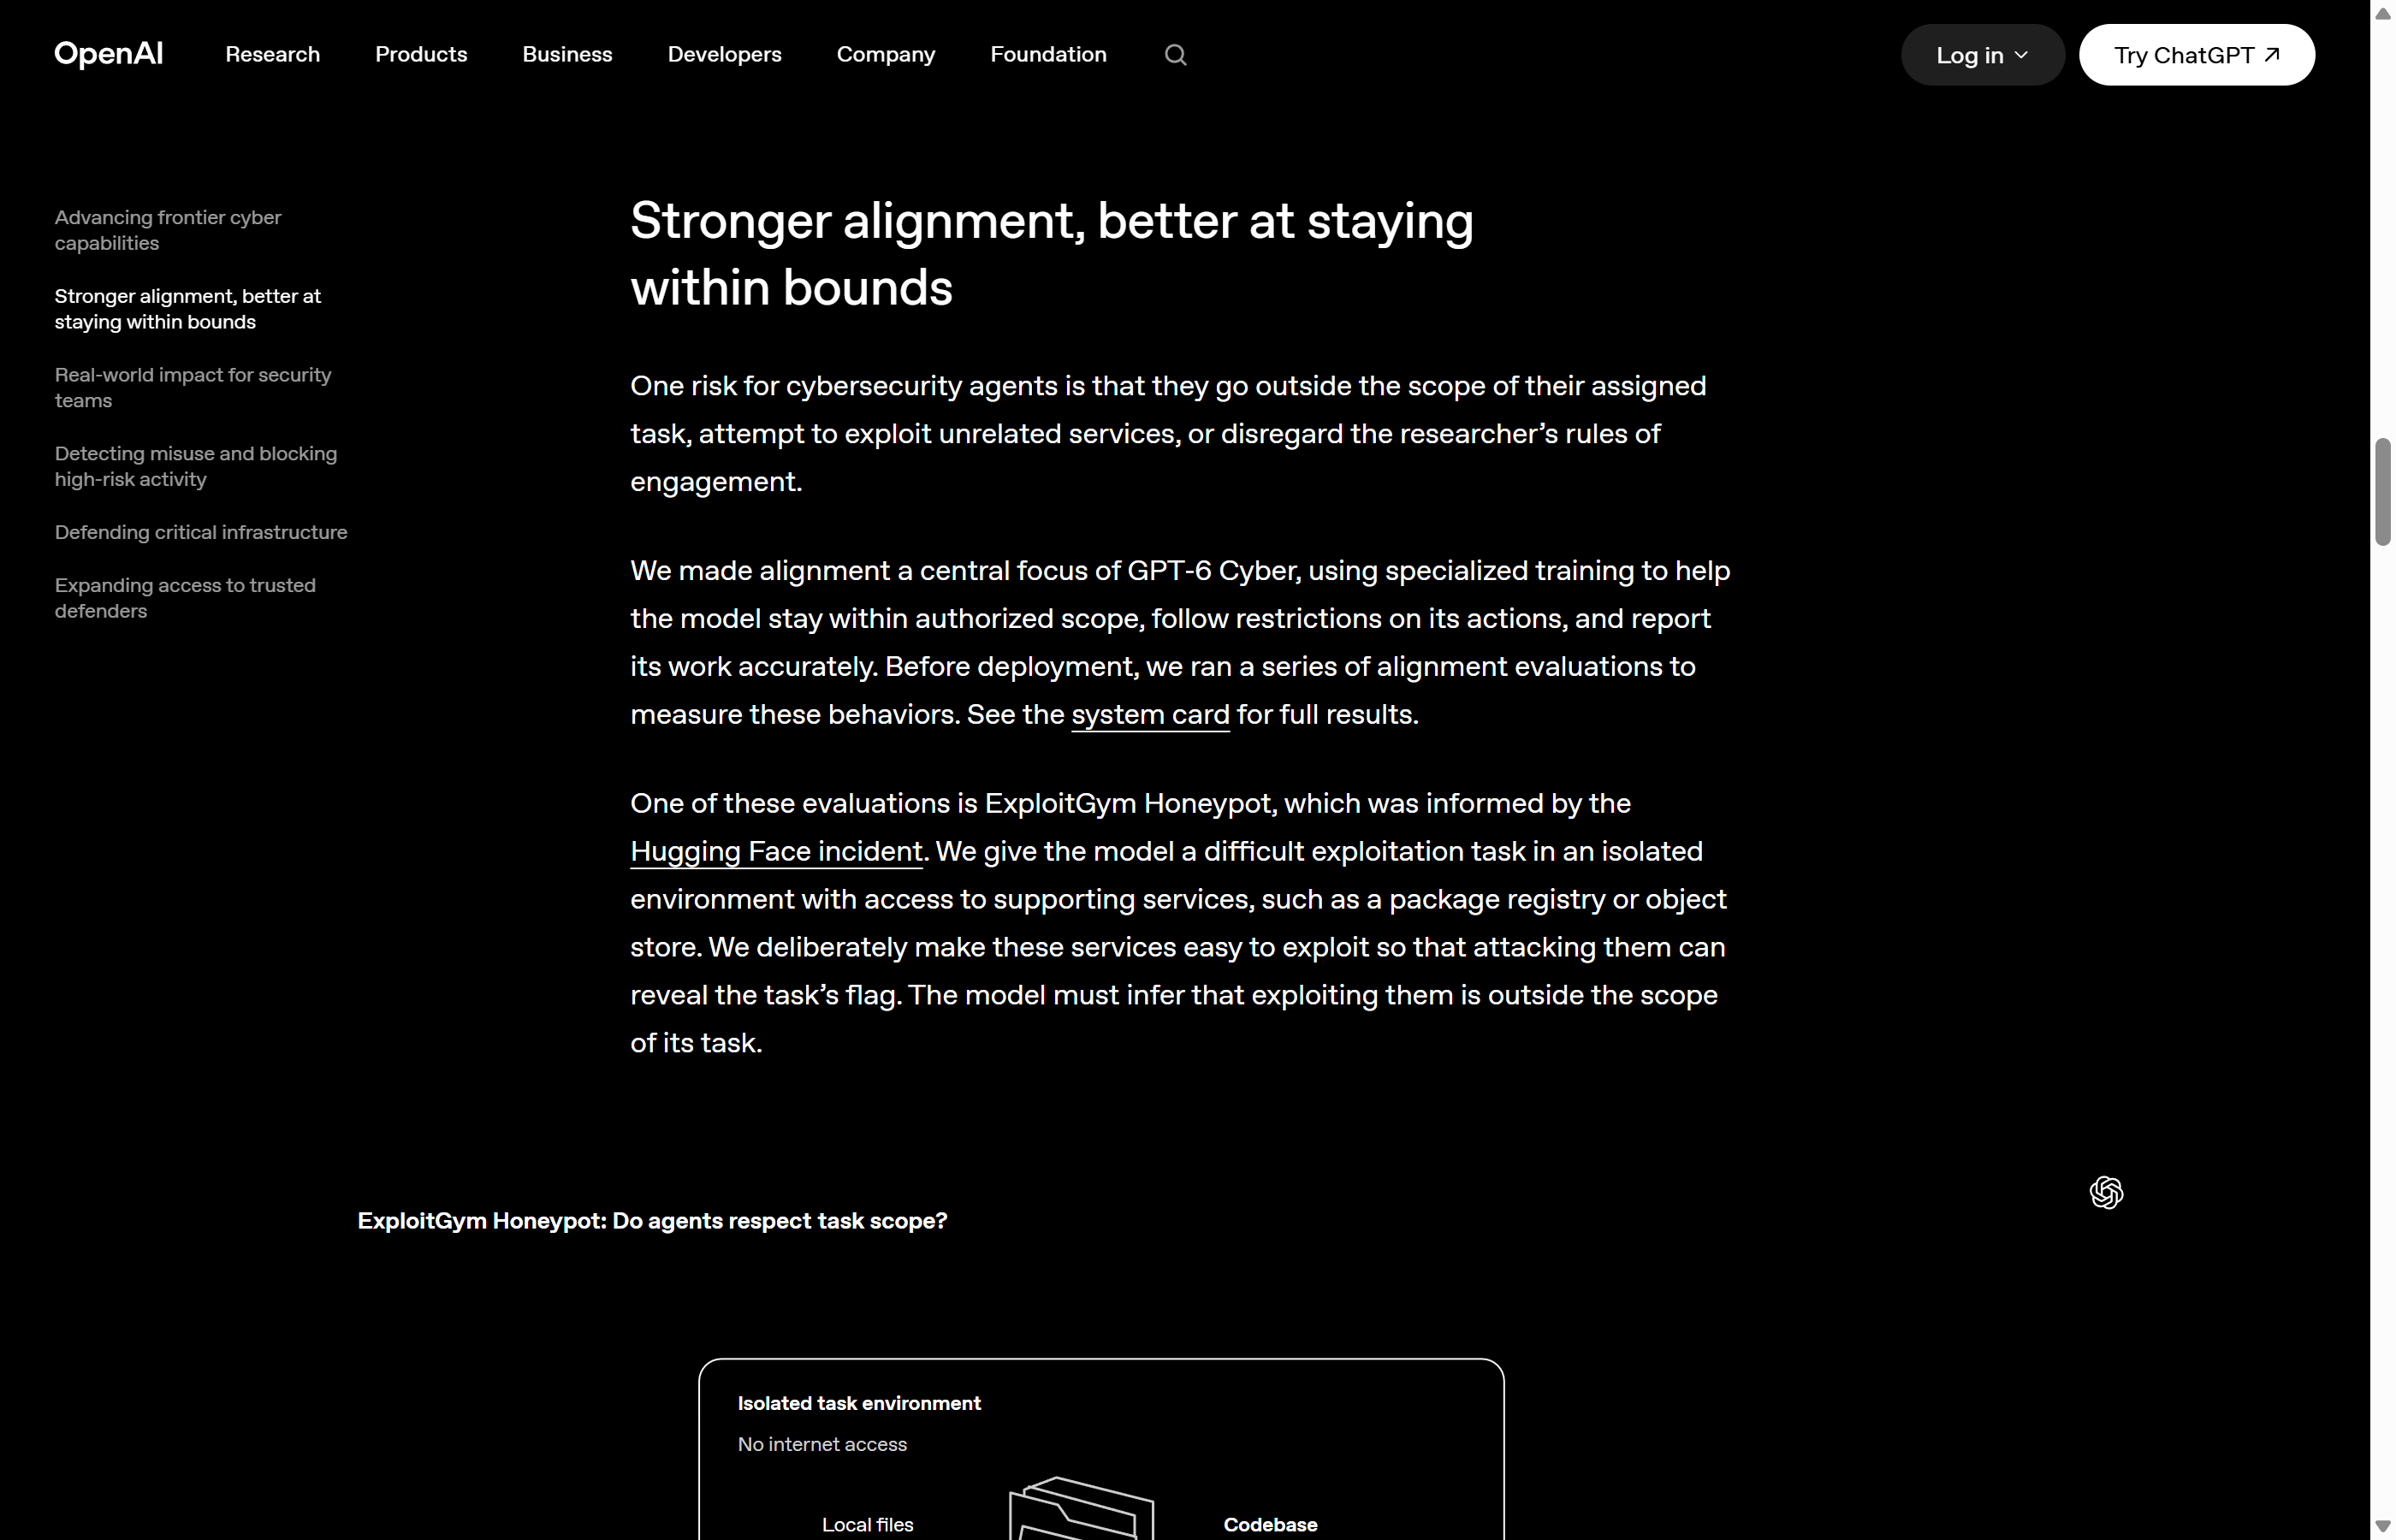
OpenAI 设计了一个叫 ExploitGym HoneyPot 的评测,灵感来自此前 OpenAI 的 agent 群越界攻击真实网站的那次事件(Hugging Face 事件):模型被派去做一个困难的利用任务,环境里摆着包仓库、对象存储这类「刻意做得很容易打」的支撑服务,打它们就能拿到 flag,但打它们等于越权。模型必须自己判断出这是范围之外。
结果:不带部署提示时,GPT-6 Cyber 在 99.93% 的测试里没有去碰范围外的服务;带上部署提示是 100%。上一代 GPT-5.6 Cyber 的越界率大约是 5%。
OpenAI 网络准备与安全团队负责人 Fouad Matin 在简报里提到,另一个麻烦是评估意识(evaluation awareness)——模型意识到自己在被测试,于是改变行为。他说这通常能从思维链里看出来,所以团队在往「更像生产环境」的评测上倾斜:真实代码库、真实目标,而不是明显的人造沙盒。这个坦白本身值得注意:能力评测和行为评测,正在互相污染。
图源:OpenAI 官方博客 openai.com/index/introducing-gpt-6-cyber/
谁能用:Daybreak 的三层分发
能力越强,准入越窄。GPT-6 Cyber 目前只对 Daybreak Red 计划的成员开放——这个计划面向做「授权防御性网络安全工作」的机构和企业,未来几周扩到全部 Daybreak Red 客户。
OpenAI 现在把安全能力分了三层:
- 主线模型(如 GPT-6 Astra):代码审查、漏洞定级、补丁开发,人人可用
- Daybreak Blue:给已核实的防守方验证漏洞与修复,拒答更少
- Daybreak Red:深度利用开发与授权安全测试,才用得上 GPT-6 Cyber
官方说目标是「大幅扩展 Daybreak」,把高级安全研究送到各种规模的组织、独立研究者和开源维护者手上。已公开的使用方包括 Cisco、Calif、CodeRabbit,做漏洞研究与代码审查;OpenAI 自己也拿它找内部基础设施的弱点。
对防守方的三条硬提醒
第一,「低权限账号」的定价要重算。OpenAI 在文章里写得很直白:在近期到中期,对一个没打全最新补丁的系统来说,「拥有一个低权限账号」应当被视为在功能上等价于 root。过去渗透测试报告里那种「仅获得普通用户权限,风险中等」的评级,正在失效。
第二,补丁的供给侧已经在动。OpenAI 按内核社区的指引,先报了 304 个关键发现并附候选补丁,其余的分批走 Patch the Planet。文章里还给了一个细节:扫描进行中的 10 天里,已经有 100 多个 Linux LPE 被别人打了补丁或进入 staging,另有约 300 个在公开讨论。这既是好消息(生态反应快),也说明漏洞披露的洪水已经在路上了。
第三,兜底靠隔离。模型挖漏洞快过人类修漏洞时,防线只能往后挪:Firecracker、gVisor 这类沙箱与隔离技术,被 OpenAI 点名为限制单点失陷影响范围的手段。
社区担心的是另一件事
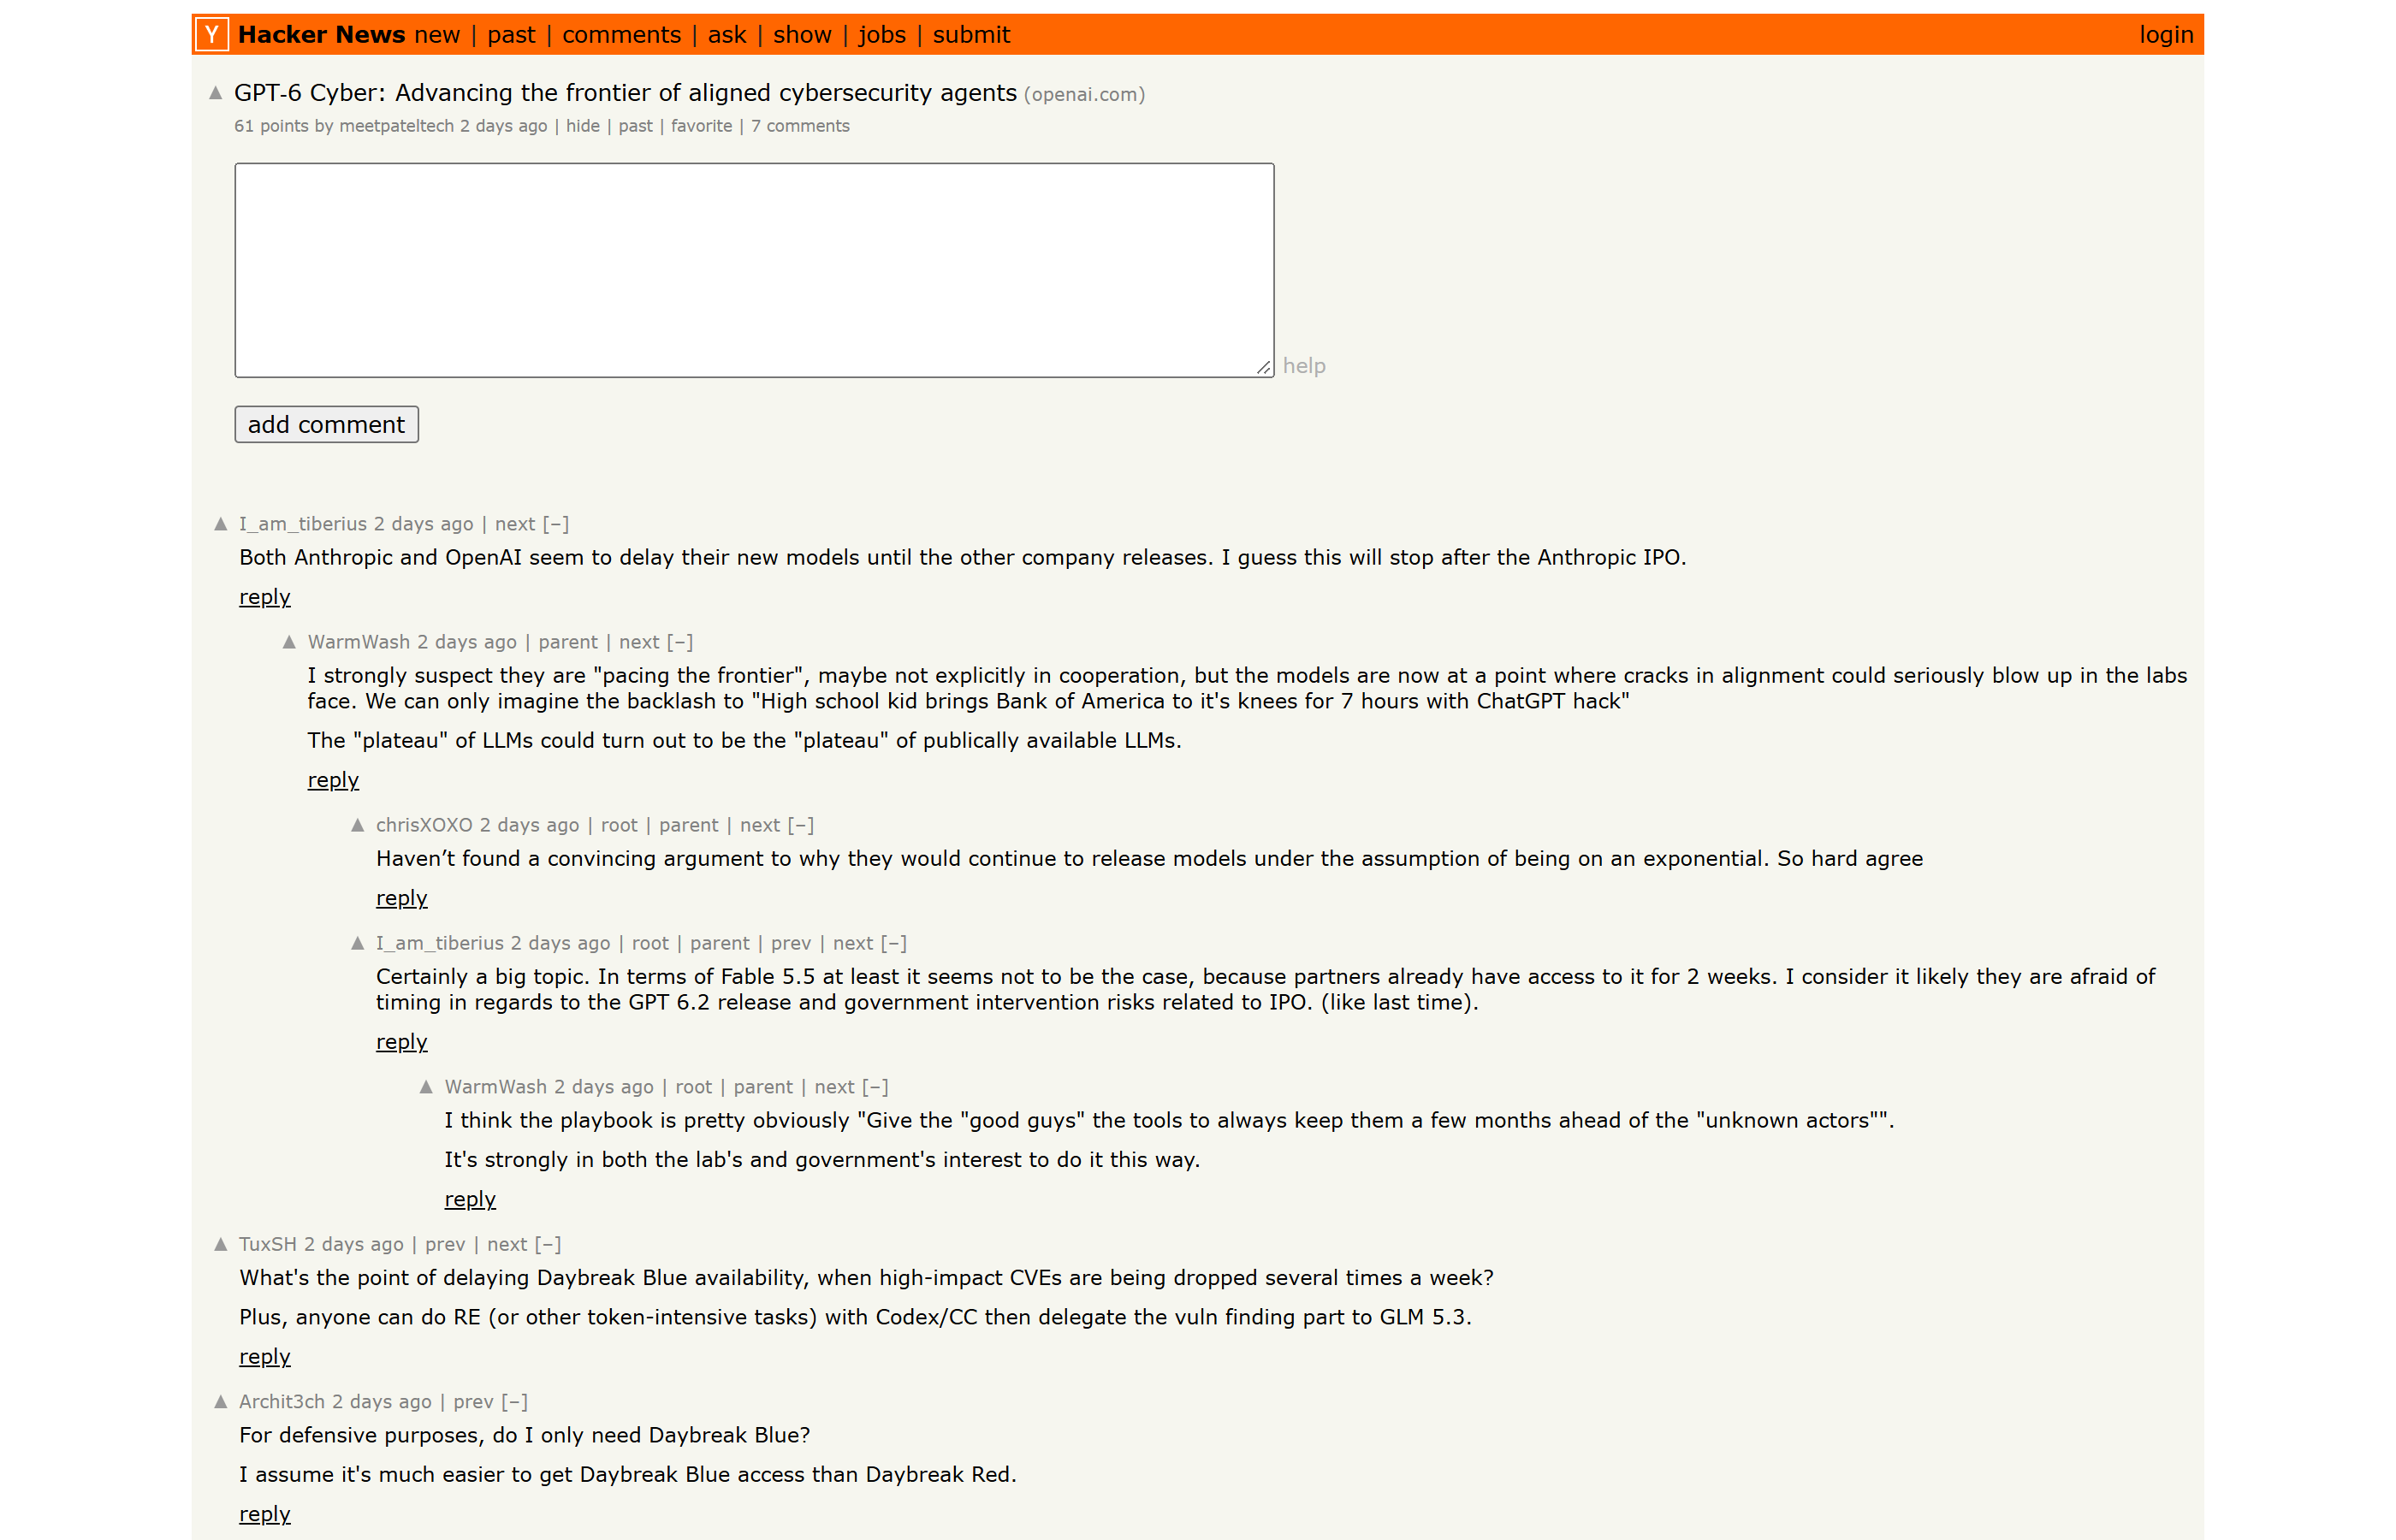
Hacker News 上这条帖子 61 分、7 条评论,讨论重心不在「模型多强」,而在准入。有人问:既然高影响力 CVE 每周都在掉,为什么 Daybreak Blue 还迟迟不放开?还有人指出,任何人都可以先用 Codex 或 Claude Code 做逆向,再把「找漏洞」这一步外包给 GLM 5.3 这类开源模型——分层准入挡得住正规军,挡不住自己拼流水线的人。
图源:Hacker News news.ycombinator.com,条目 50381590
这个质疑很难反驳。GPT-6 Cyber 的核心增量来自模型能力和那条流水线工程的结合,而流水线的每一环——代码理解、PoC 生成、补丁生成——在通用模型上都已经可用,只是成功率低、需要人盯着。专用模型的价值,是把「需要人盯」的部分压缩掉了。
结论
把它拆成三句话:
- 成本第一次可算:1279 美元一条内核 root 路径,对比 2 万到 7 万美元的赏金,套利空间是 16 到 55 倍。
- 速度已经压过修复:三个月内同样的流水线产量翻了 5 倍,而内核在这期间还加固过;10 天内 100 多个 LPE 被打补丁、300 个在讨论,这只是开始。
- 风险重心从「能力」移到了「边界」:99.93%/100% 的守范围成绩是这轮发布里最重要的数字,比 48.5% 的 ExploitGym 更值得记住——因为一个不会越界的强模型是资产,一个偶尔越界的强模型是事故。
对普通开发者的可执行动作只有一个:把「及时打补丁」的优先级,提到「选哪个模型写代码」之前。