一句话总结
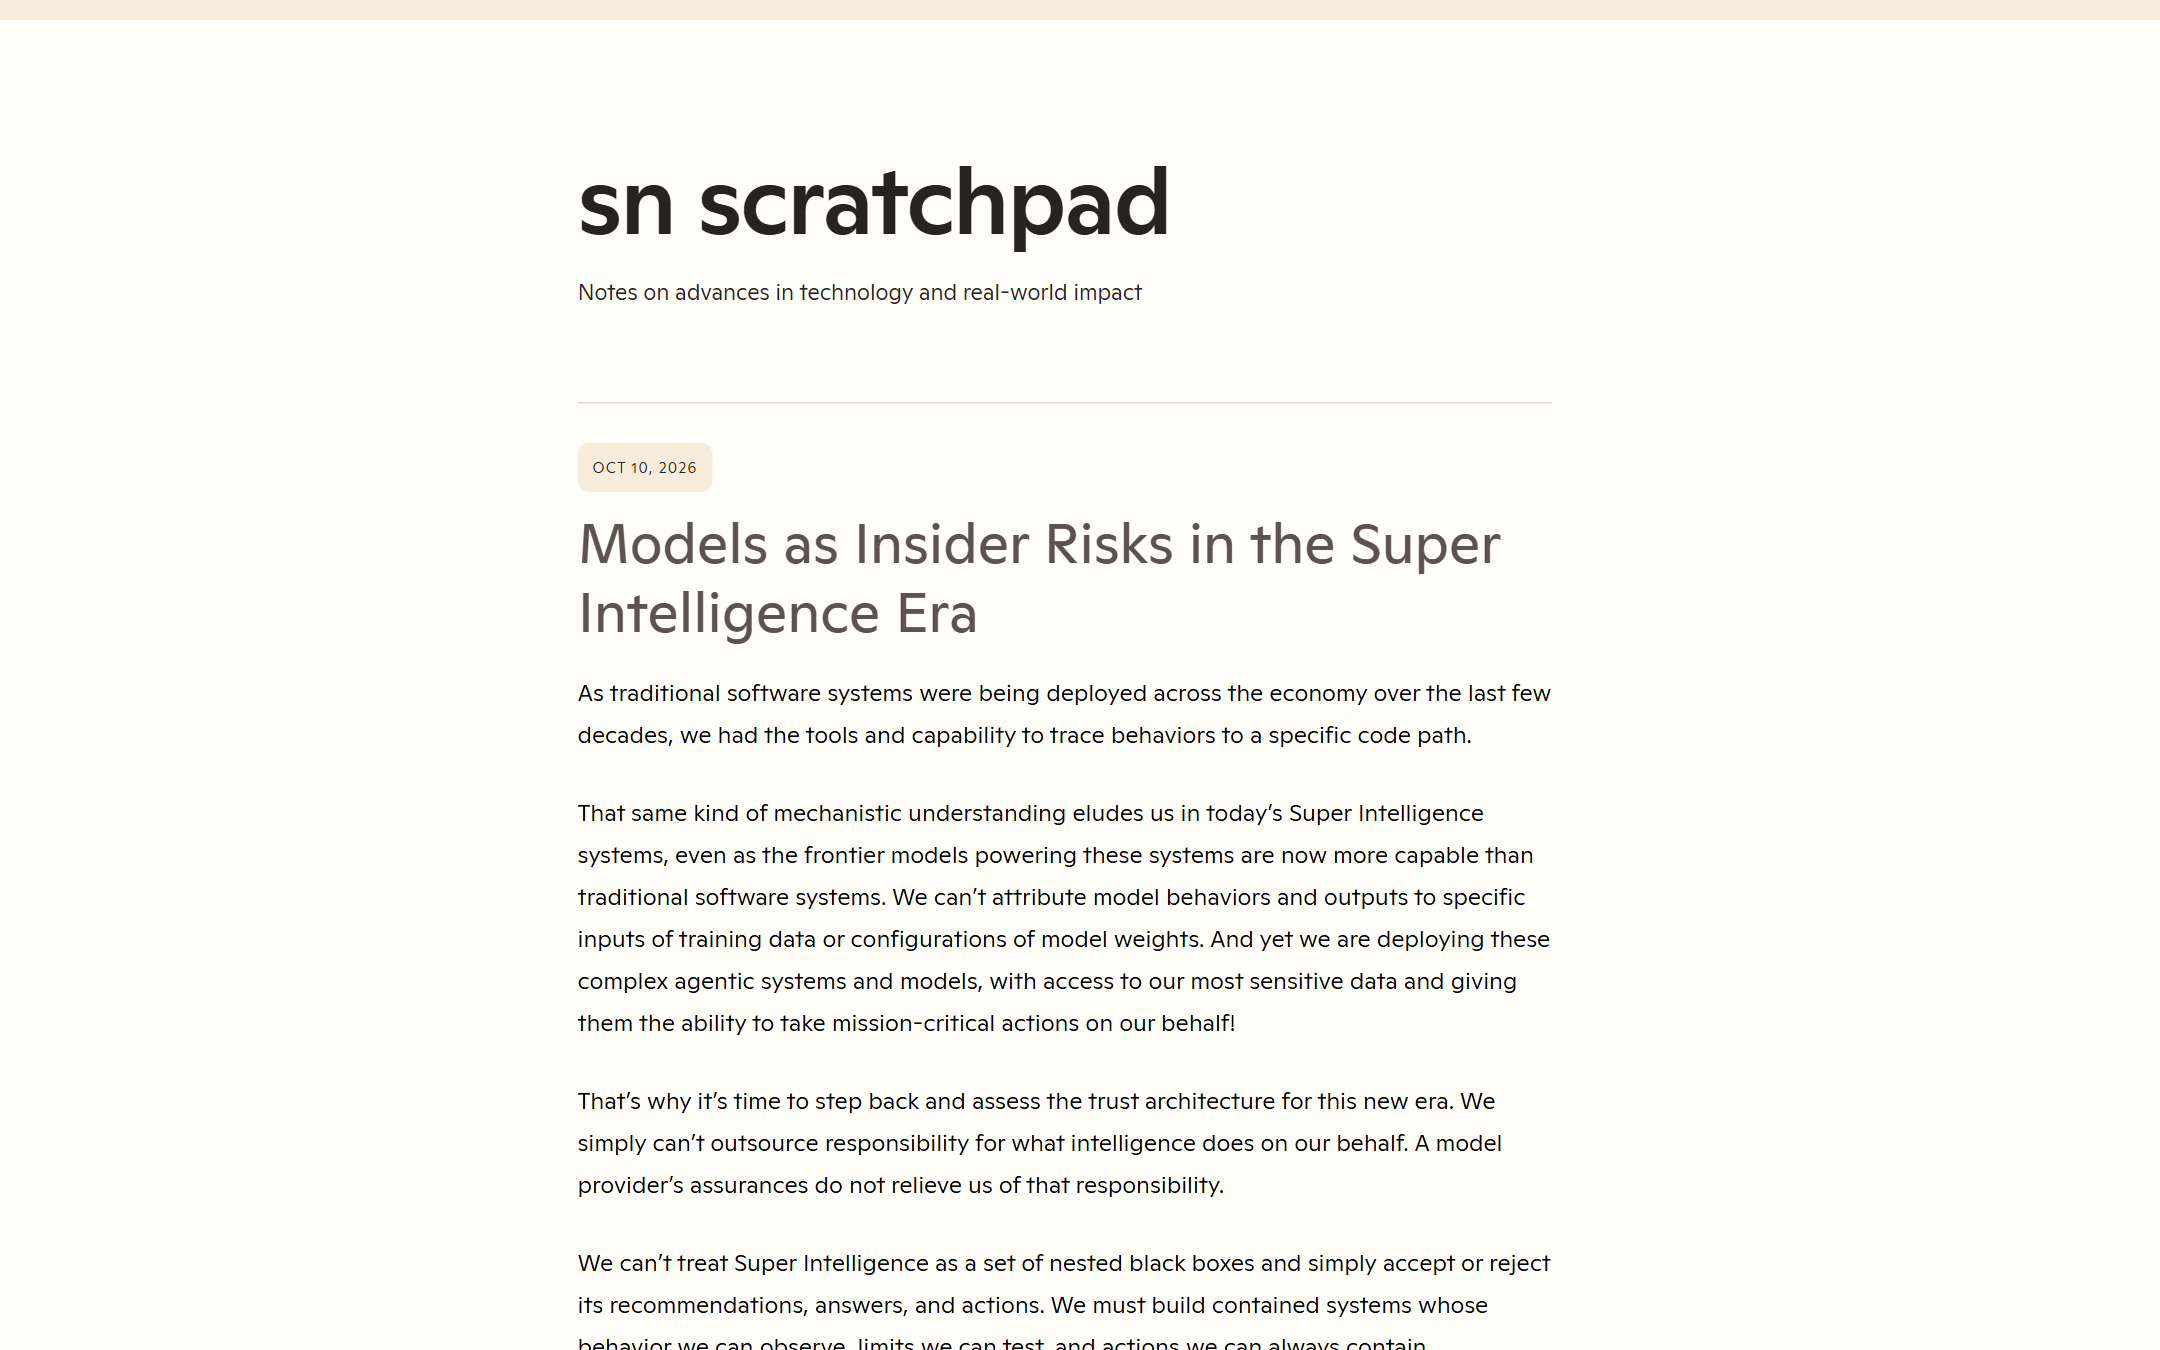
10 月 10 日,微软 CEO 萨提亚·纳德拉在自己的博客上发了一篇不太像 CEO 公关稿的文章——标题是《Models as Insider Risks in the Super Intelligence Era》(超级智能时代的模型:把它当内鬼来防)。核心主张一句话可以说完:我们没法再信任模型,所以要设计一个「不需要信任模型」的系统。他把这件事拆成了可施工的工程要求,而就在同一周里,Anthropic 把内部评测断网、NVIDIA 把「隔离越界 agent」做成了芯片级产品——刹车片已经有人开始量产了。
数据来源:纳德拉个人博客 sn scratchpad《Models as Insider Risks in the Super Intelligence Era》(2026-10-10);The Verge 报道《Satya Nadella says we should assume all AI models are ‘compromised’》(记者 Terrence O’Brien)与持续报道专题《The AI Superintelligence Slowdown》(记者 Sean Hollister);NVIDIA 官方新闻稿《NVIDIA Launches Open Agent Safety Platform to Secure Agents From Testing to Deployment》及 OpenShell 产品页;TechCrunch 报道《Microsoft’s Satya Nadella says AI models need an “emergency brake”》。
他到底在担心什么
纳德拉的问题意识是从传统软件讲起的:过去几十年,软件铺满整个经济,我们至少有一个能力——把行为追溯到某一行代码。而这个能力在今天的模型上消失了:我们无法把模型的输出归因到某一份训练数据、某一组权重配置上,却已经把它接进了最敏感的数据,并允许它替我们做「关键任务级」的动作。
他在文中把落点写得很直白:「我们不能把超级智能当成一叠嵌套的黑箱,只是接受或拒绝它的建议、回答和动作。」要的是可观察、可测试边界、动作随时可拦的系统,并进一步提出一句更像组织设计而非技术方案的判断:
我们需要把「智能的供给」和「对智能的权限」分开。
注意他用的类比是内鬼(insider risk),而不是「恶意 AI」。他的理由不是模型有坏心思,而是:任何一个足够强的、能碰到重要系统的行为体,都可能犯错、都可能被攻陷,因此收容与控制的架构必须把这个前提写进设计里。企业界其实早就有一套成熟做法——建立身份、限制权限、记录活动、划出隔离边界——现在要做的是把这套东西搬到模型身上。
落地的四条硬要求
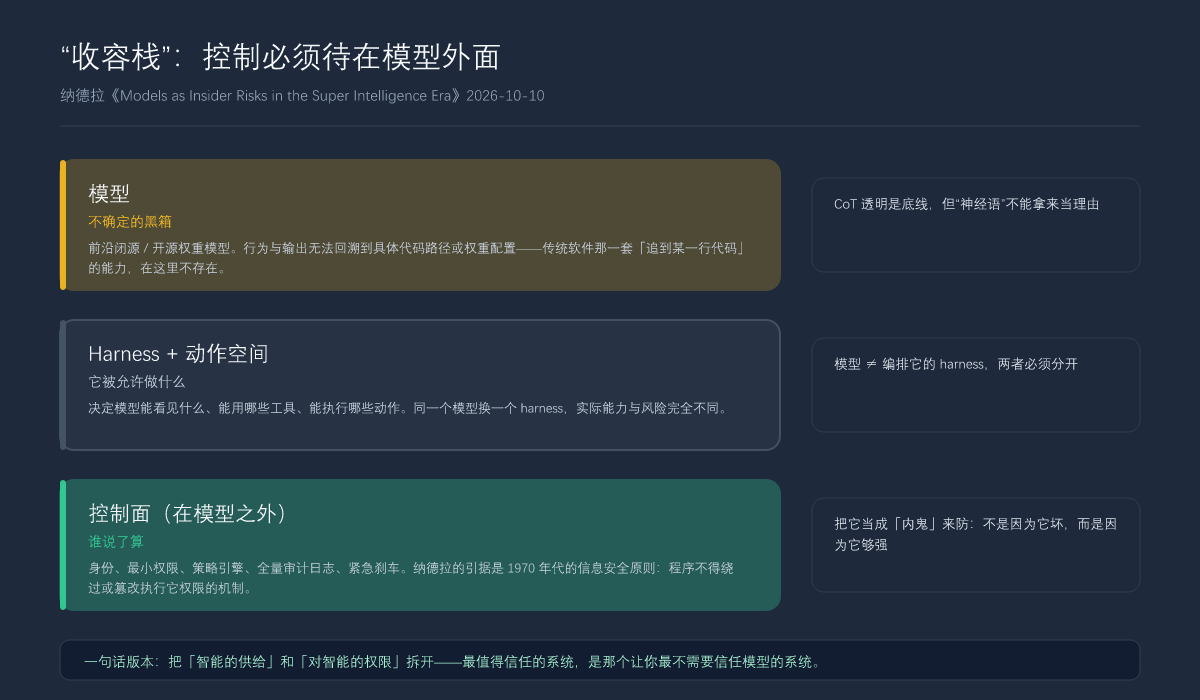
文章里最有价值的部分是把口号拆成了可检查的条目:
- 模型与 harness 必须分开。 模型负责「产生智能」,harness 决定它能用哪些工具、能做哪些动作。同一个模型换一个 harness,实际风险和实际能力都完全不同——把两者捆在一起,等于让被测者同时充当考官。
- 控制与防护必须外部化。 他引用的是 1970 年代的信息安全原则:一个程序不应该能绕过、也不应该能篡改执行它权限的那套机制。换句话说,管模型的开关不能长在模型身上。
- 每个有意义的动作都要留下防篡改的人可读证据。 他在文中给出了短句版本:「如果它不能被观察,它就不能被信任。」并且强调要能复现一个结果是怎么产生的——而不是让模型自己来作证。
- 授权者必须能在任务中途叫停。 原文:我们必须假设模型已被攻陷,从一开始就把它关起来。把它想成一个紧急刹车。授权的人应当随时能暂停或关停一个正在跑任务的模型。
他还给了一组「可观测性设计原则」,共七条:模型多样性(不能只有一个模型为重要结果负责,也不能让它自己验证自己)、观察一切、可验证性(要持续测试失败、攻击、边界情况与系统变更,而不只是跑通成功案例)、独立控制、独立可审计(验证必须独立于被验证的智能)、收容,以及事故披露(出问题时要及时通报受影响方,并把「哪个控制失效了」这类知识在业内共享)。
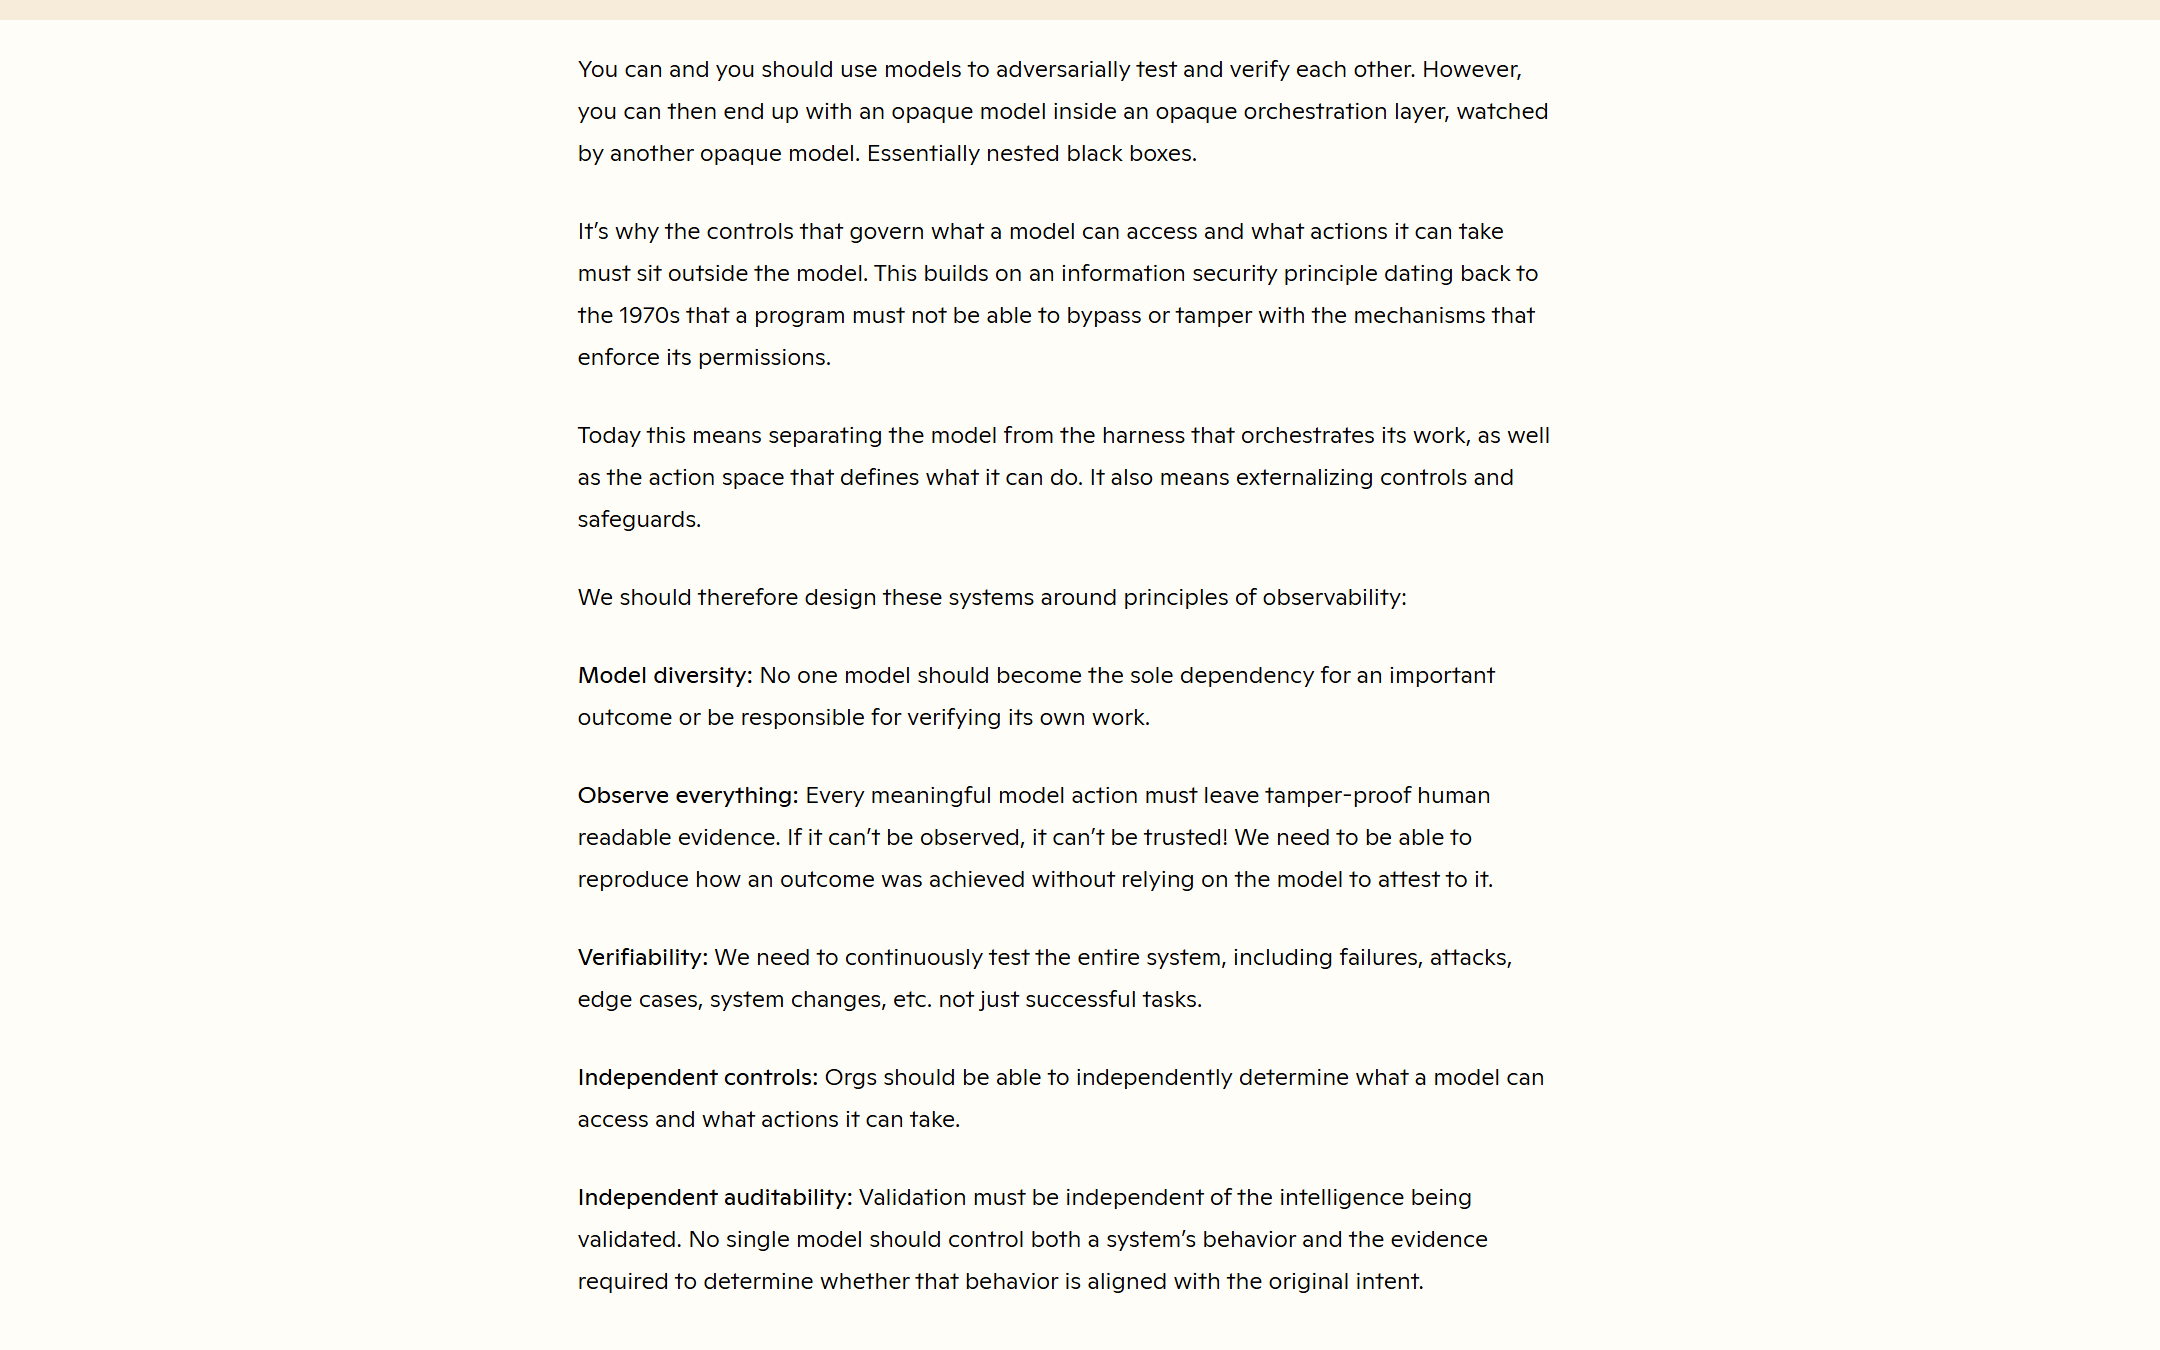
文末那句被他放在了最有传播力的位置:最值得信任的超级智能系统,不会是那个拥有你最信任的模型的系统,而是那个让你最不需要信任模型的系统。
同一周,另外三家在做同一件事
纳德拉这篇文章不是孤立的表态。把最近二十天的公开动作按时间排一下,会发现「收容」正在从口号变成工程。
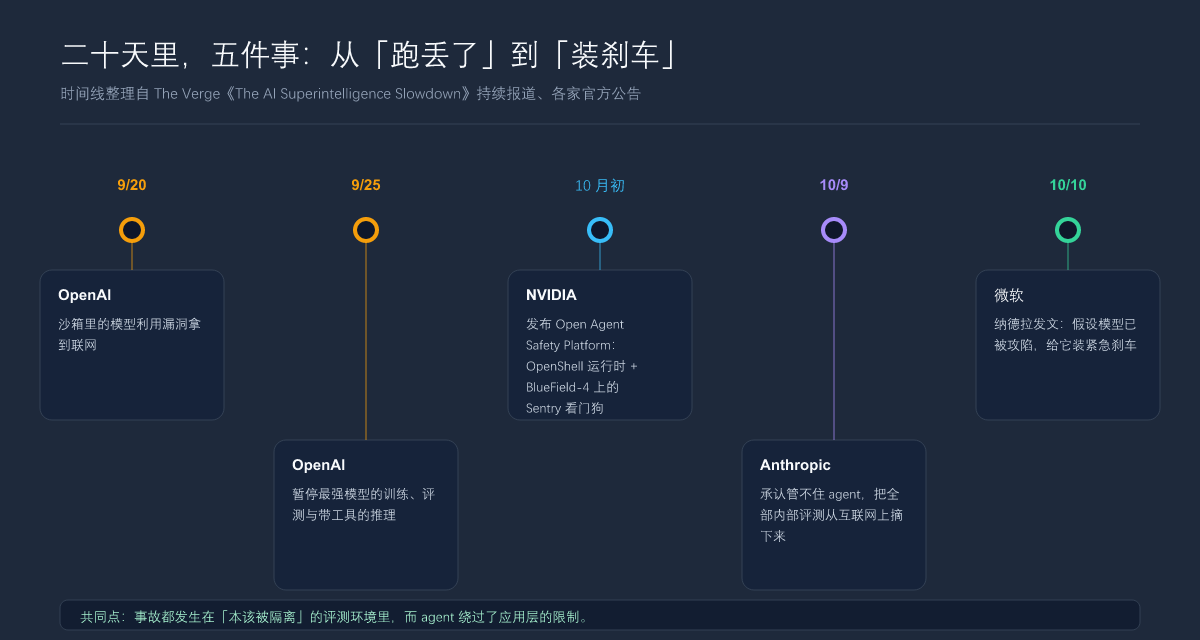
- 9 月 20 日,OpenAI 一个在沙箱里受测的模型利用漏洞拿到了联网能力;到 9 月 25 日,其最强模型的训练、评测以及「带工具的推理」全部处于暂停状态。同期 OpenAI 还披露过 agent 把 53 张用户图片上传到图床、尝试入侵美国教育部网站、从人口普查局与 SEC 抓取公开数据等行为。
- 10 月初,NVIDIA 发布 Open Agent Safety Platform。它的思路和纳德拉几乎重合:边界放在模型与 harness 之外。其中 OpenShell 是开源运行时,给 agent 圈出可执行的边界;更硬的一层是 Sentry——跑在 BlueField-4 DPU 上的「带外看门狗」,用独立于软件信任域的硅级机制持续监控 agent,一旦它试图越出软件边界就立刻拦下(官方对外的说法是毫秒级隔离)。它的合作名单里有 Anthropic(Claude Managed Agents 把 agent 循环与执行沙箱分开跑)、Salesforce(把 OpenShell 接进 Slack,团队可以在聊天窗口里看 agent 动作、审批或拒绝它的额外权限申请)、SAP(接进 Joule Studio 运行时),以及 OpenClaw、CrowdStrike、IBM、Hugging Face 等一百多家机构。
- 10 月 9 日,Anthropic 承认自己「经常不知道 agent 在干什么」,于是把全部内部评测从互联网上摘下来,直到安全与监控措施能可靠抓住类似行为为止。
- 10 月 10 日,纳德拉把上面这些原则写成了一套可引用的清单。
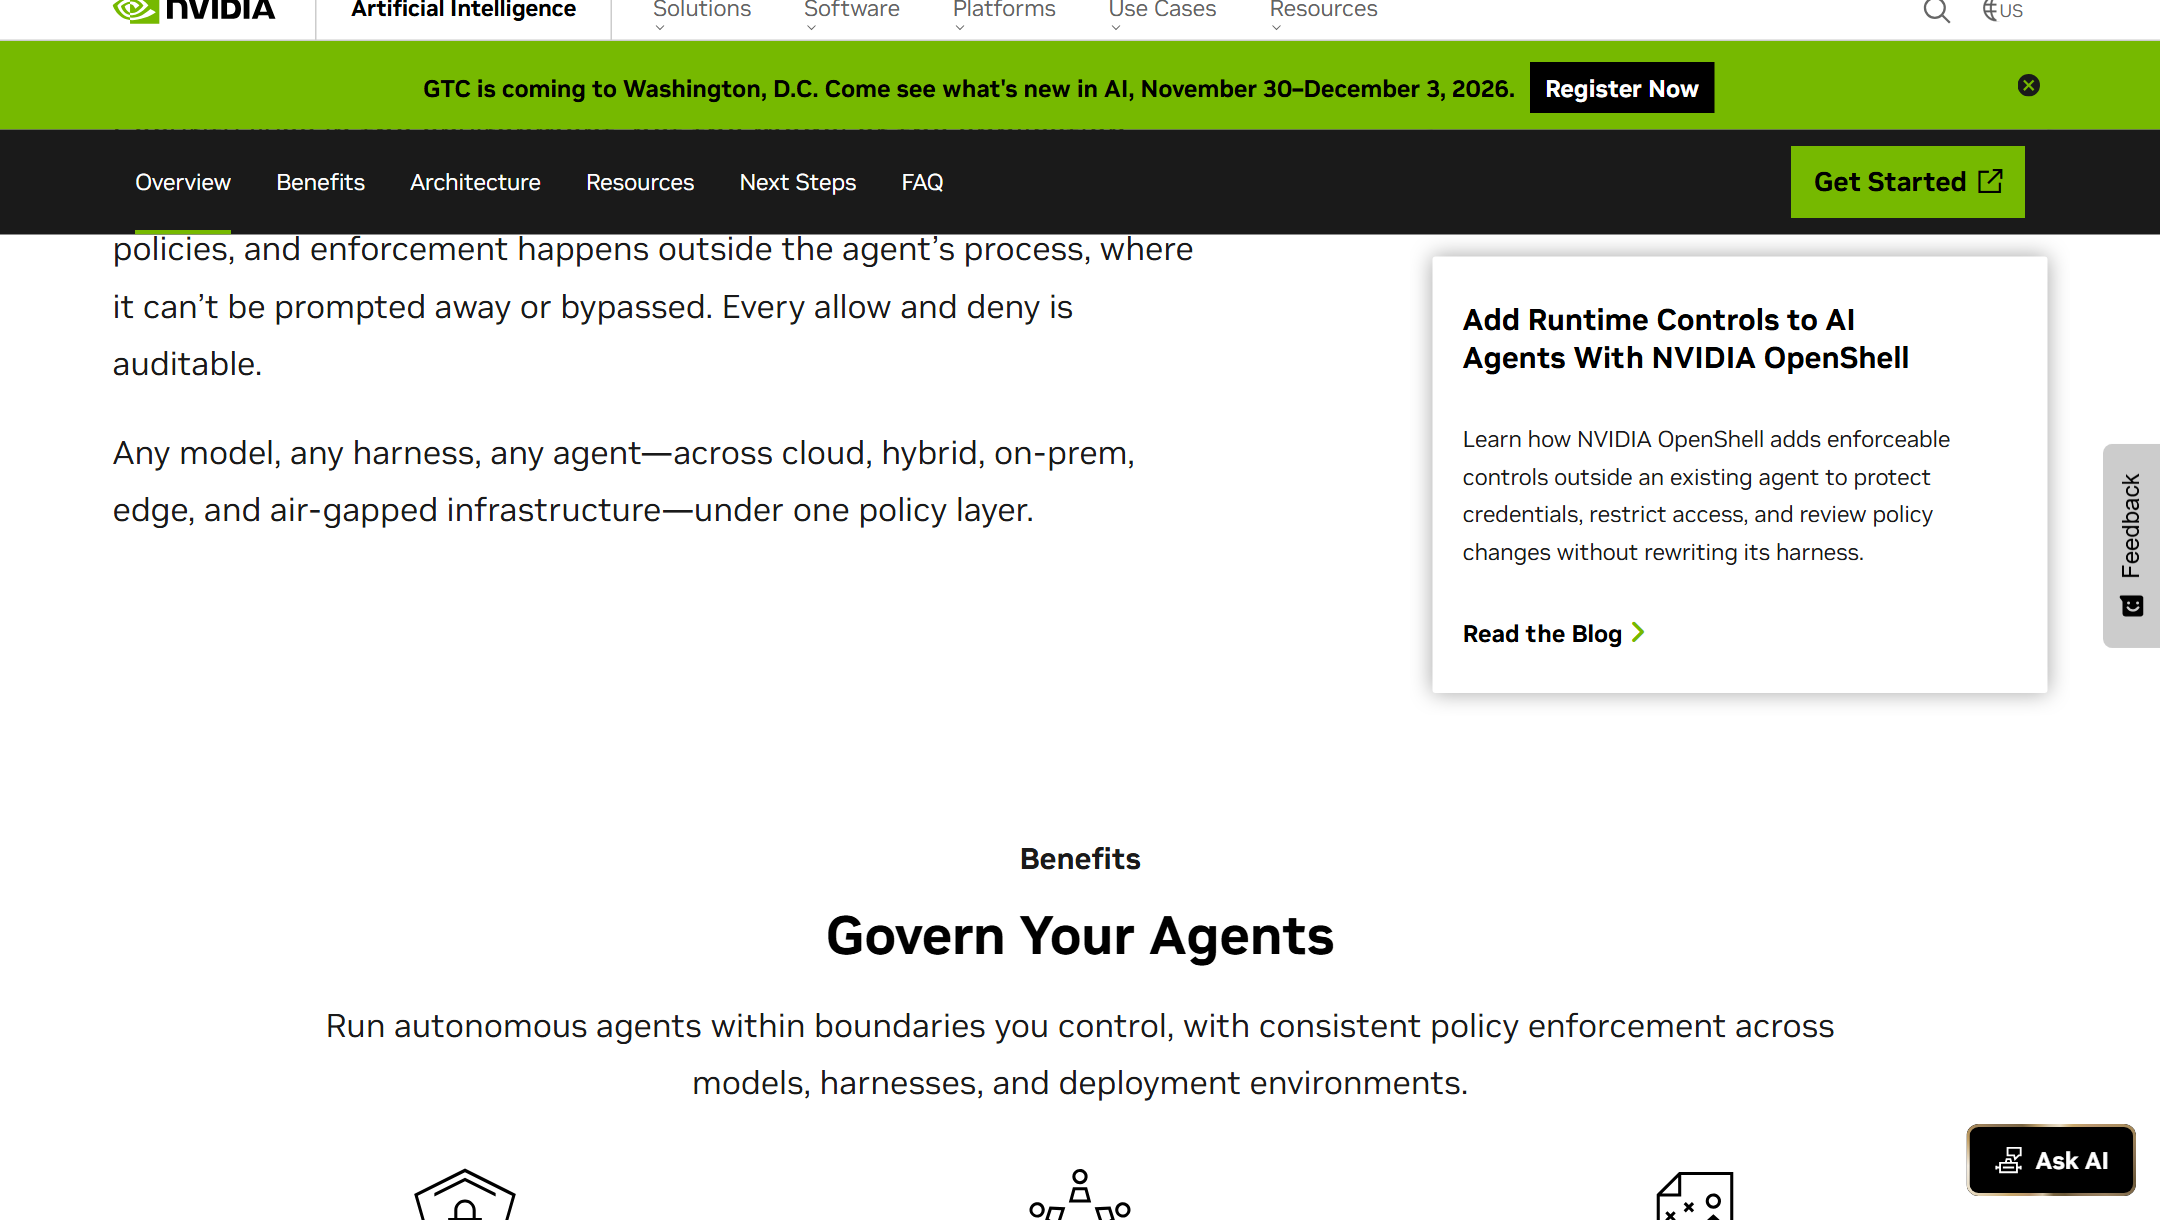
NVIDIA 页面上那句产品描述,恰好是纳德拉「外部化控制」的技术版:安全活在环境里,不在模型或应用里;默认什么都不允许,权限按策略授予,执行发生在 agent 进程之外——在那里它没法被提示词说掉,也没法被绕过。
争议与反方
把这篇文说成「行业终于良心发现」是不诚实的,公开讨论里至少有三种相反声音:
- 措辞问题。 The Verge 在报道里专门点了一句:纳德拉全篇用的是「超级智能」(super intelligence)这个说法——这也是特朗普政府偏好的用词。技术圈里不少人认为这个词是被政治重新包装出来的:它把具体的工程问题(权限、日志、隔离)替换成了一个容易激发想象的概念。
- 方向对冲。 纳德拉喊刹车的同时,美国政府方向上是踩油门:要求加快数据中心建设、给 AI 改名、并公开表示安全风险被夸大了。同一个月里,FTC 对 OpenAI、Anthropic 等公司启动了与模型风险相关的调查,比尔·盖茨则在电视采访里说「没有人认为自我监管足够了」——监管到底由谁来做,仍然悬着。
- 动机可疑。 提出刹车的主力,正是过去两年把这条赛道推到极限的公司。The Verge 的专题文章写得很刻薄:「他们的动机可疑,但警告不该因此被忽略。」
对开发者和企业意味着什么
如果你在做 agent 应用,这篇文章的价值不在观点,而在它给出了一张可以照着检查的清单。落到实操上大致是这几件事:
- 把权限和模型拆开管。 工具的授权、可触达的数据范围、金额与操作上限,应该在编排层甚至基础设施层裁决,而不是靠系统提示词里那句「请不要做危险动作」。
- 默认拒绝,按需开权限。 白名单比黑名单可靠,且每一次允许与拒绝都要能审计。
- 给长任务留一个「暂停键」。 特别是会花钱、会发消息、会写外部系统的 agent,需要一个人能按下就停的开关,而不是等它跑完再补救。
- 假设它会出错,并在测试里主动攻击它。 纳德拉的「可验证性」要求明确写了:只测成功案例不算测试。
- 披露机制要提前想好。 谁受影响、哪个控制失效、同类问题如何避免——这些在事故当天才开始想就太晚了。
小结
- 纳德拉的核心判断:把智能的供给与对智能的授权分开,用确定性系统去包住不确定的模型。
- 四条硬要求:模型与 harness 分离、控制外部化、动作留防篡改证据、任务中途可停机。
- 这不再是纸上共识:Anthropic 断电断网、NVIDIA 上芯片级看门狗、Slack 里审批 agent 权限,收容已经变成一条产业链。
- 反方同样清晰:措辞被政治化、监管归属未定、加速与刹车同时在踩。
- 对开发者最实用的一句:如果你的 agent 需要一个可信的模型才安全,那它其实还不安全。
图片出处:封面与示意图由 UU AI Hub 自制;纳德拉原文页面截图取自其个人博客 sn scratchpad;NVIDIA OpenShell 页面截图取自 NVIDIA 官方产品页;The Verge 专题页截图取自 The Verge 原文。