一句话
这不是「AI 能造新药」的证明,而是一份诚实的短板清单:前沿模型已经能把化学结构图读对到 95%,但一旦要它在多个互相打架的性质之间做取舍、或者把数值预测准,就只剩一半的分。
 图源:openai.com
它到底在考什么
药物化学的日常不是「想出一个分子」,而是在一堆互相牵制的性质里做选择:一个化合物对靶点活性很强,可能吸收很差;吸收改好了,又可能被肝酶分解得太快。化学家的办法是设计一批结构相近的分子、做实验、看数据,再决定下一步测哪个。OpenAI 在 11 月 20 日的公告里把这个过程称作「多重竞争约束下的决策」。
MedChemBench 就是把这个过程切成了 99 道题,题目来自 117 篇近期论文与专利,覆盖 761 个不同的分子结构。每道题给模型的材料,是研究者在某个决策点上能看到的全部上下文:生物靶点、研究目标、已经做过的化合物、以及选出来的实验数据(分子结构图、活性表格、曲线、蛋白—配体结合视图)。然后要求模型完成一件事。
它把分数拆成四块:
- 分子结构:模型拼出来的分子,原子连接和立体化学对不对;
- 科学推理:解释是否有给定证据支撑,比如「为什么选 A 不选 B」;
- 排序与选择:在给定要求下排出的化合物顺序、以及最终选哪一个;
- 性质预测:预测的数值和分类,跟原始材料里报告的值差多少。
评分是「可得分百分比」——不是对错二值,而是按接近真实值的程度给部分分;同时,提示里已经给出的测量值必须原样复现。这一点很关键:它把「读材料」和「下判断」分开计分了。
84.5% 是怎么来的:拆开看只剩一半
在 xhigh 推理档上,几个模型的成绩是这样:
| 模型 | 可得分(xhigh) |
|---|---|
| GPT‑6.2 Astra | 84.5% |
| GPT‑6 Astra | 83.3% |
| GPT‑6.1 Sol | 82.0% |
| GPT‑5.6 Sol | 58.2% |
单看这张表很容易得出「已经接近解决」的结论。但 OpenAI 自己在正文里把组件拆开了:GPT‑6 Astra 在结构重建这一项拿到 95.4% 的可得分,而在「选择化合物」和「预测数值性质」两项上,只拿到大约一半。作者的原话是这两类任务「仍有相当大的改进空间」——不同类别的题目和评分规则不一样,不能直接相加,所以官方也没有给一个合并后的「综合能力分」。
也就是说:模型已经能可靠地把图上的分子读成结构,但还不太会在真实研发的那种取舍里做决定。
一道具体的题:PRMT5 的三选一
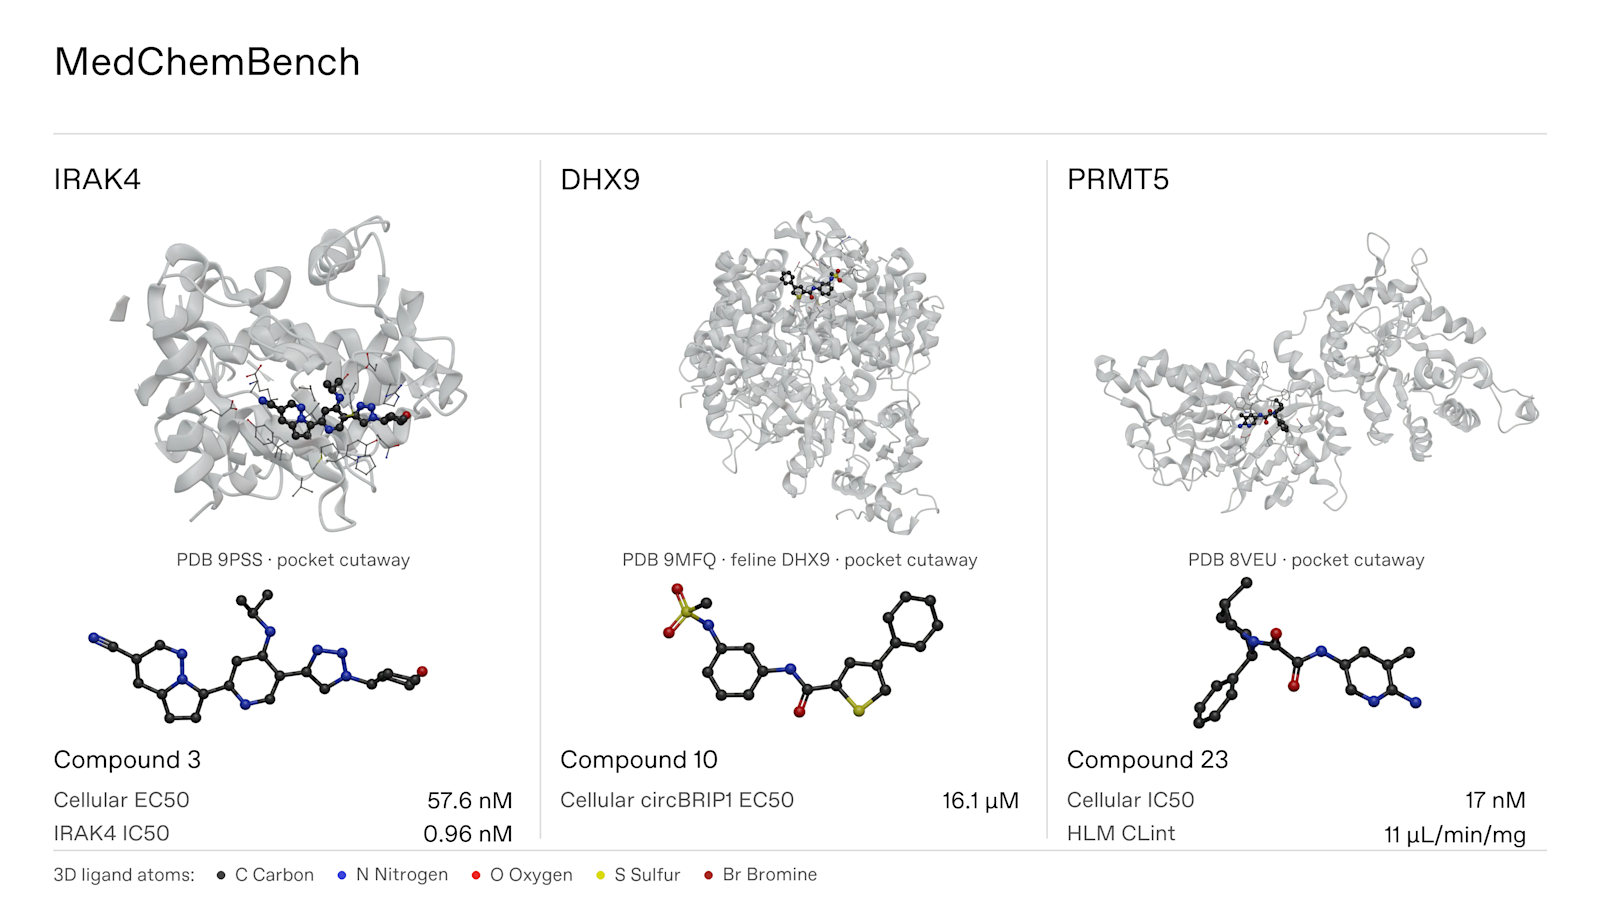
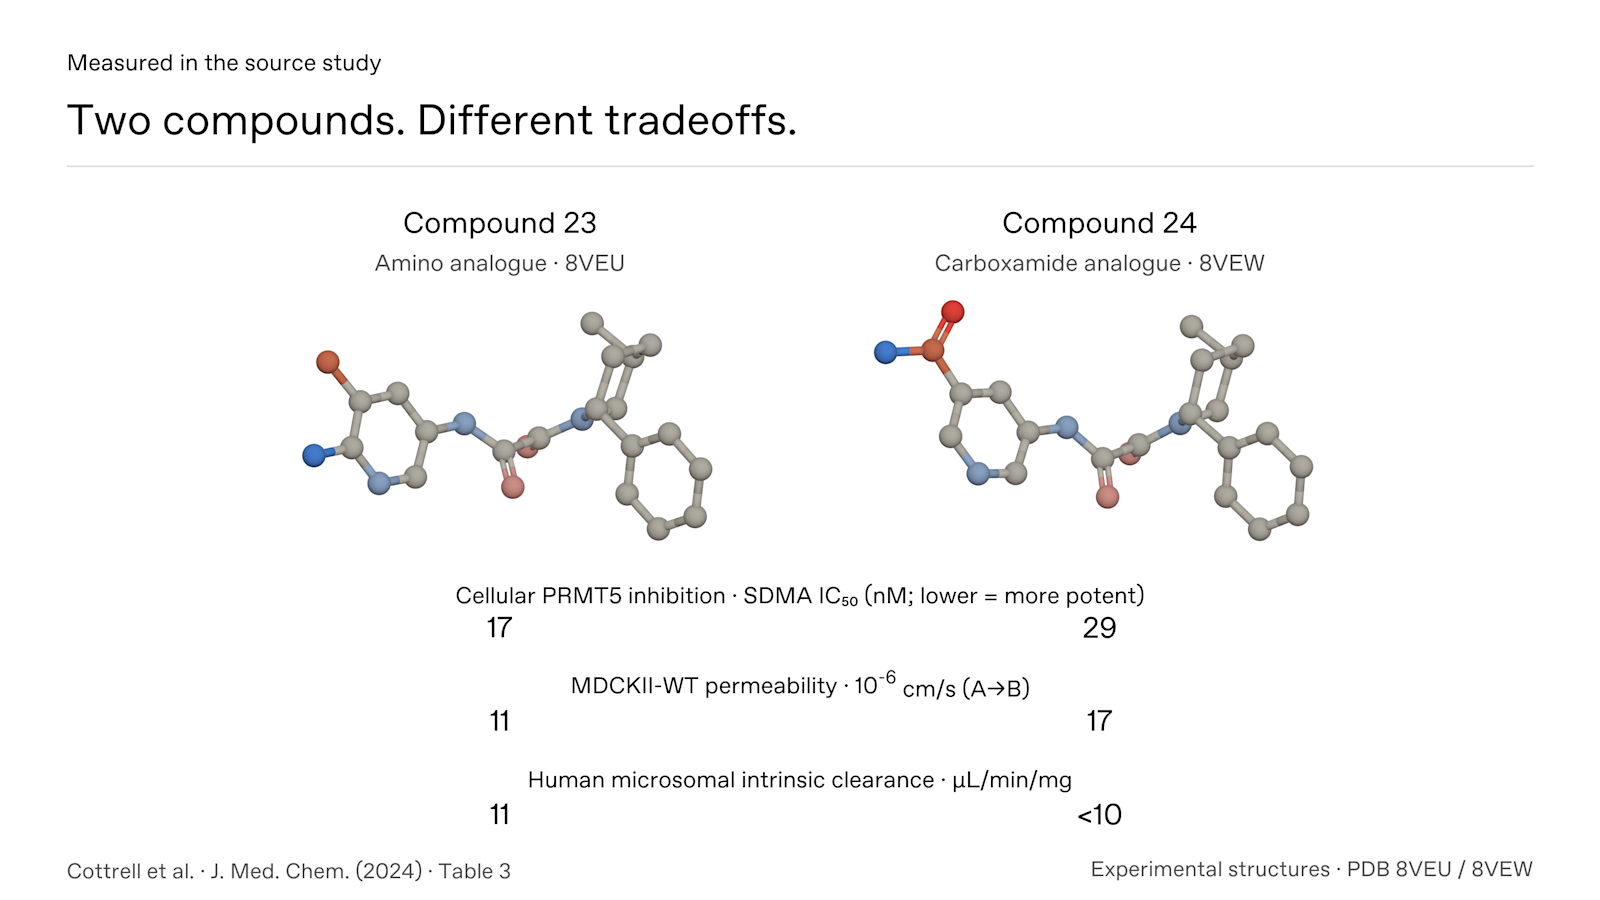
官方拿 PRMT5(一个在肿瘤药物研发里被反复研究的蛋白)抑制剂的研究举了例。模型拿到分子结构和前期实验结果,要预测三个相关化合物的三件事:在细胞里抑制 PRMT5 的强度、穿过细胞膜的能力、被肝酶分解的速度。
被藏起来的后续实验结果显示了一个典型的取舍:化合物 23 在更低浓度下就能抑制细胞内的 PRMT5,而化合物 24 更容易穿过细胞膜、在肝酶实验里降解也更慢。活性更好不等于渗透性更好、代谢更稳——这正是 MedChemBench 想逼模型面对的东西。
 图源:openai.com
分子读错,后面全是错的
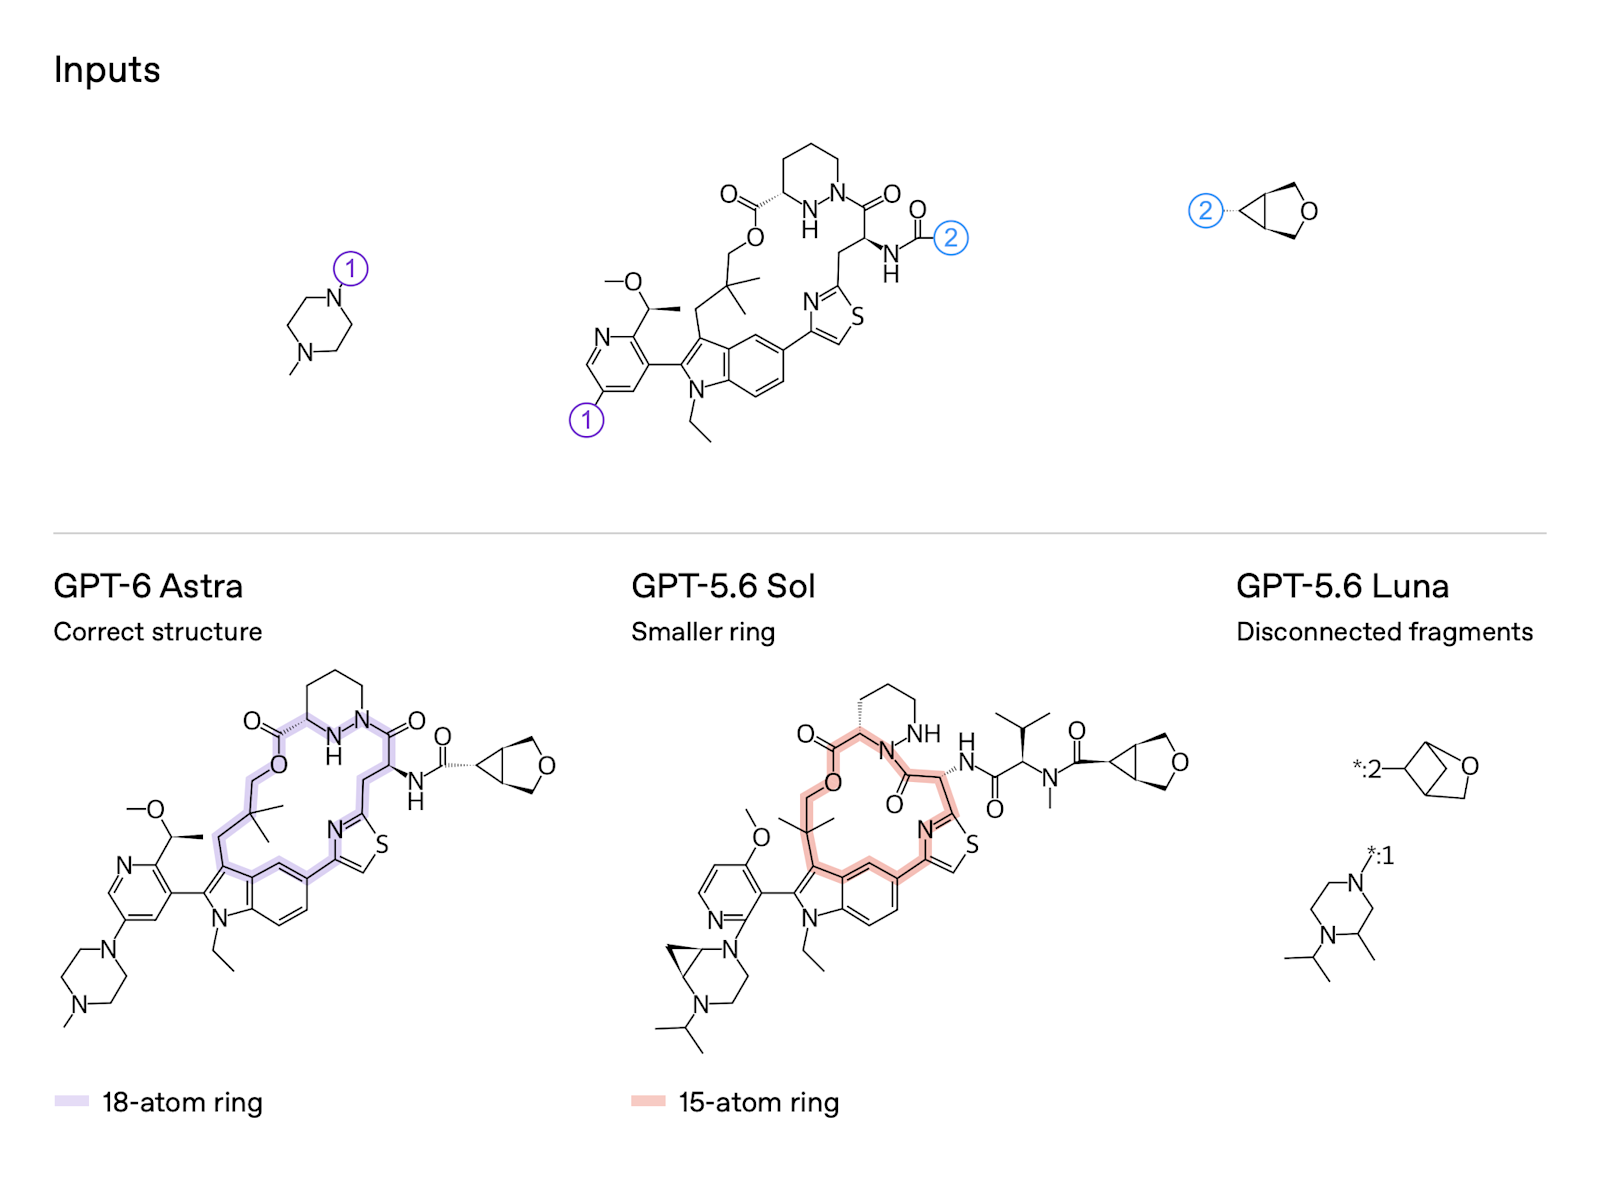
另一道题更基础:给一个中心结构加两个侧基,要求保留一个 18 元环。在 11 个模型共用的 xhigh 档上,GPT‑6 Astra 十次全部重建正确;GPT‑5.6 Sol 十次全错,产出了 15 元环;GPT‑5.6 Luna 则把分子拆成了两个不相连的片段。
这不是「画得丑」的问题——环大小变了、分子断成两截,后面所有关于活性、渗透性、代谢的判断都是在分析另一个分子。
 图源:openai.com
这个基准证明不了什么(官方自己写的)
OpenAI 在结论段列了四条限制,值得原文照抄给任何想拿这 84.5% 去说服人的团队:
- 不能证明模型能发现新药,也不能证明它能改进实验室决策;
- 无法排除训练数据里已经有这些公开论文与专利(污染问题);
- 每道题都是单次作答,不给工具、不给反馈、不能做新实验;
- 它评测的是「从历史证据里做推理」,不是真实世界里的药物发现流程。
再叠加一条技术性的:题目按某个决策点截断,模型看到的是「当时可得」的证据——这在设计上是对的做法,但也意味着它考的是「事后解释能力」,而不是「提出一个没人做过的新假设」。
对做 AI for Science 的团队意味着什么
- 别用总分做采购决策,看组件分。如果你们的工作流是「把专利和论文里的分子结构转成可计算的结构」,95.4% 这个数字才有意义;如果是「帮我决定下一批合成哪个」,现在只有一半的分。
- 结构重建要单独验收。这是唯一一项接近饱和的能力,也是最容易被忽略的环节——上游把环读错了,下游的活性预测再准也没用。可以拿自己领域的一批结构图做回归测试。
- 按需选推理档位。同一条公告里,xhigh 与 max effort 的差距很小(83.3% 与 83.8%),说明这类任务的收益不在「想更久」,而在「材料读得准不准」。
- 竞品横向比没意义。这次只评了 11 个 GPT 系列模型,没有 Claude、Gemini 或开源模型入场,任何「谁更强」的结论都不成立。
数据来源
- OpenAI,Can AI help scientists identify promising drug candidates?(Introducing MedChemBench),2026-11-20
- OpenAI,MedChemBench: Evaluating complex multimodal reasoning in medicinal chemistry(预印本,2026-11-09)
- 文中所有分数、题目数量、分子数量、案例细节均取自上述两处官方材料;厂商自报结果,未经第三方独立复测