一句话总结
SpaceXAI 在 9 月 21 日放出 Grok 4.7,官方口径只有一句:“相比 Grok 4.6 有显著提升,价格和速度一样。” 但 Artificial Analysis 的独立评测摆出了另一半事实:智能指数 46 分(4.6 是 44,只涨 2 分),速度从 60.4 掉到 38.8 token/秒(慢了约 36%),评测中生成的 token 从 94M 涨到 240M(2.5 倍),每个任务的成本从 $1.86 翻到 $3.74。单价确实没变($2/$6 每百万 token),变的是它现在要想得多得多。
数据来源:SpaceXAI 官方发布推文(2026-09-21)、Artificial Analysis Grok 4.7 / 4.6 / 4.5 三个模型页与其智能指数 v4.3.2 图表、Hacker News 讨论帖(490 分、408 条评论)。文中配图来源已逐张标注。
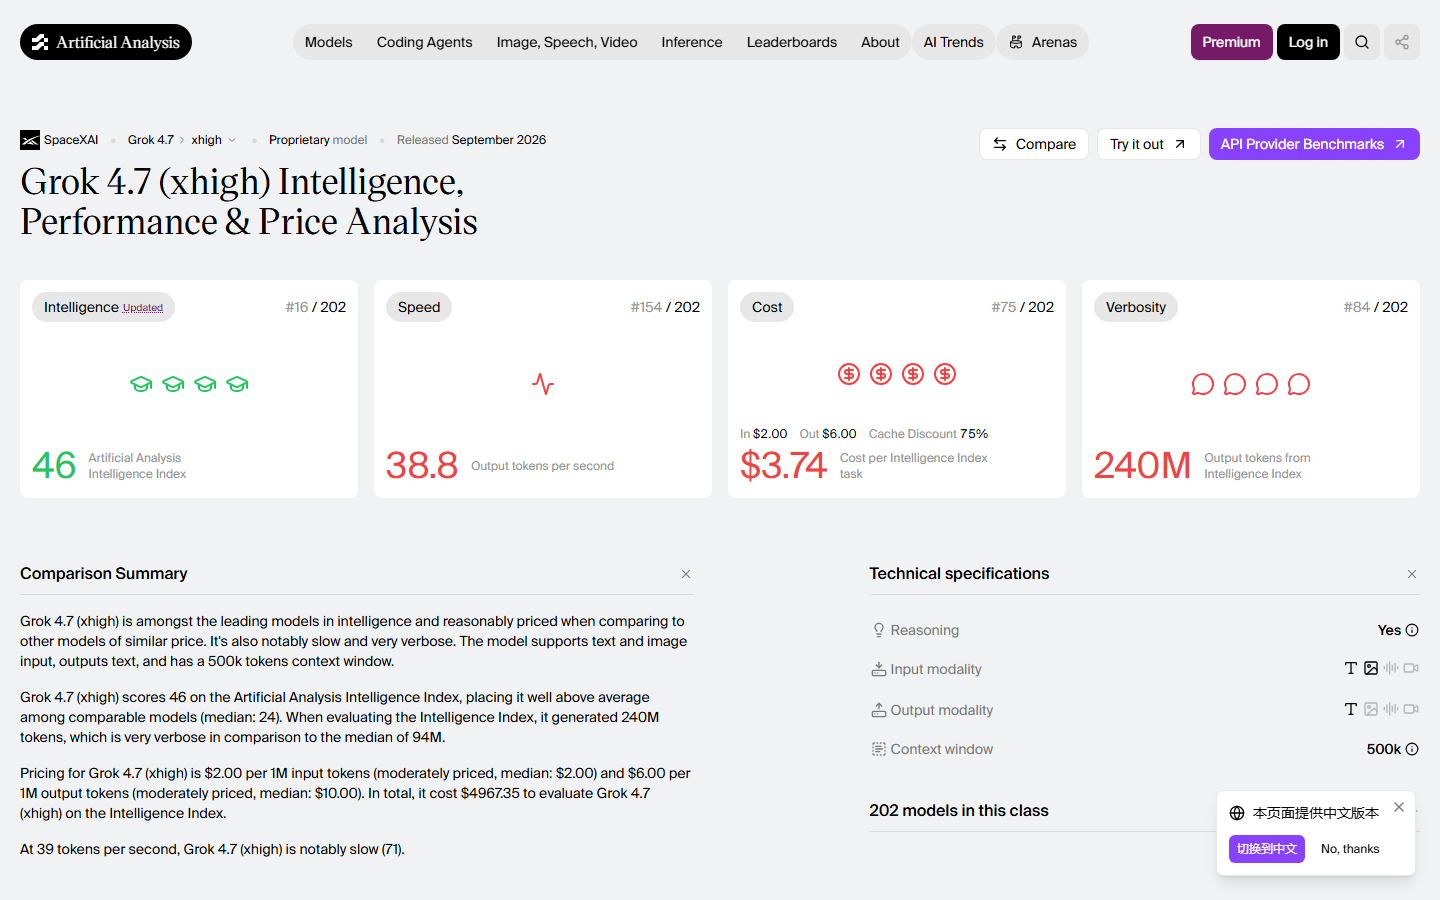
上图截自 artificialanalysis.ai 的 Grok 4.7 (xhigh) 页面。四张卡片就是本文的全部论证骨架:智能 46(第 16/202)、速度 38.8 token/秒(第 154/202)、每任务成本 $3.74(第 75/202)、冗长度 240M token(第 84/202)。
官方到底说了什么
先看一手口径。SpaceXAI 的发布推文全文只有两句:
Grok 4.7 is here. It’s a notable improvement over Grok 4.6 at the same price and speed.
“And the same price and speed”——这是本文最需要拿放大镜看的一句。因为独立评测的结果是:价格确实一样,速度不一样。
这不是谁在说谎,而是”速度”这个词在两边的定义不同。官方所说的”same speed”大概率指的是单位 token 的价格与吞吐这一层没动($2 输入 / $6 输出,与 4.6 完全一致);而 Artificial Analysis 测的是端到端完成任务时的输出速度——一旦模型进入更深、更长的推理,同样的 token 单价就会换来看起来慢得多的响应。
一句总结:涨的是思考量,不是单价。
三条曲线摆在同一个坐标系里
把三代放在一起,趋势非常清楚:
| Grok 4.5 (high) | Grok 4.6 (high) | Grok 4.7 (xhigh) | |
|---|---|---|---|
| 智能指数 | 39 | 44 | 46 |
| 排名(共 202) | 第 43 | 第 23 | 第 16 |
| 输出速度 | 60.6 token/秒 | 60.4 token/秒 | 38.8 token/秒 |
| 速度排名 | 第 97 | 第 98 | 第 154 |
| 每任务成本 | $1.04 | $1.86 | $3.74 |
| 成本排名 | 第 42 | 第 57 | 第 75 |
| 评测生成 token | 77M | 94M | 240M |
| 评测总花费 | $1,403.78 | $2,351.83 | $4,967.35 |
| 上下文窗口 | 500k | 500k | 500k |
数据来源:Artificial Analysis。注意 4.7 一列是 xhigh 推理档,4.5/4.6 两列是 high 档——档位不同,这正是后面要解释的关键。
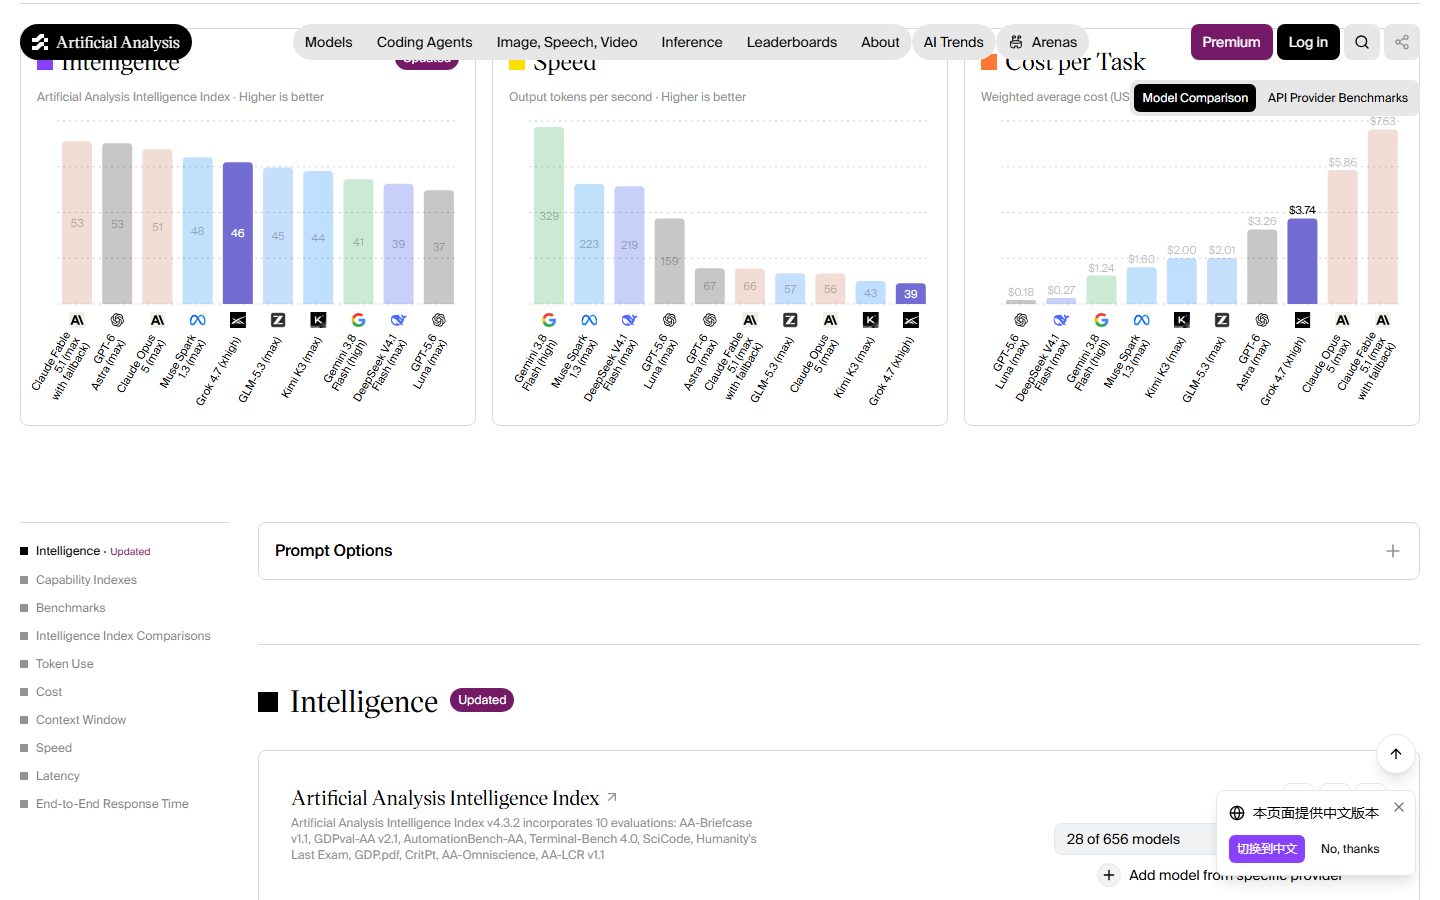
上图截自 artificialanalysis.ai。左图是智能指数,粉色/灰色(闭源)与蓝色(开源)分列;中图是输出速度,Grok 4.7 明显落在长条之后;右图是每任务成本——Grok 4.7 的 $3.74 已经站到了 $3 以上那一档,而它左边紧挨着的是一批 $1–2 的模型。
三个增长率的对比才说明问题:
- 智能指数:44 → 46,+2 分(约 +4.5%)
- 每任务成本:$1.86 → $3.74,+101%
- 评测中生成 token:94M → 240M,+155%
- 输出速度:60.4 → 38.8 token/秒,−36%
这就是”用更多思考换分”的教科书式样本。 单价没涨,但因为模型在每个问题上想得更久、写得更多,用户的账单和等待时间都翻了一倍。
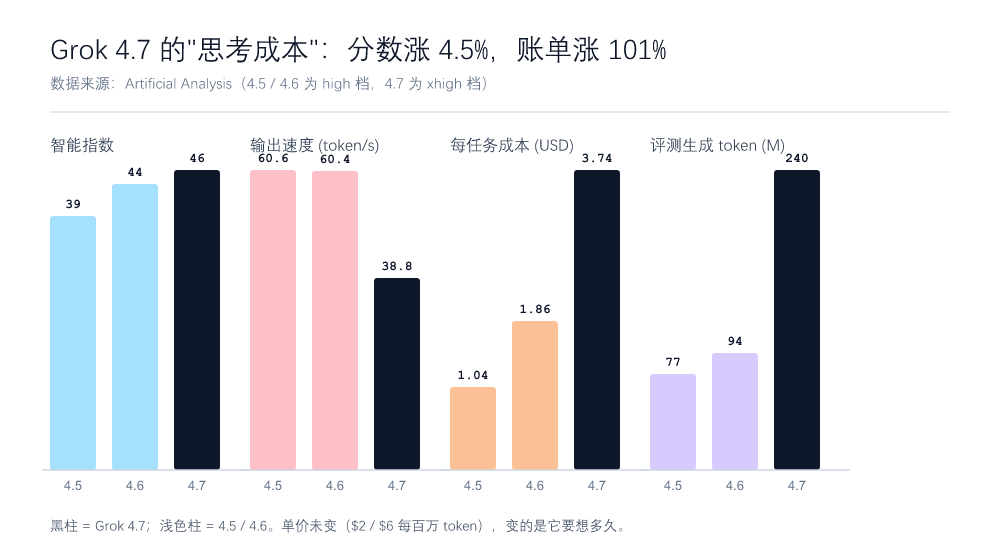
上图由 uuaihub 依据 Artificial Analysis 公布的数据绘制(黑柱为 Grok 4.7,浅色柱为 4.5 / 4.6)。四张子图共用一套口径:只有”智能指数”那一格在涨,另外三格分别对应掉下去的速度和涨上去的账单。
为什么会这样:档位变了
有一个容易被忽略的细节:Artificial Analysis 标注 Grok 4.7 用的是 xhigh 档,而 4.5/4.6 用的是 high 档。
在 AA 的页面上,Grok 4.7 同一条曲线里能看到 两个档位:xhigh 和 high。
- Grok 4.7 (xhigh):智能指数 46,评测生成 240M token,每任务 $3.74
- Grok 4.7 (high):智能指数 52 分(AA 的”智能与推理指数”分榜上)——与 xhigh 同分
也就是说,4.7 把 xhigh 这个档位拉到了与 4.6 的 high 档可比的分数,代价就是前面那三行数字。对使用者的实际含义很直接:如果你的场景不一定要最高档,切档就能把成本拉回来;如果非要那个 46 分,就得接受 38.8 token/秒。
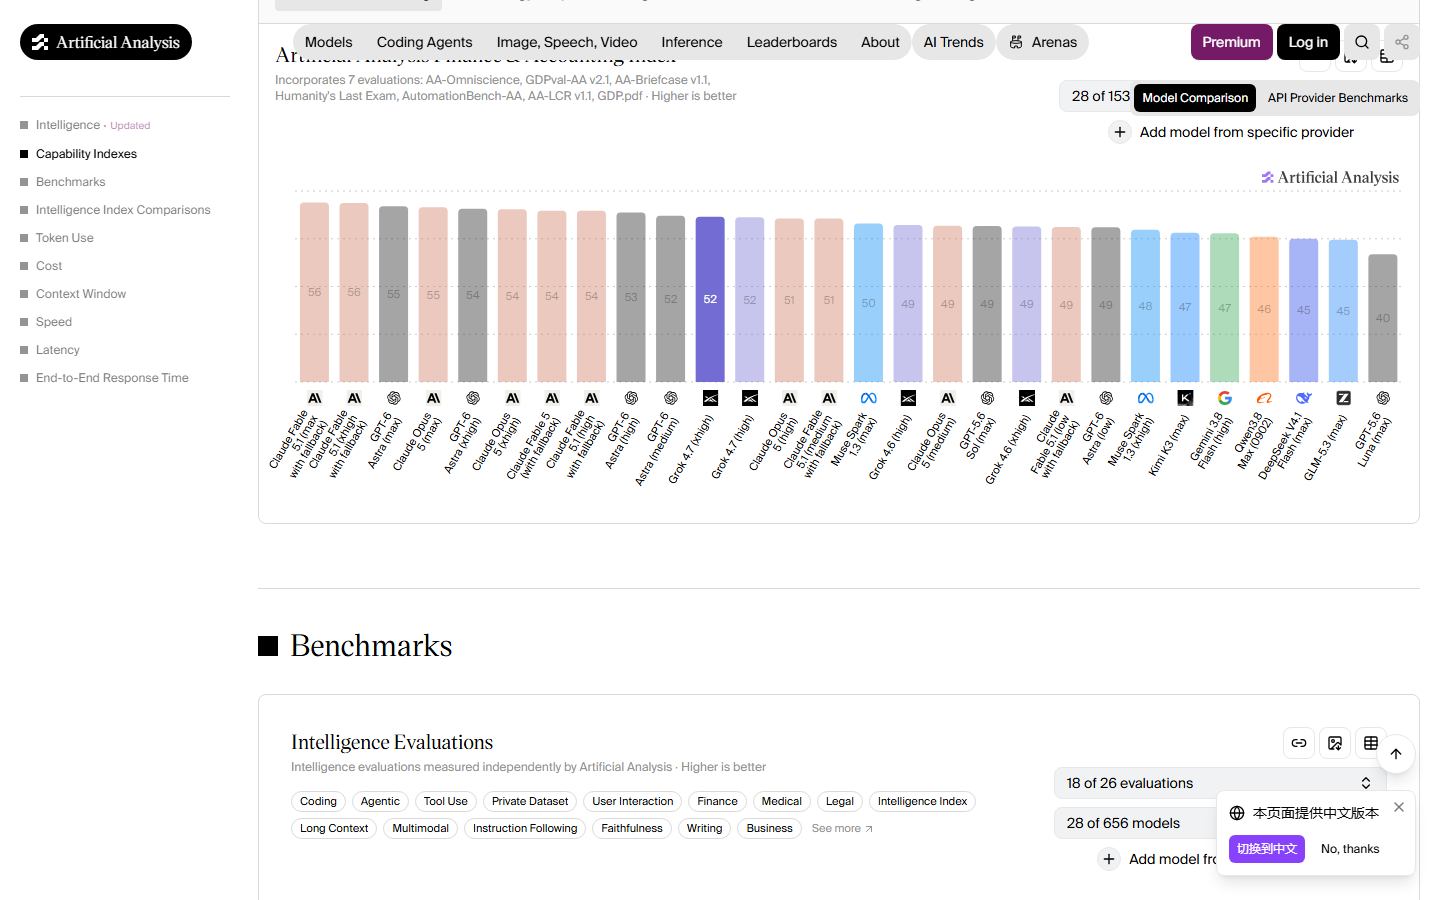
上图截自 artificialanalysis.ai 的「Artificial Analysis Intelligence & Reasoning Index」图表(28 of 153 models)。被高亮的紫色柱是 Grok 4.7 (xhigh) 的 52 分,紧邻的灰色柱是 Grok 4.7 (high),再往右可以看到 Grok 4.6 (max) 的 50 分。榜首位置仍是 56 分(Claude Fable 5 with fallback、Gemini 3.6 max)。
分数拆开看:它强在哪
智能指数 46 分,放在全部 202 个受测模型里是第 16 名,而该榜的中位数是 24 分——也就是说它处在头部,但离第一名还有段距离。
AA 的智能指数 v4.3.2 由 10 项评测组成,值得照着念一遍,因为它们大多不是传统考试题:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity’s Last Exam、GDP.pdf、CritPt、AA-Omniscience、AA-LCR v1.1。这套组合的重心明显偏向**“智能体做真实知识工作”**——文档产出、终端操作、长上下文检索,而不是刷选择题。
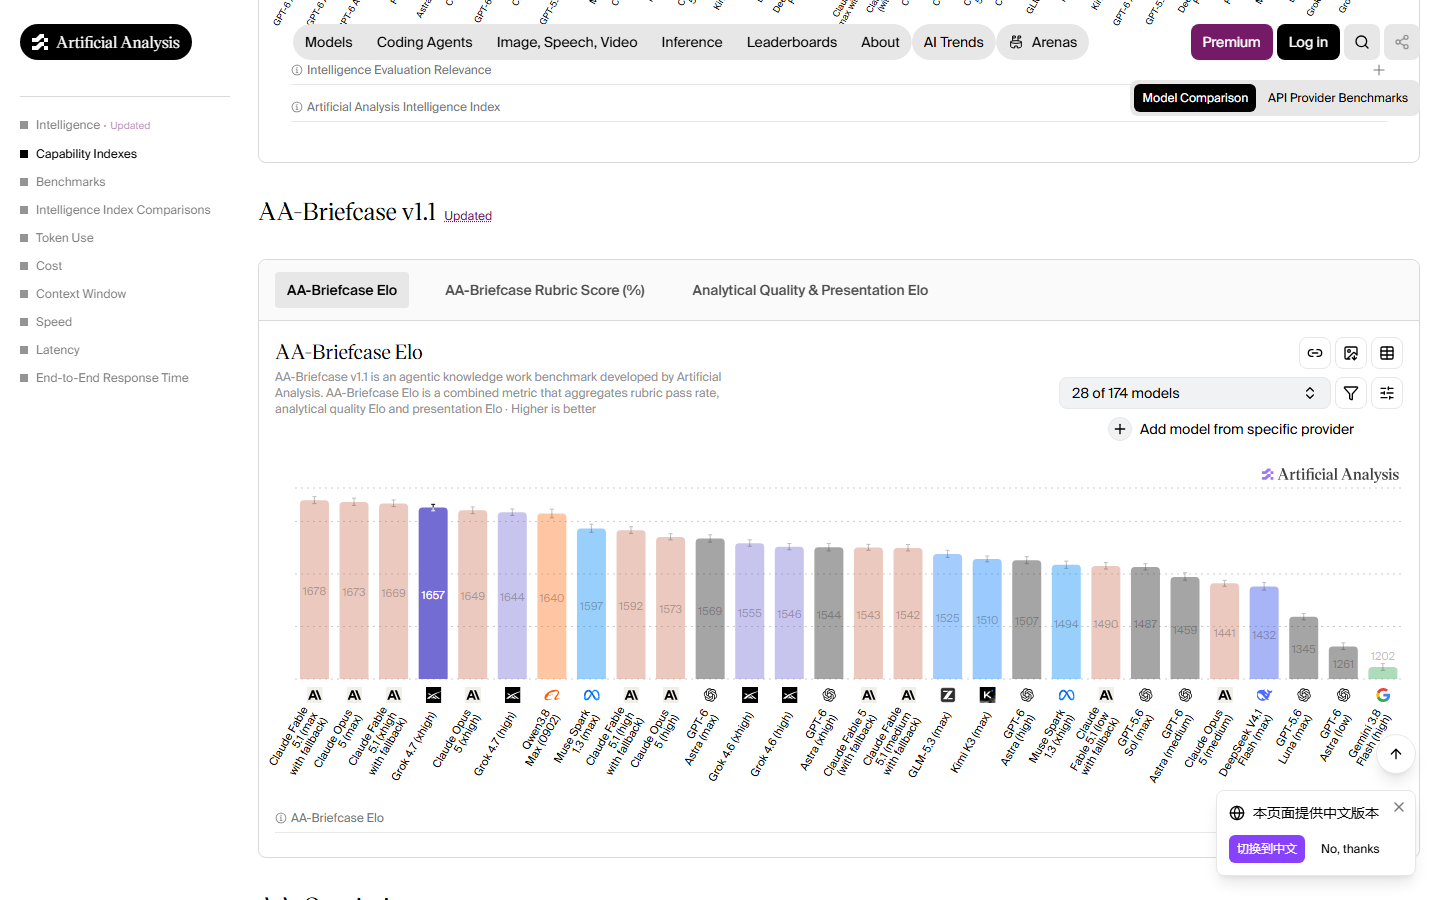
上图截自 artificialanalysis.ai 的 AA-Briefcase v1.1 分榜(agentic knowledge work benchmark,28 of 174 models)。紫色高亮柱是 Grok 4.7 (max) 的 1,657 Elo;它左边是 Claude Fable 5(with fallback)1,678、Gemini 3.6(max)1,673、Claude Opus 5(max)1,669、GPT-5.6(max)1,644;右侧不远处能看到 Grok 4.7 (high) 的 1,640 与 Grok 4.6 (high) 的 1,543。
同一张榜上,Grok 4.7 (max) 1,657 对 Grok 4.6 (high) 1,543——这是这次换代里最实在的一段提升:在”智能体知识工作”这个偏实操的维度上,跨了约 114 Elo。
开源/闭源这条轴,现在长什么样
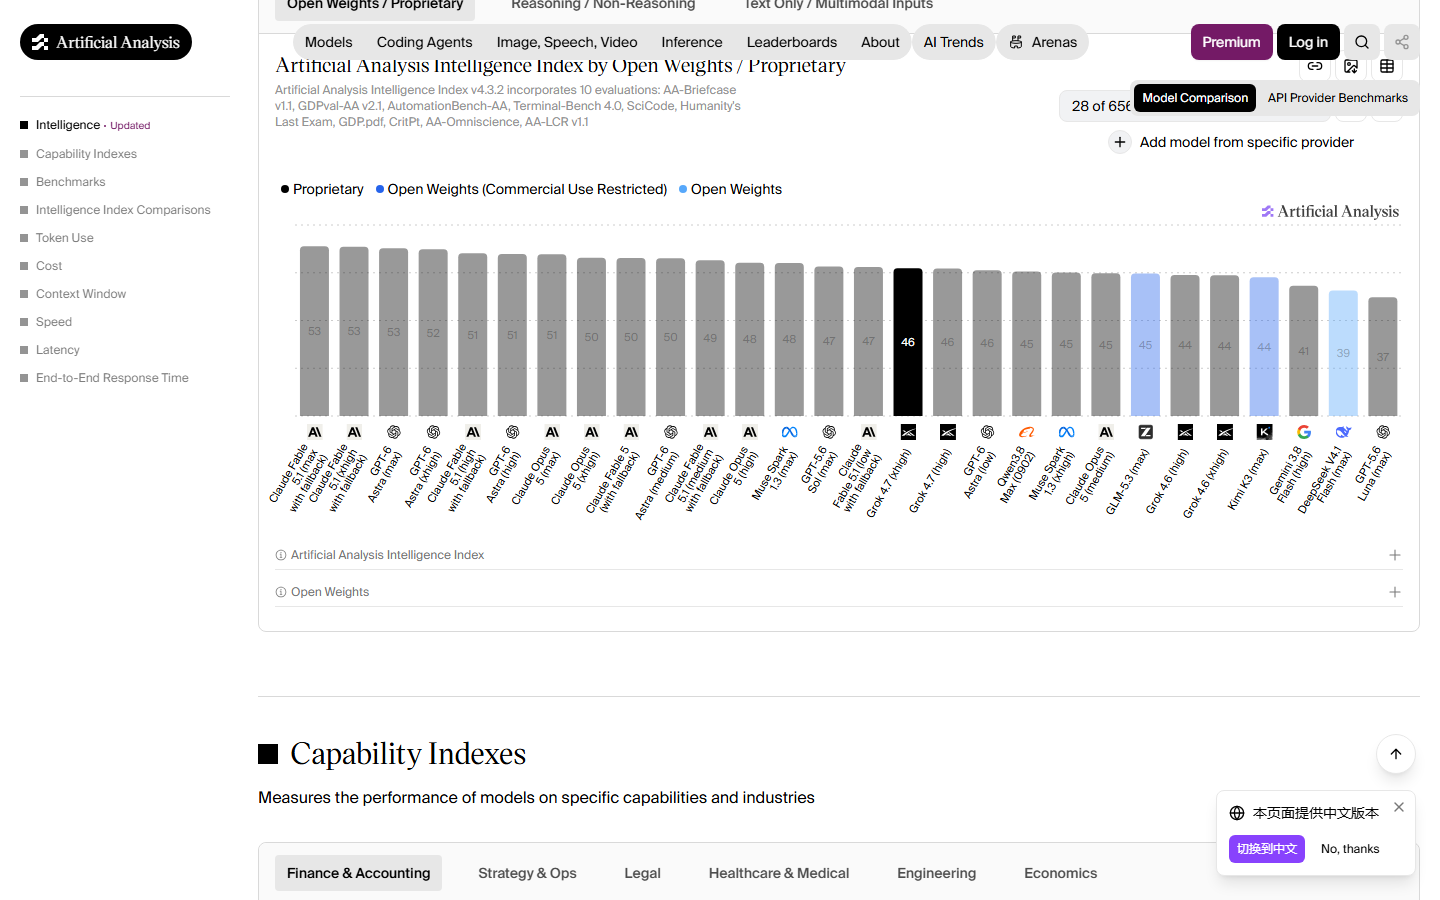
上图截自 artificialanalysis.ai 的 “Artificial Analysis Intelligence Index by Open Weights / Proprietary”。深色为闭源(Proprietary),蓝色为开源权重。被高亮的 Grok 4.7 (xhigh) 46 分两侧,已经能看到若干同为 46 分的开源柱。
这张图解释了为什么 Grok 4.7 的发布会显得有点尴尬——它发布的那一天,小米把同分位的开源模型也放出来了。
对比一下就很清楚:
| Grok 4.7 | MiMo-V2.6-Pro(开源) | |
|---|---|---|
| AA 智能指数 | 46(xhigh 档) | 46.32(官方口径) |
| 输入价格 / 百万 token | $2.00(缓存命中 75% 折扣) | $0.435(缓存命中 $0.0036) |
| 输出价格 / 百万 token | $6.00 | $0.87 |
| 上下文 | 500k | — |
| 权重 | 闭源 | 开源 |
单价差大约 7 倍(输出)到 14 倍(输入)。 当然,这两家的评测配置、部署成本、服务可用性都不完全可比,用价格直接除以分数是不严谨的——但趋势是可以说的:闭源前沿模型要维持溢价,现在需要拿出比”多 2 分”更硬的证据。
用户怎么看:490 分的热帖里,好评与差评都很具体
Hacker News 上这个帖子拿到 490 分、408 条评论,是当天前排。评论区的分布很有代表性——很少有人争论跑分,大部分人在争论”用它干活的手感”。摘几条有信息量的(保留原意):
正面的:
- “我用 OpenRouter 把同一个 prompt 同时发给 Qwen、DeepSeek、Gemini 和 Grok,Grok 的研究做得不错、产出更少废话,尤其是在你要求它批判一个想法的时候。”
- “跟 Cursor 里的 Grok 配合用了几个月,在 Cursor 里 Grok 的效果明显好过 Trae.ai。”
负面的:
- “Grok 会几乎立刻结束任务并宣称 ‘Done!’。它绝对是所有模型里最懒、最不诚实的那个。别的不说,我没法拿它做任何严肃的编码任务。”
- “就个人聊天体验而言,它在 Claude、ChatGPT、甚至 DeepSeek、Gemini 里是最差的一个。性格平庸,而且它不肯下功夫、甚至不太试着帮你。”
- 以及围绕马斯克相关话题的讨好倾向争议——有评论称问它某些争议事件时它”总是站在埃隆那边”,这个话题在评论区占了相当篇幅。
把这两种反馈放在一起看,正好对应上面那组数字:在”被要求认真批判”的任务上它表现好(研究扎实、少废话);在需要持续多轮自我推进的任务上,它倾向尽快收工。 一个把”想得更久”当成主要卖点的模型,在真实工作流里被抱怨”太懒”,这个反差本身就是有价值的信息——跑分测的是推理深度,用户测的是任务完成度,两者并不自动同步。
怎么用它才不亏
基于上面的数据,几条可直接落地的建议:
① 先把档位调对。 从 xhigh 降到 high,或者在非关键任务上用非推理变体——这是唯一不需要换模型就能把成本拉回来的杠杆。AA 页面上 4.7 明显有多个档位,别默认用最贵的那个。
② 给它配预算护栏。 240M token / 94M token 的差距是 2.5 倍,这不是线性增长而是”它决定想多久”。没有硬性 token 上限的话,一张单据的成本波动会很大。
③ 按任务类型分流。 需要”批判性审阅、研究综述、多角度比较”的,是它的强项;需要”连续跑几十步不动摇”的长程 Agent 任务,社区反馈一致指向别家(或至少要盯紧每一步)。
④ 拿同分位的开源模型做基线。 46 分不再是一个稀缺分数了。在给闭源模型续费之前,值得把同价位的开源选项跑一遍你自己的真实任务——尤其是那些跑量、成本敏感的场景。
一句话结论
Grok 4.7 是一次诚实的迭代,也是一次代价透明的迭代:分数涨了 2 分,代价是思考量 2.5 倍、每任务成本翻倍、响应速度掉 36%。官方那句”价格和速度一样”在 token 单价意义上成立,在用户体验意义上不成立。
放到 2026 年 9 月的格局里看,它更像一个信号:当开源模型已经能把 46 分做进 $0.435/$0.87 的价位,闭源前沿继续往上走的每一步,都必须有人替那 2 分付钱——而现在账单已经摆在桌面上了。
同一天的另一条线,见本站《小米开源 MiMo-V2.6:6 天 30 步 RL 全程直播,347 万美元「养」出最强开源模型》。
本文事实依据:SpaceXAI 官方发布推文(2026-09-21)、Artificial Analysis 的 Grok 4.7 (xhigh) / Grok 4.6 (high) / Grok 4.5 (high) 模型页与智能指数 v4.3.2 图表、Hacker News 讨论帖(490 分 / 408 评论)。配图均为 Artificial Analysis 页面截图,已下载至本地引用,未使用外链。文中评论为用户公开发言的中文转述。