一句话总结
2026 年 9 月 22 日,Anthropic 先发布 Claude Opus 5.5:官方称它在多数工作上达到 Claude Fable 5.1 的水平,而跑起来的综合成本比 Opus 5 低 40%,输出价格从 $25 降到 $20 / 百万 token。90 分钟后,OpenAI 发布 GPT-6 Sol 与 Luna,直接把 API 价格压到上一代的一半——Sol 输入 $2 / 输出 $10,Luna 输入 $0.10 / 输出 $0.50。这一天真正被争夺的不是跑分榜第一,而是**「每任务成本」这条曲线**。
数据来源:Anthropic 官方发布页《Introducing Claude Opus 5.5》(2026-09-22,含官方定价表与九项基准分数)、OpenAI 官方 GPT-6 Sol / Luna 发布页与官方定价表(2026-09-22)、TechCrunch 同日两篇报道(Russell Brandom 09:30 PDT / Lucas Ropek 11:00 PDT)。文中配图来源已逐张标注。
90 分钟:两场发布会挤在同一个上午
Anthropic 的发文时间是太平洋时间 9 月 22 日上午 9:30,OpenAI 是 11:00。两家正面对撞的间隔只有 90 分钟——这不是巧合能解释的排期,TechCrunch 在报道 OpenAI 那场发布时也把这一点单独拎了出来:“Anthropic released a new version of Opus 5.5 just 90 minutes before OpenAI’s release.”
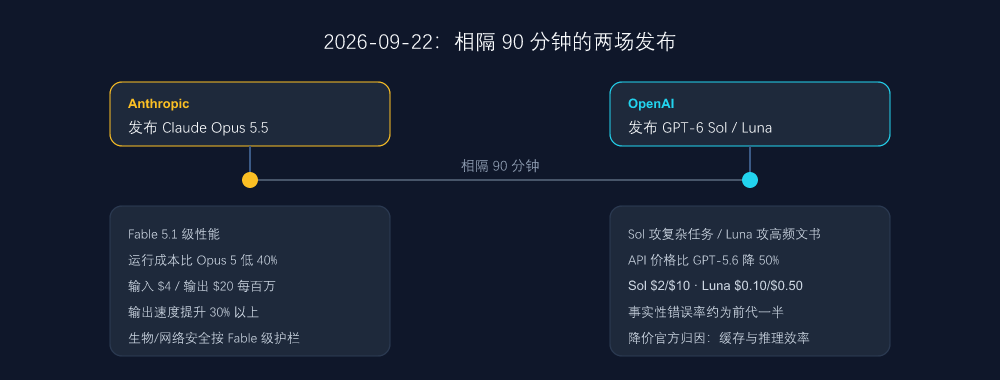
两家的叙事却出奇一致:上一代的能力,这一代的价格。
Anthropic 这边:把「成本」写进主线
Opus 5.5 是 Claude 5.5 家族的第一个成员。官方页面里最直白的一句是:“It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.” 注意这里说的是 40% less to run(跑起来的成本),不是单纯的单价——因为 Opus 5.5 不光更便宜,每个任务消耗的 token 也更少。
官方给出的定价表是:
| 项目(每百万 token) | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| 缓存读 | $0.20 | $0.50 |
| 输入 | $4 | $5 |
| 输出 | $20 | $25 |
| 缓存写 | $5 | $6.25 |
也就是说:输入输出各降 20%,缓存读降 60%——而缓存读恰恰是 agent 与编程类工作里占大头的那部分开销。官方还提到 Opus 5.5 生成输出比 Opus 5 快 30% 以上,另外提供一个最高 2.5 倍速的 fast mode($8 输入 / $40 输出)。
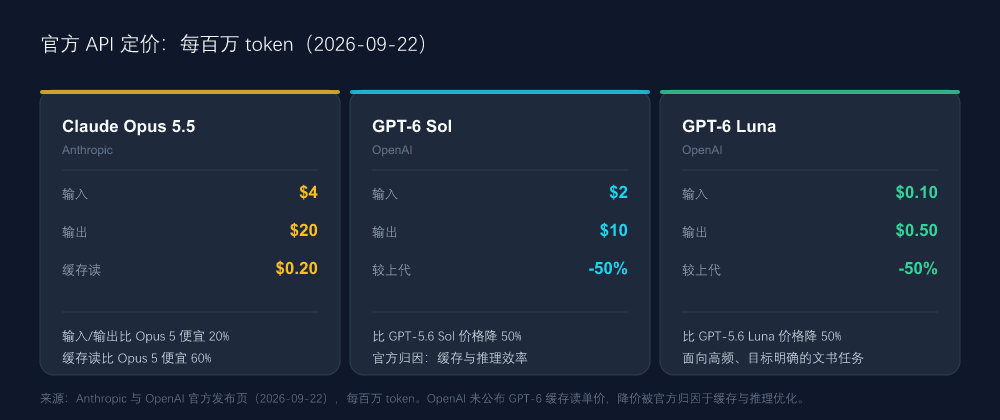
媒体侧的口径更简单一些:TechCrunch 写的是「输出 token 从 $25 降到 $20,其他指标有类似幅度的下调,模型跑起来也更快,反映服务它的总算力需求下降了」。
安全侧的一个变化值得单独记:Opus 5.5 是 Anthropic CEO Dario Amodei 公开主张「pacing the frontier」(让能力推进的速度不要超过对齐防护的速度)之后的第一个模型发布。官方说它在生物与网络安全能力上可类比 Claude Mythos 5.1,因此套用了与 Claude Fable 5.1 同级的防护;发布前由 METR、Frontier Design 等外部机构评估。Anthropic 同时表态:随着模型变强,公共政策应扮演更大角色,相关基础设施已在准备。
如果你在等中低端线:官方说 Claude Sonnet 5.5 与 Haiku 5.5 会在接下来几周跟进,带同类的性能、效率与安全改进。
OpenAI 这边:Sol 与 Luna 直接砍一半
OpenAI 的 GPT-6 Sol / Luna 定位沿用了今年早些时候的路线:Sol 打复杂任务(尤其编程),Luna 打「目标明确的高频文书活」——官方原话是 high-volume tasks with a clear goal, like summarizing documents, extracting information, or answering quick questions。
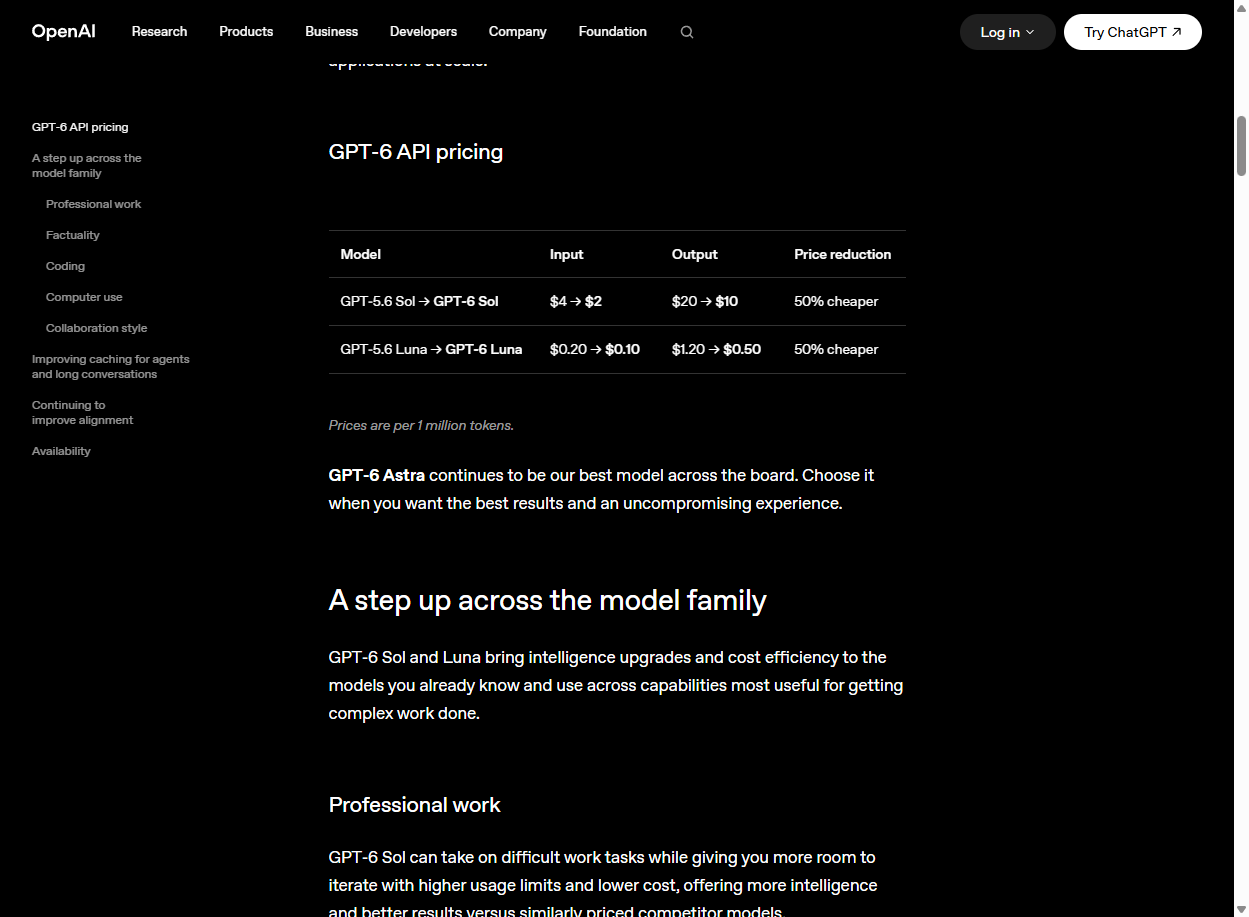
官方定价页写得很干脆(每百万 token):
| 升级路径 | 输入 | 输出 | 降幅 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 | $20 → $10 | 便宜 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10 | $1.20 → $0.50 | 便宜 50% |
OpenAI 把这次降价归因于缓存与推理效率的改进(同期官方还单独发了一篇《Better prompt caching for GPT-6》)。官方同时声称新版事实性更好:「在我们基于用户标记过错误的真实对话构建的事实性评测上,GPT-6 Sol 的错误数量约为前代的一半,以低得多的成本达到了 Astra 级可靠性。」
可用范围也划得很细:Sol 与 Luna 在 ChatGPT Work 和 Codex 里对多数付费账户开放,同时上线 ChatGPT API;Luna 还会进桌面端,面向 Free 与 Go 用户。官方在定价页上还注明了一句:「GPT-6 Astra continues to be our best model across the board」——需要最佳结果时仍然选 Astra。也就是说,Sol / Luna 的官方定位是把 Astra 级能力做得更便宜,而不是把能力上限再抬一档。
跑分:领先,但绝不是「全面领先」
Anthropic 官方给了一张九项基准的对照表。我把 Opus 5.5 与两位对手(GPT-6 Astra、GPT-5.6 Sol)的关键项单独拎出来:
| 基准 | Opus 5.5 | Fable 5.1 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0(智能体编程) | 66.4% | 55.8% | 57.9% | 37.3% |
| FrontierCode v1.1(主) | 54.4% | 50.3% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | — | 41.7% |
| GDPval-AA v2.1(知识工作) | 1846 | 1735 | 1542 | 1588 |
| Humanity’s Last Exam(带工具) | 67.7% | 65.6% | 57.2% | — |
| OSWorld 2.0(电脑操作) | 81.8% | 80.7% | — | — |
| AutomationBench(业务工作流) | 40.0% | 31.4% | 41.4% | 28.8% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 64.6% | 22.4% |
这里必须把 nuance 写清楚:Anthropic 自己给这张表的定语是「在我们自己的基准上,Opus 5.5 在智能体编程、电脑操作、知识工作上领先」,并且官方主动补了一句——「在这个能力水平上,基准分差已经不再是现实差异的可靠指引」,在他们自己的使用中,Opus 5.5 与 Fable 5.1 的差距比分数显示的更小。
同时这张表里有两项不是 Opus 5.5 第一:业务工作流基准 AutomationBench(由 Zapier 跑并公布)Opus 5.5 是 40.0%,GPT-6 Astra 41.4%;智能体科研基准 Terminal-Bench-Science 0.1 是 GPT-6 Astra 的 64.6% 对 Opus 5.5 的 58.7%。另外 Anthropic 也注明:Opus 5.5 是在生产防护开启的情况下评测的,遇到防护介入时,网安任务改由 Opus 4.8 完成、生物与前沿 LLM 开发任务改由 Opus 5 完成——这会拉低它在这几项上的分数。
真正没有争议的地方在成本侧,Anthropic 举的例子是:在 FrontierCode 上以默认 effort,Opus 5.5 以大约 20% 的单任务成本击败 GPT-6 Astra;在 Terminal-Bench 4.0 上以约 40% 的成本打平 Astra;在 CursorBench 上以约三分之一成本领先 GPT-5.6 Sol 11 个百分点。
同一天:同一个工作流,成本差 11 倍
OpenAI 在发布材料里也放了一张 AutomationBench 的成本-得分图(数据由 OpenAI 公布,条形长度按单任务成本,以 GPT-6 Sol xhigh = 1x 归一化):
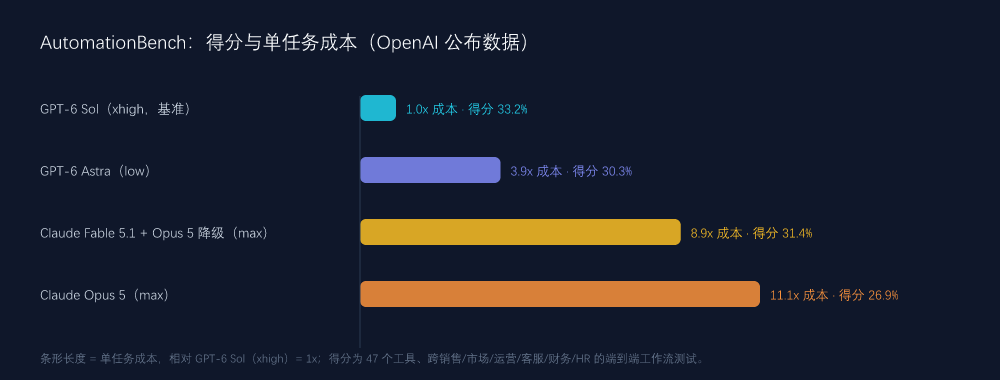
按这张图,同一个端到端工作流(47 个工具,覆盖销售、市场、运营、客服、财务、HR)上,GPT-6 Sol(xhigh)以 1x 成本拿到 33.2 分,而 Claude Opus 5(max)要花 11.1 倍成本才拿到 26.9 分。这个数字和 Anthropic 自己的表格(Opus 5.5 40.0% / Opus 5 26.9%)在旧模型的分数上是对得上的——也就是说,两家的表格讲的其实是同一件事:Opus 5 那一代又贵又慢,这一代双方都在把它打下来。
对普通用户的含义很直接:过去一年里「更强的模型 = 更贵的账单」这条等式,正在被两家同时改写。 你的 agent 能不能常驻跑、能不能从「按需调用一次」变成「每个流程都挂一个」,取决于的不是跑分榜,而是上面这几张价格表。
给不同人的实际结论
如果你在跑编程类 agent:这一轮的赢家是成本,不是能力。Opus 5.5 的缓存读从 $0.50 掉到 $0.20 是对 agent 场景最实质的一条降价(agent 的 token 消耗绝大多数发生在缓存读),配合官方说的「每任务 token 更少」,长会话类工具的账单会有肉眼可见的变化。
如果你在做高并发文书类处理(摘要、抽取、分类、客服问答):GPT-6 Luna 的 $0.10 / $0.50 是这一轮里最激进的一档,官方明说它就是为「目标明确的高频任务」设计的。这类场景原本的取舍是「小模型便宜但错得多」,OpenAI 这次给的卖点正是「错误率约为前代一半」。
如果你只是普通用户:短期内体验到的变化不会是「AI 突然变聪明」,而是订阅额度更耐用(Anthropic 明确说提高了 Pro / Max / Team / 企业版的五小时用量上限,并给了可自行保存使用的 rate limit reset;OpenAI 说 Luna 会覆盖 Free 与 Go 用户)。
唯一要警惕的是:两家的「更便宜」都建立在自己的口径上——Anthropic 的 40% 是综合单价与 token 效率的合并结果,OpenAI 的 50% 是相对 5.6 系列的促销价。真实的账单差异只能用自己的负载去测,别拿发布会的百分比当预算。
数据来源
- Anthropic 官方发布页《Introducing Claude Opus 5.5》(claude.com / anthropic.com,2026-09-22):性能与成本说明、九项基准对照表、官方定价表、Opus 5.5 System Card 引用、Sonnet 5.5 / Haiku 5.5 排期、Life Sciences / Cyber Verification Program 说明。
- OpenAI 官方 GPT-6 Sol / Luna 发布页与官方定价表(openai.com,2026-09-22):两档模型定位、50% 降价与归因、内部事实性评测口径、可用范围;以及同期官方文章《Better prompt caching for GPT-6》。
- TechCrunch:《Anthropic releases Opus 5.5 with lower prices and Fable-level performance》(2026-09-22 09:30 PDT,Russell Brandom)、《OpenAI launches GPT-6 Sol and Luna, boasting lower cost and fewer mistakes》(2026-09-22 11:00 PDT,Lucas Ropek):90 分钟间隔、价格变化幅度、pacing the frontier 背景。
- 配图来源:
opus-55-official.png与gpt6-sol-luna-official.png、gpt6-official-page-pricing.png为两家官方发布页与定价页的真实截图;gpt6-vs-opus-55-price-war-2026.png(封面)、gpt6-opus55-timeline-2026.png、gpt6-opus55-pricing-2026.png、gpt6-opus55-cost-bench-2026.png为本站依据上述官方数据自制的示意图。
⚠️ 本文中的基准分数均为厂商自报,评测条件、effort 档位与 harness 各不相同,不可直接横向等同。需要真实结论时,请用自己的任务集复测。