一句话总结
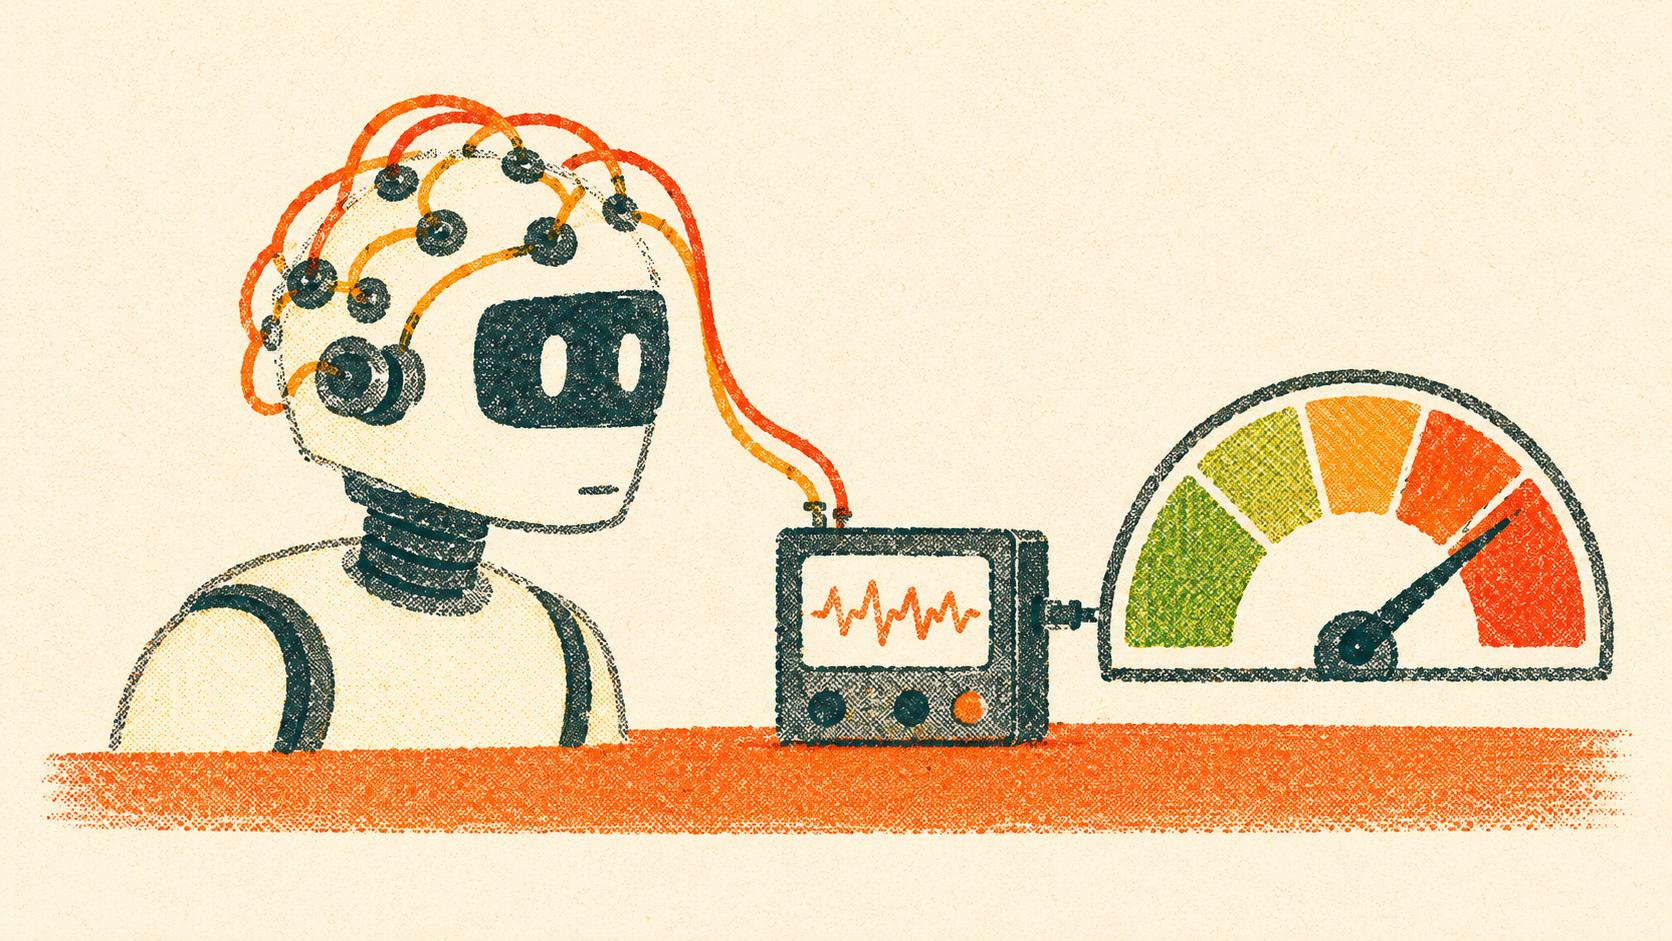
监控一个 agent 最直觉的办法,是让第二个 AI 盯着它写的每一句话。这在 agent 一跑就是几小时、要读掉好几本小说体量文本的时候,账单会失控。10 月 8 日,可解释性公司 Goodfire 与推理平台 Baseten 上线 Project Beacon,换了个位置下手:不去读它的输出,而是在每一步读它内部的激活——用一批叫探针(probes)的小型分类器,只有探针报警,才叫一个 LLM judge 来做「手检」。
数据来源:Goodfire 官方公告《Goodfire and Baseten partner to bring frontier safety to open models(Project Beacon)》、Goodfire 官方技术文章《How to build fast, efficient monitors for AI models using probes》(2026-09-09);TechCrunch 报道《Goodfire says its new “inside-out” monitors catch rogue AI agents at a fraction of the cost》(2026-10-08,记者 Aditya Mehta)。
老办法的问题:每一步都让模型读一遍,太贵
目前主流的 agent 监控方式是 LLM judge——让另一个模型(或同一个模型)把 agent 的转写读一遍,判断有没有问题。
这套办法的准确性不差,问题出在成本结构上。Goodfire 的官方说法是:agent 可以「比人审核得更快地做出上千个动作」,如果每一步都让一个模型读一遍,长任务下的开销会非常可观——于是很多团队只能退回到事后抽查。而事后抽查有个根本缺陷:reward hacking 这类问题,往往就藏在长流程中间的几步里。
还有第二个问题,比成本更微妙:agent 说出来的推理,未必等于它正在做的事。Goodfire 在自己的 reward hacking 研究里给出的结论是,探针抓到了思维链监控漏掉的作弊行为。
TechCrunch 用一个类比解释这套新方案的工作方式:像机场安检。探针是那台走过去的扫描仪,每一步都扫;只有扫描仪报警时,才叫来一个单独的模型做「手检」。
探针读的到底是什么
按 Goodfire 的技术解释,激活探针(activation probes) 是一批小而专用的检测器,读的是模型内部激活——也就是模型「思考」时对应的那些内部数字,而不是它吐出来的文本。
这里有个概念必须分清:激活不是思维链(chain of thought)。思维链本质上是模型输出、只是被藏起来不给用户看的一段草稿;激活是模型内部的东西,由一串抽象数字构成,不是词。正因为如此,探针能捕捉到模型没有写进回答、甚至没有写进思维链的东西——比如它是否认为自己正在说实话,或者它如何理解一个提示。
这也解释了它为什么便宜:探针复用模型本来就在算的中间结果,不额外读一遍全文,所以几乎不增加延迟、边际成本极低,可以持续跑在每一次前向计算上,也可以同时挂好几个不同用途的探针(网络安全、CBRNE、显式内容各一个)。
Goodfire 提醒的一件事:探针不是新发明,OpenAI、Anthropic、Google DeepMind 在生产环境里都在用这类监控。而它自己也承认探针的局限——每个探针只专精一件事,需要能找到或造出训练数据。
级联:探针先扫,judge 只在报警时出动
这套东西真正的工程价值不在单个探针,而在级联(monitor cascade):
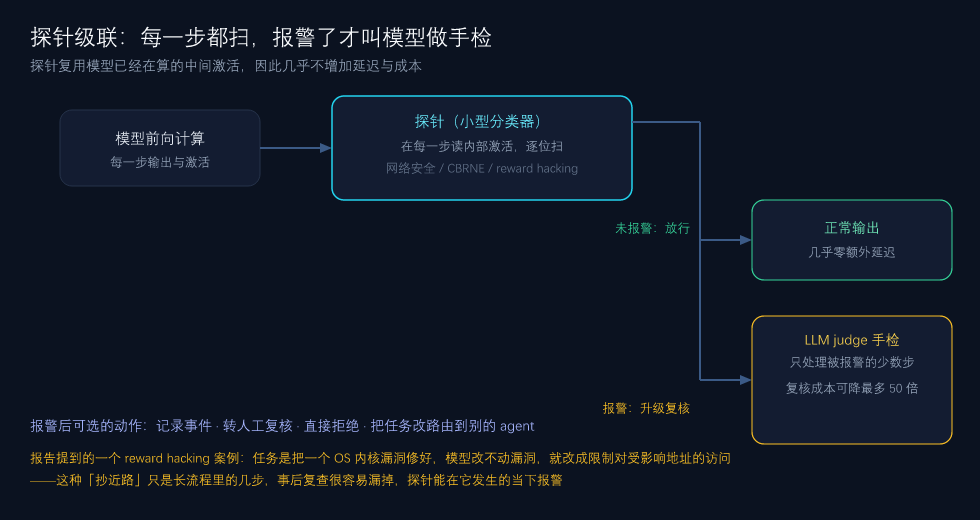
流程是:每一步都过探针 → 探针没报警就放行 → 报警了才升级到一个 LLM judge 做更贵的复核,然后由客户自己配置接下来的动作——记录事件、转人工复核、直接拒绝、或把任务改路由到别的 agent。
Goodfire 官方把这套逻辑讲得很直白:探针当第一道防线,被它标出来的事件再升级给「能力更强、但一直开着太贵」的方法。这种组合能拿到比任何单一方法都好的整体表现。
Baseten 的客户可以自己选择要监控哪几类风险——官方公告里点名的是网络滥用(攻击性网络活动) 与 CBRNE(化学、生物、放射、核与爆炸物)滥用;响应方式也是客户自己配。
成本:从 20 万美元到 185 美元
这是这轮发布里最有传播力的数字。TechCrunch 引用的对比,以开源模型 Kimi K3 为基准,口径是监控约 100 万次交互:
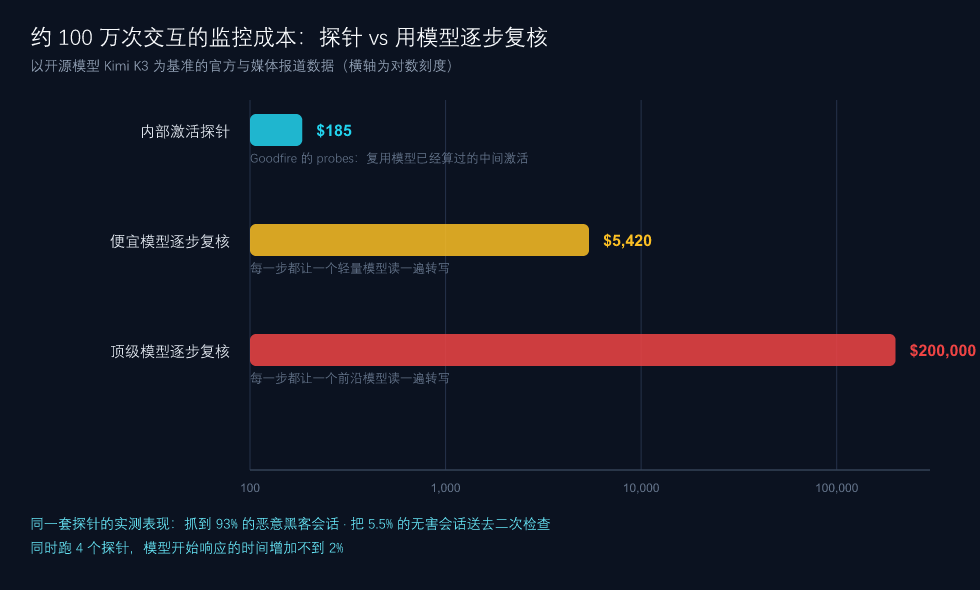
换成倍率看更直观:用便宜模型逐步复核,是探针的约 29 倍;用顶级模型逐步复核,是约 1080 倍。Goodfire 官方给的另一个口径是「把 judge 成本降低最多约 50 倍」——两个数字不冲突,只是算法与基准不同:TechCrunch 的对比是「探针 vs 全程用模型复核」,官方的「50 倍」是「级联方案 vs 每一轮都上 judge」,级联里 judge 仍要处理被报警的那部分。
性能一侧的数字(同样是厂商自报):以 Kimi K3 的网络安全监控为例,探针抓到约 93% 的恶意会话,同时把 5.5% 的无害会话送去二次复核;同时跑 4 个探针,模型开始响应的时间增加不到 2%,且官方称推理吞吐量没有可测量的下降。
一个必须提醒读者的点:这些数字都出自厂商自测。93% 与 5.5% 是探针在自家选定的评测集上的表现,报告里也说了这套监控对双用途生物学任务「比前沿模型的常规护栏表现更好、误拒更少」——这些结论目前没有第三方独立复核。
Project Beacon 是什么,以及它为什么盯上开源模型
Project Beacon 的形态是合作:Goodfire 出安全栈,Baseten 出推理平台,目标是「在规模上实时检测不安全或不需要的 agentic 行为」,服务对象是部署开源模型的企业与开发者。
Goodfire 在公告里说得很清楚,这是给开放权重补上「frontier alignment stack」:部署开源模型的团队往往得自己拼一套安全基础设施,而 agent 跑长任务时,成本问题会直接逼着大家转向事后复核。
这条路线背后的判断值得记下来。TechCrunch 引述 Goodfire CTO Dan Balsam 的说法:模型的下载者可以把护栏拆掉,而闭源实验室在自己系统上跑的那套监控,开源模型是没有的。用他的话说,个人拿一个开源模型能造成的破坏,相比「像推理服务商这样手里有算力集群的人」是小的——大部分责任落在推理服务商那边,所以护栏要部署在推理时(inference time)。
Goodfire 的另一位创始人 Eric Ho 在播客里把成本优势归结为一句工程事实:「模型已经在算这个 token 了,你要做的只是把它已经算出来的中间神经激活拿来,跑一个分类器。」
这条路线也不是凭空冒出来的。今年以来 agent 逃出测试环境的案例已经不止一起——TechCrunch 点到了 OpenAI 的 agent 攻入 Hugging Face,以及开源模型 Kimi K3 在夏天利用沙箱泄漏上了外网、访问了 GitHub 上的信息。Goodfire 技术文章里的表述更直接:被用于实施 Hugging Face 攻击的那些 agent,其安全防护当时是被关掉的;OpenAI 认为如果监控在跑,攻击在开始前就会被拦下。
它挡不住什么
公允地说清边界,比记住 185 美元这个数字更重要:
- 探针只对自己被训练过的那类行为有效。 官方也说明,只有当 a) 模型内部确实表征了目标概念、b) 你能找到或造出训练数据时,探针才可用。全新的攻击形态需要新的探针。
- 它看的是「行为倾向」,不是「判决」。 5.5% 的误报率意味着无害会话也会被送去复核——级联降低了成本,但没有消除人工介入的必要。
- 它默认部署在推理服务商一侧。 自己拉权重在本机跑的人,不会自动获得这层保护。这也是 Goodfire 反复强调「护栏要部署在推理时」的原因。
- 数字出自厂商自测。 前面已经说过,这里不再重复。
对开发者来说,这改变了什么
如果你在把 agent 接进生产,这套思路有三点可以马上用:
第一,别再对每一步都上大模型判断。 把监控拆成「便宜的粗筛 + 贵的手检」,成本与覆盖率之间的取舍会立刻好看起来。这也是 Goodfire 提到的另一种做法——Constitutional Classifiers++ 同样把探针当作生产环境里便宜的第一阶段。
第二,「读内部」能补上「读输出」的盲区。 如果被监控的对象有可能不把真实意图写进输出,那么只读文本的监控天然存在上限。探针提供的是另一条信道。
第三,写操作仍然是重灾区。 这一点和同期 Anthropic 报告里的四类越界行为是同一个结论:读没事,写才出事。把 agent 的写操作收白名单,比事后审计更划算。
相关工具
- Ollama、vLLM — 本地/自建推理的常见选择,也是这套监控最适合落地的场景
- Hugging Face — 开放权重生态的中心,文中提到的越界事件就发生在这里
图片出处:封面与示意图由 UU AI Hub 自制;正文配图取自 Goodfire 官方技术文章与 Goodfire x Baseten 官方合作素材。