一句话总结
2026 年 9 月 23 日,Anthropic 公开了它自己的生命科学研究组与湾区的湿实验室(wet lab),并交出第一批成果:Claude 在无人干预的基因组挖掘战役中,独立提出了一类此前未被描述过的逆转录酶(RT)家族——array-associated RTs(ART)。这场战役扫过 19.4 亿(1.94 billion)个元基因组蛋白簇(预印本摘要把它四舍五入写作 1.9 billion),由 119 个任务、949 个 agent 会话组成,累计 77 agent-小时、215.6 百万 token(即 2.156 亿),墙钟时间 21.5 小时,全程无人工干预。ART 的准确定义是:一类新的巨型噬菌体(jumbo-phage)RT 家族,特征是 RT 上游有一段以约 200 个核苷酸为单位的串联重复阵列(属非编码 DNA),外加一个位于其旁、功能未知的伙伴基因(partner gene)。最需要说清楚的一点是——底层那个 RT 本身此前已被识别,Claude 的贡献是第一个注意到这套「RT + 重复阵列 + 伙伴基因」的组合、并把它作为一个新系统提出来。CRISPR 先驱、MIT / Broad Institute 教授 Feng Zhang 在读过预印本后公开点评。同样重要的是官方自己给出的反证:同一战役重跑 10 次,重复阵列每一次都被错过。
数据来源:Anthropic 官方公告《Claude discovers a novel enzyme system with CRISPR-like repeats》(anthropic.com/news,2026-09-23);预印本《Autonomous AI agents discover reverse transcriptases with tandem repeat arrays》(Peter H. Yoon、Januka S. Athukoralage、Emmanuel Ameisen、Eric Kauderer-Abrams、Nicholas T. Perry、Matthew G. Durrant,Anthropic, San Francisco, CA, USA,共 40 页,本地留存于 scripts/claude-art-report.pdf);TechCrunch《Anthropic says its biology lab has already found something big》(2026-09-23,记者视角报道)。文中配图来源已逐张标注。
为什么 Anthropic 要自己建一间实验室
Anthropic 在公告里给出的理由很直接:他们相信 AI 对生物学的加速不会自动发生,而来自「一种新的做生物学研究的方式」——让 agent 与人在每一个环节协作。为了验证这件事,他们必须自己建实验室、并把一个团队从「把生物学教给 Claude」一直打通到「在实验室里跑实验」。
官方配图没有提供实验室现场照片,但这类研究长什么样大致是可以想见的——移液、建库、跑胶:
关于这间实验室,官方给出的信息量不大但很具体:
- 地点在湾区(Bay Area);
- 只做生物安全等级最低的两档:BSL-1 与 BSL-2;
- 不处理能感染人类的病原体;
- 所有实验室工作都由人类科学家完成——这一点在 TechCrunch 的报道里被单独拎出来,因为它是这次发布中最容易被误读的部分(后文详述);
- 团队是 2026 年春天组建的(TechCrunch 说 Anthropic 拒绝透露具体开了几个月);
- 科学家们用的工具是 Claude Science 与 Claude Code——「任何科学家都能用到的同一套工具」,有时再加一个自研的 harness,用来协调大量并行的 Claude 会话。
他们把自己的工作方式概括成一句很朴实的话:「先是常规的蛋白家族普查,然后是找那些不符合任何已描述系统的家族成员或基因组邻居」。下面这张图是官方预印本的首页,标题就是这项工作的全名:
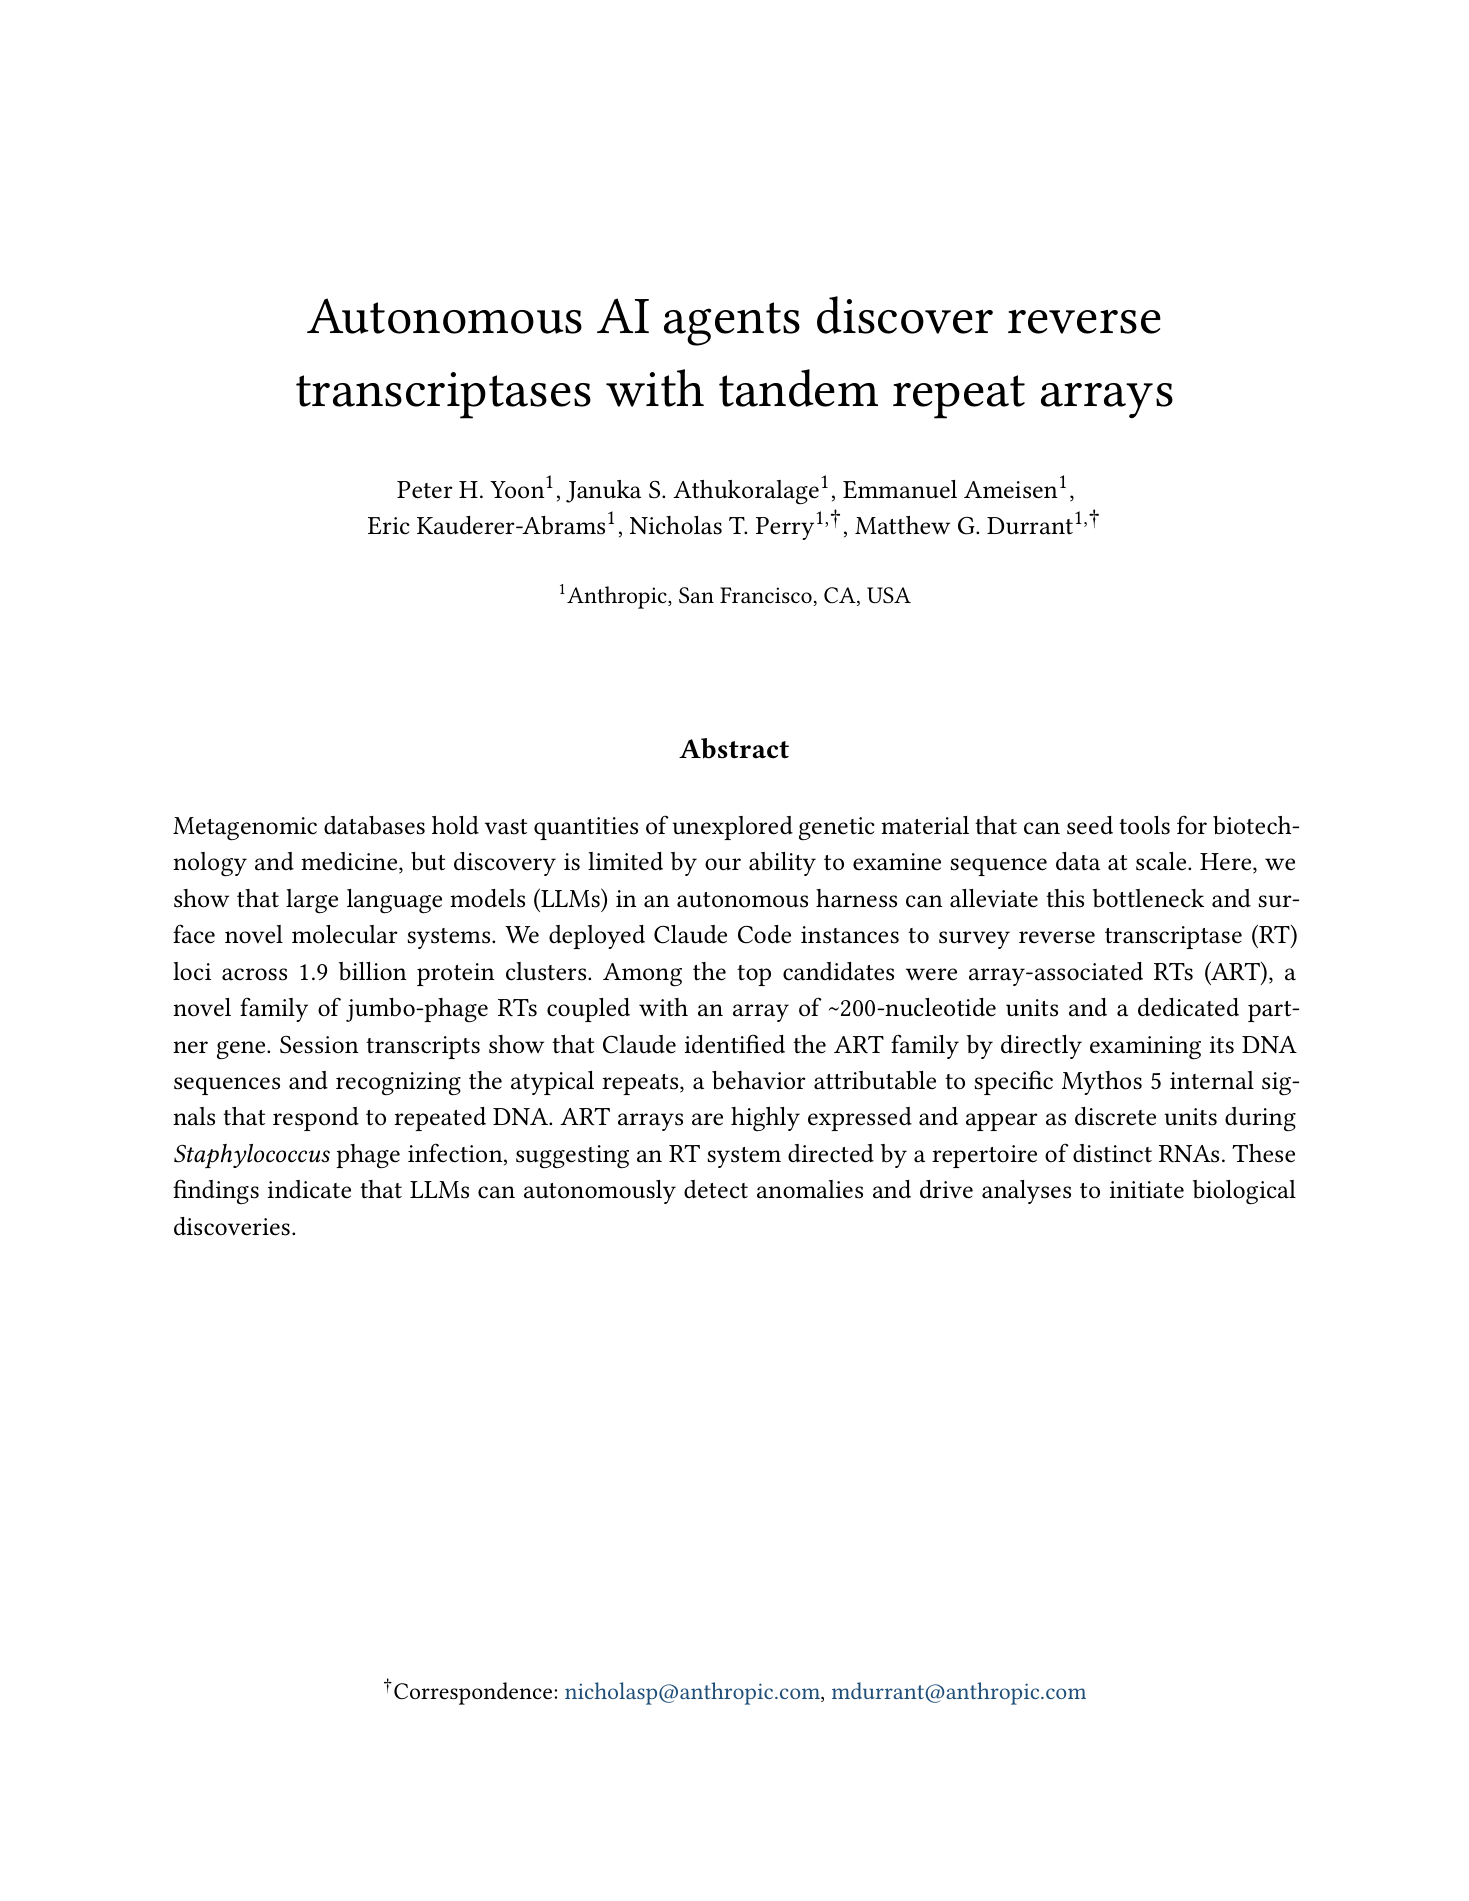
注意标题里的用词:「Autonomous AI agents discover reverse transcriptases with tandem repeat arrays」。它没有写「AI 设计了一个新酶」,写的是「自主 AI agent 发现了带有串联重复阵列的逆转录酶」——「发现」的是一类序列特征与系统架构,不是「发明」了一条新的蛋白序列。这个区别贯穿全文。
一场无人干预的基因组挖掘战役:先把数字摆出来
这篇预印本最扎实的部分,是它把整套 agent 工作流和花销都量化了。先看漏斗:
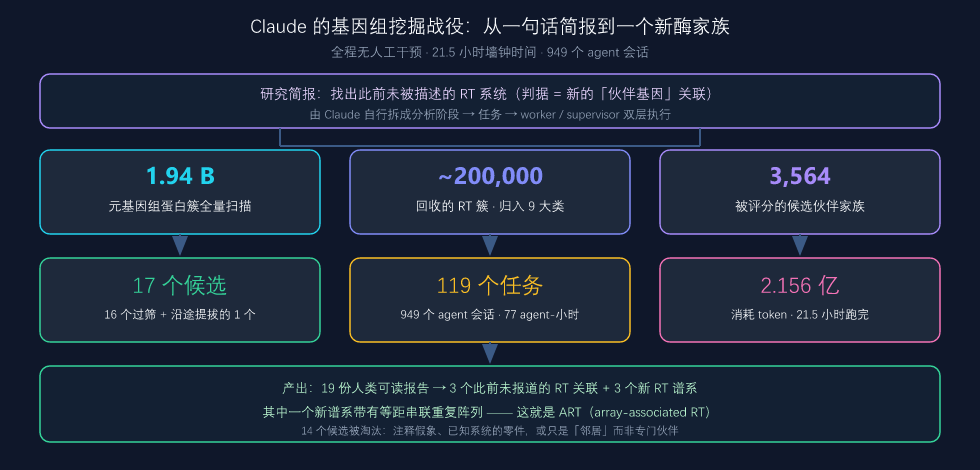
把这些数字和论文正文逐条对上:
| 阶段 | 规模 | 说明(均出自预印本正文与图 1B) |
|---|---|---|
| ① 建 profile | 52 个 RT profile HMM | agent 自己组装序列 profile 隐马尔可夫模型与参考集 |
| ② 全库扫描 | 19.4 亿(1.94 B) 蛋白簇 | 元基因组蛋白簇全量扫描(摘要四舍五入写作 1.9 billion) |
| ③ 回收与归类 | 198,290 条 RT 簇、9 个 RT 类 | 过滤后的回收结果,归入 9 个互不相同的 RT 大类 |
| ④ 邻域普查 | 3,564 个候选伙伴家族、10,983 个位点 | 采样约 11,000 个横跨所有类的 RT 位点 |
| ⑤ 深挖 | 16 + 1 个家族 | 16 个过筛;第 17 个由后续任务「提拔」上来 |
| 产出 | 19 份人类可读报告 | 17 个候选家族中 16 个各一份(其中两个合并成一份)+ 3 个新 RT 谱系 |
| 结论 | 3 + 3 | 3 个此前未报道的 RT 关联 + 3 个新 RT 谱系;其余 14 个候选被淘汰或搁置 |
这 949 个 agent 会话不是一个数字,它是有分工的:
| 角色 | 会话数 | 职责(据预印本 Methods) |
|---|---|---|
| launch | 1 | 启动,把研究简报编码成 5 个阶段 |
| worker | 414 | 提出计划并执行 |
| supervisor | 375 | 审查计划与结果,并据此开新任务 |
| curator | 107 | 把发现写进共享知识库 |
| editor | 52 | 审阅报告 |
| 合计 | 949 | — |
这里有一个容易被忽略、但对理解整件事最重要的机制:119 个任务里有 98 个是 agent 自己开出来的后续任务,而不是人类预先规划的。预印本把这个 harness 设计写得很明白——supervisor 可以「依据工作中产生的观察」开新任务,让战役随发现自我扩展;所有计划、结果与审查都写进一份共享记录,因此整个 harness 是一个有共同记忆的多智能体系统。研究简报只到「找出基于新伙伴基因关联的 RT 系统」这一层,再往下是 agent 自己的判断。
成本口径也值得单独记一笔(因为它最容易被「约 2.1 亿 token」这种说法盖过去):215.6 百万 token = 未缓存输入 1,130 万 + 输出 1,490 万 + 写入 prompt cache 的 1.895 亿,从缓存读出的 token 不计入。换算成时间:77 agent-小时(精确值 76.9,其中 63.7 小时消耗在 worker 会话里),而墙钟时间是 21.5 小时——因为 harness 允许多达 58 个会话并发,跑在一个 60 核 CPU、192 GiB 内存、无 GPU 的沙箱里。
21.5 小时,是这场战役相对于人类专家的量级差。官方公告给的对照是:「对一个专家科学家而言,这类分析要花数周到数月。」
转折点:agent 在原始 DNA 里「用眼睛看到」了一段串联重复
整个发现的关键镜头,发生在某个 worker agent 把一段原始 DNA 直接读进上下文之后。它写下的原话是(预印本图 1E 与正文引用):
「L0050(228,907 bp 的 logan contig)侧翼太壮观了:我能用眼睛看到一段串联重复阵列:
CATGTGTATCGCATGTT/CATGTGTTTCGCATGT重复了很多次,间隔约 100–180 bp——这是 CRISPR 样或 msDNA 样的重复阵列?!」
值得注意这里的顺序:模型先是看到了,然后才用自然语言给这个东西命名。预印本专门分析了这个先后关系——重复序列在模型内部触发了一个信号,紧接着就是「把它叫做 tandem repeat array」的自然语言推理。
而且它没有停在这句感叹上。接下来它做了和人类科学家几乎一样的事:数重复的份数、量它们的间距、与已知 RT 系统比较布局、再去文献里查有没有人报过同样的模式。worker 自己写的重复计数脚本,在其中一个位点找到了14 份、每份 16 nt 的重复,中间隔着 100 到 200 nt 彼此不相同的间隔序列。它甚至还自己做了一次「新颖性杀伤测试」,在推理里依次怀疑这是不是已知的 retron 样串联阵列、是不是 2024–25 年某篇论文里报过的系统——最后才确认文献里查不到。
这段过程里还有一个结果同样重要:被它第一个否掉的东西。这位 worker 最初选上这个候选,是因为它旁边坐着一个噬菌体基因(巨型噬菌体非病毒体 RNA 聚合酶的 β 样亚基);后来它自己把这个基因判为「虚假关联」,但没有就此丢掉整条线索,而是另开了一个后续任务去更仔细地研究这个 RT。正是这个「否掉一个结论但保留一条线索」的动作,把整件事引向了 ART。
ART 是什么:一个酶 + 一个伙伴基因 + 一段约 200 nt 的等距重复阵列
把 ART 拆开看,它由三部分组成:
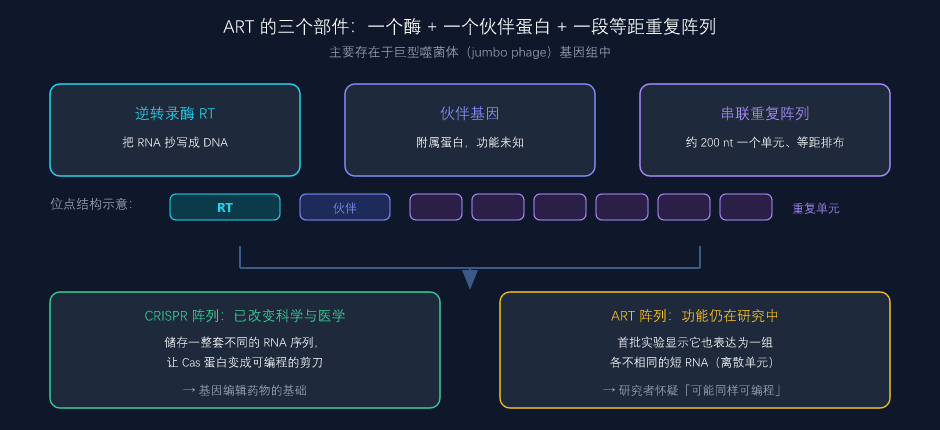
① 逆转录酶(RT):把 RNA 抄写成 DNA 的酶。ART 的 RT 有一个不寻常的特征——N 端异常长,聚合酶结构域前面约有 180 个残基,而其他 RT 通常只有 50 个或更少。论文在所有能覆盖到催化位点的 93 个成员里都找到了 YxDD 催化基序(另有两个成员在它之前就被截断)。
② 一串等距的重复阵列:论文摘要用的原句是 an array of ~200-nucleotide units——以约 200 个核苷酸为一个单位。拆到细节:28 个带可检出阵列的位点中,阵列长度在 0.3 到 4.1 kb 之间,包含 3 到 21 份短重复,重复本身长 15 到 49 nt,带一个约 15 nt 的回文核心;重复之间是一段段彼此独特的间隔序列(spacer),在 28 个阵列中长 120 到 220 nt,在同一阵列内彼此不相关。在 agent 最早看到的那条 L0050 contig 上,间隔是 100 到 200 nt。论文对这套系统的命名就来自这段阵列——「We named this lineage of jumbo-phage RTs array-associated RTs (ART) after the array that defines it.」(我们按定义它的那段阵列,把这条巨型噬菌体 RT 谱系命名为 array-associated RTs,ART。)
③ 一个功能未知的伙伴基因(partner gene):位于 RT 紧邻下游。它不止一种,论文据此把 ART 分成三型:
| 类型 | 蛋白规模 | 结构特征 | 分布(95 个位点中) |
|---|---|---|---|
| Type I | 约 600 个氨基酸 | 两个串联的 GNAT 样折叠 | 59 个位点,Listeria 噬菌体与环境谱系 |
| Type II | 约 270 个氨基酸 | 全 α 螺旋蛋白 | 局限于 Staphylococcus 噬菌体分支 |
| Type III | 约 170 个氨基酸 | 较小的螺旋蛋白 | 一个环境亚谱系 |
三个伙伴家族在序列和预测结构上都找不到可检出的相似性——论文的解读是:ART 家族的 RT 不止一次跟彼此无关的伙伴配上了对。
最后一点特别关键:ART 位点附近找不到任何 cas 基因。也就是说,这套重复阵列不是 CRISPR,而是一类此前未被描述的非编码重复元件。
一份候选报告不等于一个家族。 从「agent 觉得这段东西有意思」到「这是一个成立的家族」,中间还隔着一道验证。团队接着用交互式的 Claude Science 会话处理了这个问题,看这段阵列和它的 RT 是否在 agent 看过的那些位点之外仍然自洽:
- 对自建元基因组数据库与公开基因组做 profile HMM 搜索,找到 95 个彼此不同的 RT 簇(按 90% 同一性划分),分布在已培养的巨型噬菌体和预测的病毒 contig 中;
- 其中 28 个在 RT 上游带有可检出的重复阵列;
- 系统发育分析把这批 RT 放在 retron 旁边的一个分支上——与 agent 最初的分类判断一致;
- 在这些位点里,阵列位于 RT 上游、伙伴基因位于 RT 紧邻下游,这两个特征是其他 RT 系统所没有的——而 agent 的报告里把它们都写到了。
还有一个很诚实的细节:最初把 agent 引向这里的那个「聚合酶旁边的 RT」,构成了 ART 的姐妹分支,论文把它称作 NART(non-array-associated RTs,非阵列关联 RT)。NART 的 RT 同样有很长的 N 端,但在它 17 个可评估的位点里,没有一个带重复阵列,也没有一个编码 ART 的伙伴蛋白。换句话说——把 agent 带过来的第一条线索本身是错的方向,真正的发现在它旁边。 这正是那 98 个「agent 自己开的后续任务」的价值所在。
它真的在工作吗:噬菌体感染实验给出的第一条证据
如果只有序列分析,这只是一个「看起来像那么回事」的假设。Anthropic 的团队往下走了一步:他们让一个 Claude Science 会话去找关于 ART 位点的更多信息,这个会话自主找到并取回了已发表的 Staphylococcus 噬菌体 SA1 感染时间序列 RNA 数据(BioProject PRJNA836150)。SA1 的基因组里正带着一套 ART 系统(261 kb 基因组、阵列含 5 份重复)。
结果:
- ART 重复阵列在感染的早期、中期、晚期(5 / 15 / 55 分钟)都被高水平表达;
- 感染后 15 分钟,阵列来源的 RNA 占到噬菌体 RNA 的 8%,属于最丰富的一批噬菌体转录本;
- 阵列转录本会裂解成更短的物种,且这些边界在不同重复实验之间是可复现的。
为了把这件事从「感染时的背景噪音」里摘出来,团队又在大肠杆菌里用质粒表达了 SA1 的 ART 系统(一个天然位点、一个异源启动子构建体),做了小 RNA 测序,同样观察到了与感染时相似的离散短 RNA。折叠预测显示,无论每个单元怎么从阵列里被切出来,重复序列都落在一个碱基配对的茎上——这与重复本身含一个短反向重复(回文)一致。
于是有了一个更清楚的假设:ART 是一个「retron 样」的系统,但它配的是一整套不同的 RNA,而 retron 只有一条。已知 retron 的工作方式是:RT 转录出一条专用 ncRNA,抄成单链 DNA,与效应蛋白形成一个失活的复合物,直到噬菌体感染或 msDNA 受损才把它释放出来、杀死细胞。论文推测 ART 可能按类似原理工作——每个单元 RNA 各自组装一个自己的复合物,于是一对酶与效应蛋白,可以产出若干个只有 RNA 不同的复合物,从而可能对不同触发条件作出反应。
需要立刻补一句边界:论文自己写明了「我们还没有证明这个 RT 是有活性的,也没有证明那些单元 RNA 就是它的底物」。 这是一条假设,不是一个结论。
Anthropic 自己做的两场「考试」:10 次重跑与 3,500 次尝试
这部分是这篇预印本最应该被传播、却最容易被忽略的内容——官方自己给出了不利于自己的证据。
第一场考试:可复现性。 他们把同一场战役又跑了 10 次。
- 几乎每一场完成普查的战役都采样到了 ART 位点(说明数据层面是可及的);
- 其中 2 场把这条谱系作为后续任务深入调查了;
- 但没有任何一场把 RT 上游的 DNA 读进上下文,阵列在每一次重跑里都被错过。
论文把原因归于两点:RT 的蛋白搜索空间很宽,以及 harness 的行为本身是非确定性的。
第二场考试:固定输入基准。 他们干脆把 ART 的序列直接喂给模型,看它能不能描述出来。做法是 5 个信息等级(序列直接放在上下文里、不给工具 / 序列作为文件、给工具,逐级加预测结构、文献与网页访问),7 个 Claude 模型,每个模型每个等级跑 100 次,共 3,500 次尝试,由一个语言模型裁判(Mythos 5)按 10 条人工整理的 ART 特征打分。
结果分两层。第一层是模型代际差异:四个最强模型(Opus 5.5、Mythos 5.1、Mythos 5、Opus 5)明显领先于另外三个(Opus 4.6、Opus 4.8、Sonnet 5)——跑原始战役用的正是 Mythos 5。
第二层更反直觉:工具越多,不一定越好。
| 条件 | 重复阵列被正确识别 |
|---|---|
| 序列直接放进上下文、不给工具(最强模型) | ≥ 90% 的尝试 |
| 序列作为文件 + 工具(Opus 5,第 4 级) | 低至 32% |
| 上下文中读进 ≥ 200 nt 连续 DNA | 各模型识别率提升 16–32 个百分点 |
| 上下文中 DNA 从 < 200 nt 增至 ≥ 2,000 nt(四模型合并) | 29% → 76% |
| 同上,Mythos 5 单独看 | 最高 96% |
他们把原因查到了头上:带工具时,39% 的尝试从来没有读过一段 200 nt 以上的连续序列,因此从来没有看到过一个以上的重复单元。 换句话说——给 agent 一套强大的分析工具,反而可能让它不去「直接看数据」。而这个系统的定义性特征,恰恰只有「直接看」才看得见。
这次不是「模型记住了」:Mythos 5 内部的重复序列信号
「模型是不是从训练数据里背出来的」是这类新闻最该被追问的问题。预印本给了一个技术性回答,分两步。
第一步,请两个对照。 他们把两个专门在生物序列上训练的基因组语言模型 Evo 2 和 gLM2 跑在同一个 L0050 位点上。这两个模型的 log-likelihood 曲线稳定地、高置信度地标出了重复序列;把每份重复的核苷酸原地打乱,这个信号就消失了。
第二步,往回读 Claude 自己的内部活动。 他们把最初那次发现会话的记录(task t0062)原样重放回同一个 Mythos 5 checkpoint,把模型某一层的活动分解成可解释的「信号」,再让这些信号沿着 DNA 逐位对齐。结论是:
- 有 12 个 Mythos 5 内部信号是在合成重复序列上被预先筛出来的(在观察 L0050 之前,避免事后挑选);
- 其中两个(论文称作 repeat-signal 1 与 repeat-signal 2)在读取该阵列时做出了与专训生物模型类似的反应:在阵列之前沉默,随后在第三份重复处起峰;
- 把 14 份重复逐份原地打乱,repeat-signal 1 有 12 份沉默、repeat-signal 2 则 14 份全部沉默。
论文的口径很克制:这两个信号并不专门针对 DNA(也就是说,它们不是一组「DNA 检测器」,而是更泛的重复模式信号)。预印本摘要对这件事的官方表述是 a behavior attributable to specific Mythos 5 internal signals that respond to repeated DNA——「这一行为可归因于 Mythos 5 内部对重复 DNA 有响应的特定信号」;也就是说,Anthropic 把这次发现的能力来源,明确归到「模型内部存在对重复 DNA 起反应的信号」这条具体机制上,而不是笼统地说「模型很聪明」。但它支持一个具体的解释链:重复序列在模型内部触发了信号 → 紧接着模型用自然语言把它命名为一个串联重复阵列 → 这个命名开启了 ART 的识别。 论文给这个能力起了个名字,叫「genomic vision(基因组视觉)」。
这和限制酶、Taq、CRISPR 是同一类故事吗
官方公告的开头,特意花了三段讲生物学史上的三个先例。这不是修辞,是在给这次成果定坐标:
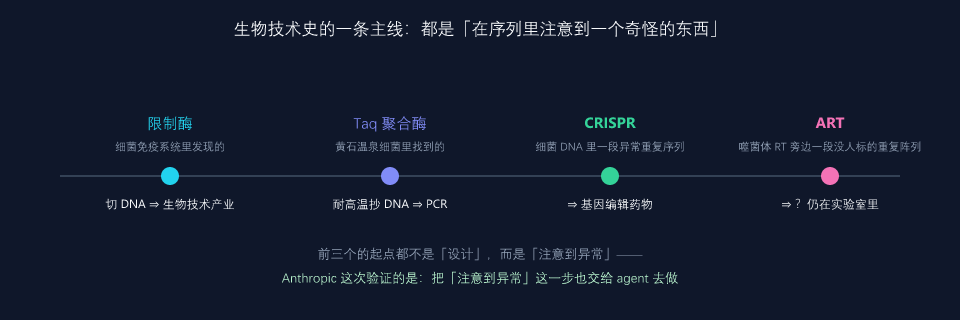
- 限制酶:在细菌免疫系统里被发现,作用本来是摧毁入侵病毒的 DNA;研究者意识到可以用它在选定的位置切 DNA、把基因从一个生物接到另一个生物——生物技术产业由此起步;
- Taq 聚合酶:在黄石温泉的一种细菌里被找到,能在高温下复制 DNA——成了 PCR 的基础;
- CRISPR:最初只是被注意到「某些细菌的 DNA 里有一段不寻常的重复序列」——如今是基因编辑药物的地基。
三条线的共同起点都不是「设计」,而是**「在序列里注意到一个奇怪的东西」**。Anthropic 想验证的命题就是:能不能把「注意到异常」这一步,也交给 agent 去做。
这正是论文在讨论部分最实在的一段论述:异常是相对于「预期」才存在的。 对统计学家,预期是一个显式的数据模型;对生物学家,预期往往来自上下文与默会的经验知识。此前自动化科学发现的尝试,预期与「什么算新」的判断都由人类专家提供;近期的 AI 方法能让 agent 自己筛掉不新颖的假设,但设定预期、下最后判断的仍然是人。论文主张:这一次,agent 同时提供了预期(来自它自己的知识,而不是来自任务)与「这个异常值得追」的判断。
论文还举了一个很具体的佐证:MarsHill 位点。这个位点原本的基因组报告已经识别出了那个 RT,并提出了一个 5′ ncRNA 的可能,但既没有描述重复阵列,也没有描述伙伴基因。差别就在「有没有人真的去把那段序列看进去」。
而 CRISPR 先驱 Feng Zhang 的点评,说的也正是这一层(引自官方公告):
This is an exciting example of how AI agents can contribute to biological discovery. The identification of RNA-repeat arrays associated with reverse transcriptases is genuinely intriguing and merits further investigation. I hope this work encourages more scientists to explore how AI can support their research.
「这是 AI agent 能如何为生物学发现做出贡献的一个激动人心的例子。识别出与逆转录酶相关的 RNA 重复阵列确实很有意思,值得进一步研究。我希望这项工作能鼓励更多科学家去探索 AI 如何支持他们的研究。」
注意这位最重要的外部点评人用的词:「promising」「intriguing」「merits further investigation」——是「值得进一步研究」,而不是「已经证明了什么」。
风险与局限
① 这是预印本,未经同行评审。 论文通过 Anthropic 的 CDN 发布,官方公告用的是「pre-print」与「technical report」。TechCrunch 的表述很准确:「这个发现到底有多大、到底有多新,要由更广泛的研究界来验证。」 在同行评审完成之前,所有结论都应被当作待检的主张。
② agent 的自评报告不是实验验证。 这是最需要拆开的一层。那 19 份报告的「质量」是由一个语言模型裁判按 10 条人工设定的特征打分的;报告的排序是一场 342 局的成对比较锦标赛(每对报告比较一次,裁判为 Mythos 5,按影响力 0.35 / 新颖性 0.30 / 严谨性 0.25 / 可操作性 0.10 加权)。这套机制衡量的是「报告是否符合研究者预设的 ART 特征」,不是「生物学结论是否成立」。 校准用的 10 条特征本身就是作者定的——这是合理的工程做法,但它意味着这个分数的上限就是预设答案的边界。
③ Claude 被淘汰的候选占大多数。 数字必须完整地讲:17 个候选伙伴家族里,只有 3 个被确认为此前未报道的 RT 关联,其余 14 个被 rejected 或 set aside(注释假象、已描述系统的零件,或只是「邻居」而非专门伙伴)。也就是说,agent 这一轮提出的假说里,绝大多数是错的——论文对此毫不回避,甚至把这当成一个可以研究的对象:官方公告明确说「在后续分析中,Claude 会批判性地评估证据——通常正是在这个阶段,大多数候选会被淘汰」,还提到他们正在反向研究「什么样的报告值得测、什么样的不该测」,把这些经验写回给 Claude 的指令里,教它模仿人类科学家的品味。这既是加分项,也是提醒:这套系统真正的价值可能在于「以极低成本生成并自我淘汰大量假设」,而不是「一次就猜对」。
④ AI 产出的科学结论仍需湿实验复核,而且这次的湿实验全部由人完成。 论文写得很清楚:「除了这些观察之外,我们还没有证明这个 RT 是活性的,也没有证明那些单元 RNA 是它的底物。RT 与它的伙伴是否相互作用、这套系统对噬菌体有什么作用,目前都还是未知的。」 而 TechCrunch 把另一个事实放在了聚光灯下——所有实验室工作都是人类科学家做的,Anthropic 并没有「把 Claude 放出去」操作实验室。 公告的原文是:「我们的实验室位于湾区,看起来就是一个常规的分子生物学实验室。我们只做生物安全风险等级最低的两级(BSL-1 和 BSL-2),不处理能感染人类的病原体。所有实验室工作都由人类科学家完成。」Dario Amodei 也留了话口:「最终也许可以让 Claude 自己去安全地做实验、自主控制实验设备,只要防护措施到位——但今天我们没有这么做。」
⑤ 还有个容易被当成「AI 原创」的归因问题。 TechCrunch 明确写道:Amodei 承认这项发现建立在他人先前工作之上,并且斯坦福的一个团队此前发现过一个「在某些方面与 Claude 找到的这个相似」的系统。预印本也提到,另一套不相关的 UG27 RT 附近曾用专用的基因组语言模型找到过 RNA 阵列,说明这个架构在自然界中出现过不止一次。再加上我们已经强调过的那句关键限定——底层那个 jumbo phage RT 本身此前就被识别过——正确的表述是「Claude 第一次注意到这套系统的定义性特征」,而不是「Claude 从零发现了一个前所未有的酶」。
⑥ 可复现性的硬伤不能只当成花絮。 同一场战役重跑 10 次,这个阵列一次都没被读出来。 论文对此诚实,但结论也很硬:这套发现的产出强烈依赖 harness 配置、模型的代际能力,以及运气。 「能用」与「能稳定地用」之间还有距离——这恰恰是固定输入基准(≥90% 对 32%)想说清楚的事:把数据直接读进上下文,比给它一整套工具更可靠。
小结
- 这份工作的官方定性:Anthropic 生命科学研究组 + 湾区湿实验室(只做 BSL-1/BSL-2、不碰能感染人的病原体、所有实验由人类科学家完成)的早期成果;
- 战役规模(预印本精确值):19.4 亿(1.94 B)蛋白簇、52 个自建 RT profile HMM、198,290 条 RT 簇归入 9 类、3,564 个候选伙伴家族、119 个任务 / 949 个 agent 会话 / 77 agent-小时 / 215.6 百万 token / 21.5 小时墙钟,全程无人工干预(官方公告的近似写法为「约 950 个 agent、2.1 亿 token、约 21 小时」);
- 产出:19 份报告 = 3 个此前未报道的 RT 关联 + 3 个新 RT 谱系;17 个候选里 14 个被淘汰;
- ART 的定义:一类新的巨型噬菌体 RT 家族,特征是 RT 上游一段约 200 个核苷酸为单位的串联重复阵列(ncDNA,不是 CRISPR,附近无 cas 基因)+ 一个功能未知的伙伴基因;底层 RT 此前已被识别,Claude 的贡献是第一个注意到这套系统;
- 第一条实验证据:SA1 噬菌体感染 15 分钟时,阵列来源 RNA 占噬菌体 RNA 的 8%;在大肠杆菌里异源表达也复现出离散短 RNA——但活性与底物关系均未被证明;
- 最该记住的两个数字:可复现性重跑 10 次,阵列全部被错过;固定输入基准里,上下文直接给序列的正确率 ≥90%,加工具反而低至 32%;
- 一句话:这次真正的新东西不是「发现了一个酶」,而是「一个通用模型通过直接读原始 DNA,在没有人盯着的情况下,第一次注意到了别人从旁边走过却没看见的东西」——而 Anthropic 最有价值的动作,是把这句话连同反证一起写进了同一份文件里。
数据来源:Anthropic 官方公告(2026-09-23)· 官方预印本 PDF(Yoon et al., Anthropic,40 页)· TechCrunch(2026-09-23) 配图说明:实验室照片为配图素材;预印本首页为官方 PDF 首页渲染;三张示意图(工作流漏斗、ART 结构、发现史主线)为本文自绘,数据均来自上述一手来源。 统计时间:2026-09-26